
The post has been translated automatically. Original language: Russian



Annotation. In this article, we look at the concept of the "dark factory," a development mode in which AI agents write, test, and validate code without human intervention. We tested it on our own pet project: we implemented an access control system with facial recognition in this mode. The agents completed the tasks and got a workable result, but the amount of generated code did not allow us to check it manually. The analysis using the concept of harness showed that the code quality check in our circuit worked, but the system behavior check did not. Based on the experiment and published criticism, we came to the conclusion that the approach is not yet applicable for enterprise development, and identified its elements that can be used today.
1. Setting the task
The term came from industry: a "dark" factory is a factory in which production is fully automated and lighting is not required in the workshops. In 2026, it was moved to software development: this was the name given to the process in which a person formulates a task, and agents go all the way from code to merging into the main branch.
We are interested in this idea for an understandable reason. If agents are able not only to write code, but also to verify it, the bottleneck of the team is no longer the implementation, but the task statement. We wanted to answer a practical question: under what conditions it is possible to refuse to check the code by a human and whether it is possible to do this in systems with a high cost of error.
2. Levels of autonomy
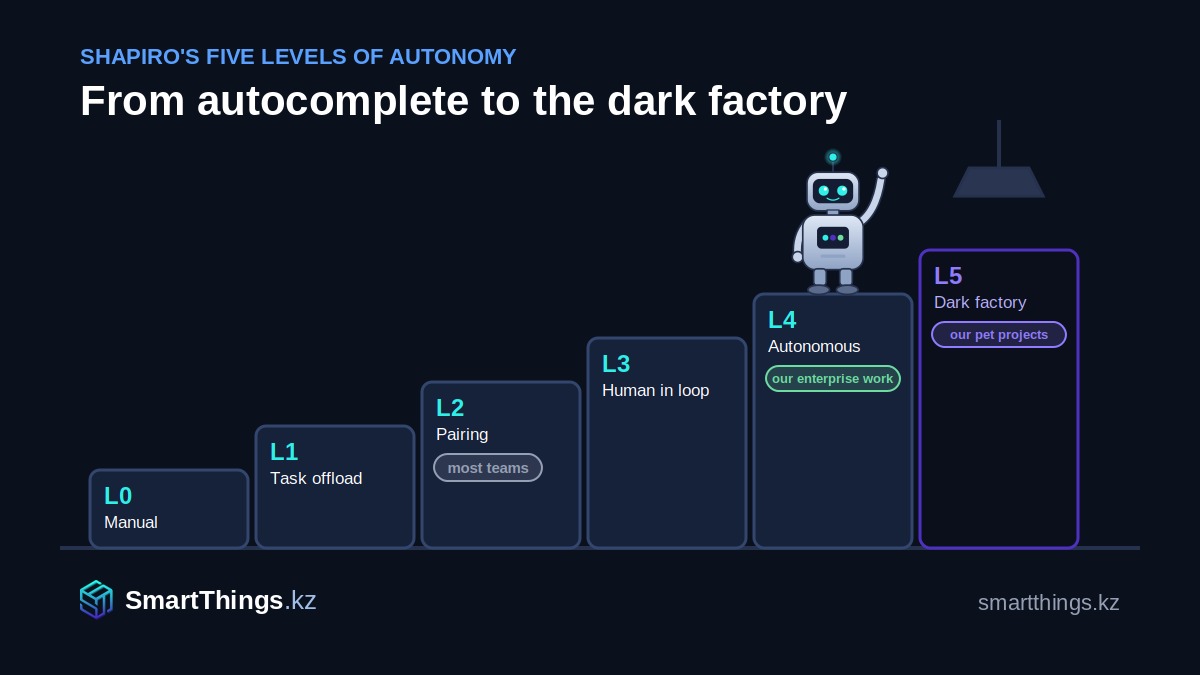
To understand what is at stake, we use the D. Shapiro scale — six levels of AI development autonomy, from zero to fifth.
| Level | Title | The human role |
| 0 | Manual development | writes all the code |
| 1 | Delegating tasks | assigns individual tasks to the agent: tests, documentation |
| 2 | Pair work | works with the agent as with a colleague |
| 3 | The man in the contour | reviews the changes proposed by the agent |
| 4 | Offline development | writes specifications and checks plans |
| 5 | The Dark Factory | formulates the task; the specification turns into a product without his participation |
Shapiro estimates that about 90% of developers who actively use AI are at the second level. Our workflow in enterprise projects is closest to the fourth one: an engineer prepares the specification and an agent implements it. At the same time, we maintain the mandatory human review of the code, which is typical for the third level. We conducted the experiment in question on the fifth.
3. The dark Factory in practice
Before starting the experiment, we studied the most detailed example described — the internal team of StrongDM, which S. Willison wrote about. A team of three engineers works according to two rules: the code is not written by people and the code is not checked by people. The budget for model calls is at least $1,000 per day per engineer.
Their correctness is ensured by three mechanisms:
- scenarios like deferred sampling (holdout set): end-to-end user scripts are stored outside the codebase, and the agent writing the code does not have access to them.;
- The satisfaction metric, instead of a binary test result, is the percentage of scenarios that are highly likely to satisfy the user.;
- The digital counterparts of external services are agent—created behavioral copies of Okta, Jira, Slack, and other systems that allow you to run thousands of scripts without the limitations of external APIs.
Willison himself leaves open the main question that interested us as well: on what basis can you trust a code that no one has read, especially in security-related tasks.
4. Harness: everything except the model
The StrongDM example shows that the reliability of the dark factory is provided not by the model itself, but by the environment around it. In 2026, the term "harness" was adopted for this environment. B. Beckler (Thoughtworks) defines it as everything in an AI agent except the model itself: specifications, rules, tools, tests, validating agents, and the execution environment.
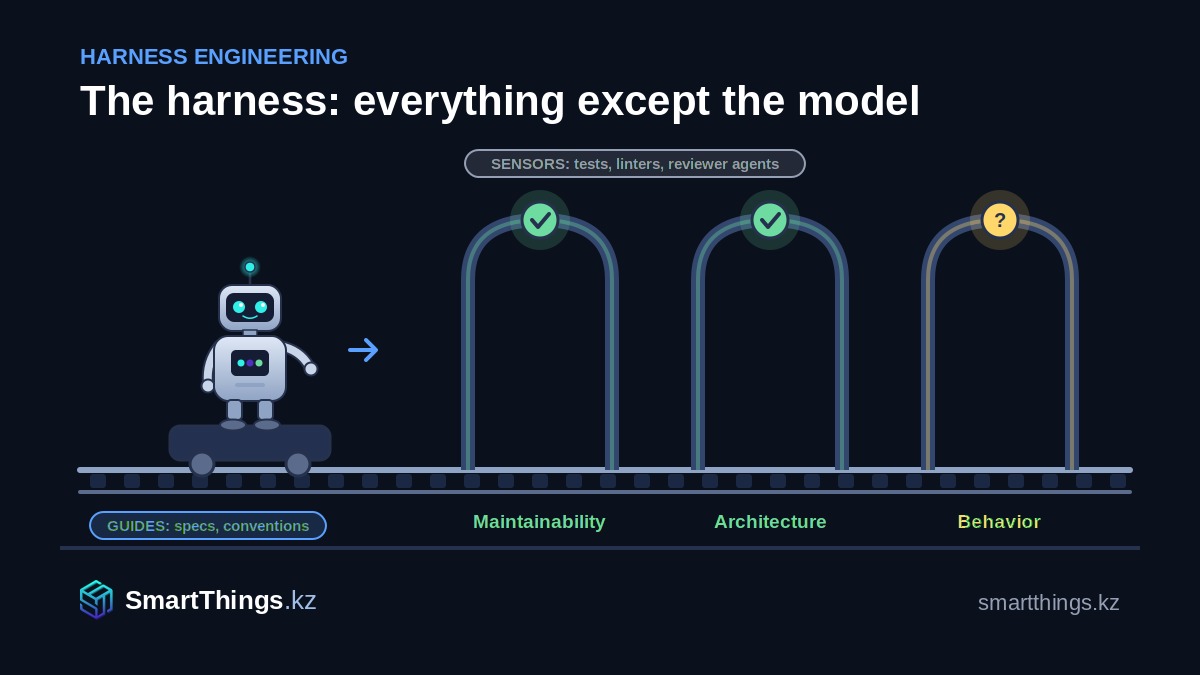
The elements of harness are divided into two classes:
- guides act before code generation and specify what and how the agent should do: specifications, architectural conventions, instructions;
- sensors act after and report what happened: tests, linters, static analysis, review agents.
Sensors, in turn, can be computational (deterministic tests and linters) and based on model inference (agent-reviewer, agent-tester). The former are cheap and reliable, but test only what can be formalized; the latter cover more, but inherit model errors.
Beckler identifies three areas that harness regulates: maintainability of the code, compliance with the architecture, and system behavior. Today, the tools are best developed for the first, and the worst for the third. She formulates the key limitation as follows: correctness is beyond the competence of any sensor if a person has not clearly described what he wants.
The largest published example is the OpenAI experiment: a team of seven engineers received about a million lines of code in five months, without manually writing a single one, and merged about 1,500 changes. ""The main conclusion of the team is that when an agent fails, you should not ask "how to make the model work better," but "what opportunity is missing in the environment." People manage, agents execute.
This leads to a thesis that is important for the entire article: the dark factory is primarily the task of building a harness, not choosing a model. The level of autonomy that a team can afford is determined by how fully the harness covers all three areas, and above all behavior.
5. Our experiment
5.1. Setting up
For the experiment, we chose an access control system: a facial recognition terminal, a log of entrances and exits, time tracking, uploading photos of employees, and managing the structure of departments. This is a medium-complexity project that we implemented as a pet project.
We prepared the specifications in DevSpecAI, our tool for preparing accurate specifications. The implementation was carried out using Dark Factory, an open console tool that takes tasks from the repository and runs each through three stages: implementation by an agent in an isolated container, code quality control by a second agent, and script compliance by a third. A change that has not been verified is returned for revision; if it has passed, it is automatically merged into the main branch.
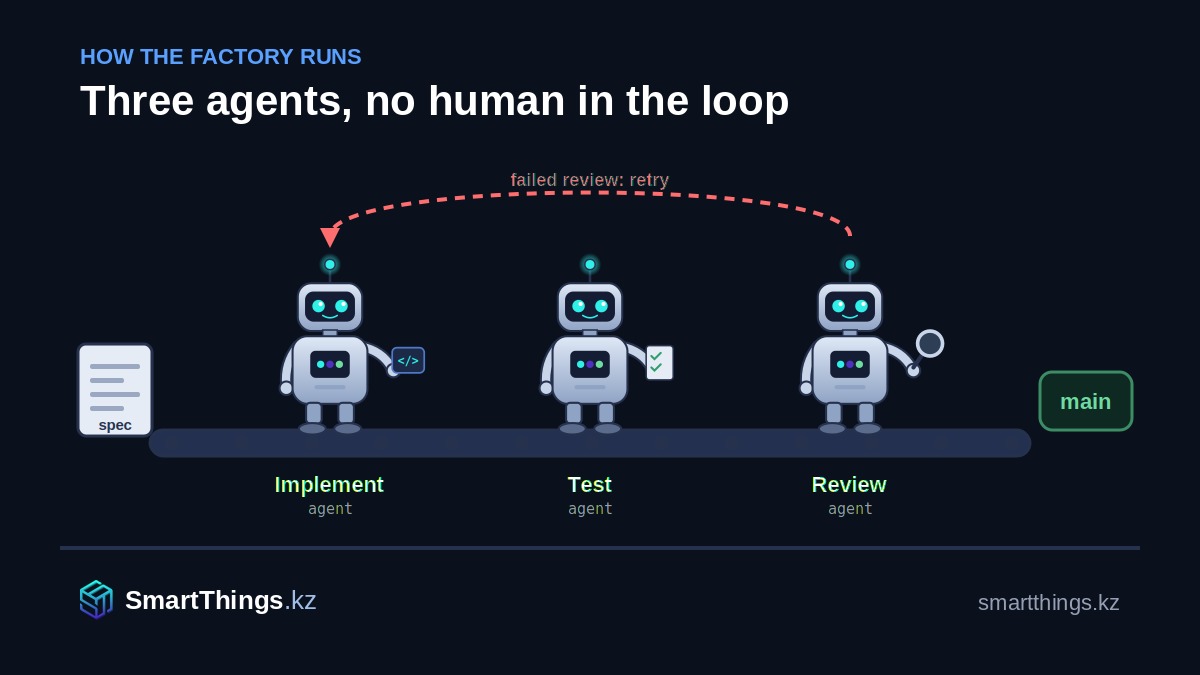
We have assembled the verification outline from autotests, a tester agent, a review agent, CI/CD pipelines, and checking the result for compliance with the specification. The person did not participate in this circuit. In terms of section 4, our harness looked like this:
| The harness element | What we used |
| Guides | DevSpecAI Specifications |
| Computational sensors | autotests, CI/CD pipelines |
| Sensors based on the model | agent tester, agent reviewer, checking for compliance with the specification |
5.2. Results
The result was mixed.
What happened. The code as a whole was of high quality, the tasks were completed, and the final behavior of the system corresponded to what we expected from it. For a pet project, this is a usable result.
What didn't work out. The agents generated so much code that we could hardly verify it completely. Hence, there are two risks that cannot be eliminated within the framework of the approach: unnoticed vulnerabilities, including potentially exploited ones, and misunderstood requirements that formally pass all automatic checks.
If we decompose the result into areas of harness, the picture becomes clearer. The maintainability harness worked: the code as a whole was of high quality. The harnessing of behavior turned out to be insufficient: our sensors could not confirm that the system was doing exactly what was needed and was not doing anything unnecessary, and the checking agents themselves worked on the same specification as the contractor.
How much it cost. We did not keep accurate records of tokens. One medium-complexity project took the full monthly limit of Claude's $200 subscription. This is significantly less than StrongDM's budget, but the scale of the task is not comparable.
The subject area is important for our conclusions. The facial recognition system works with biometric data, one of the most sensitive categories of personal data. Even on a training project, the agents wrote working code for her., which none of us can fully read. We consider this unacceptable in the customer's industrial operation.
6. Risks
Our observations coincided with the Stanford CodeX analysis published in response to the description of the StrongDM approach. We identify four risk groups.
Responsibility. The existing legal and contractual mechanisms assume that someone has checked the work. If no one has read the code, it is unclear who is responsible for the failure.: the engineers who designed the process, the supplier of the model, or the supplier of the product.
Substitution of the goal. The agent who has been assigned the goal of passing the checks passes the checks, and does not ensure operability. This is a special case of Goodhart's law: a measure that has become a goal ceases to be a measure.
Common blind spots. If the code writes and verifies the same class of models, their systematic errors match. By adding another verification agent, we will not eliminate the error that none of them sees.
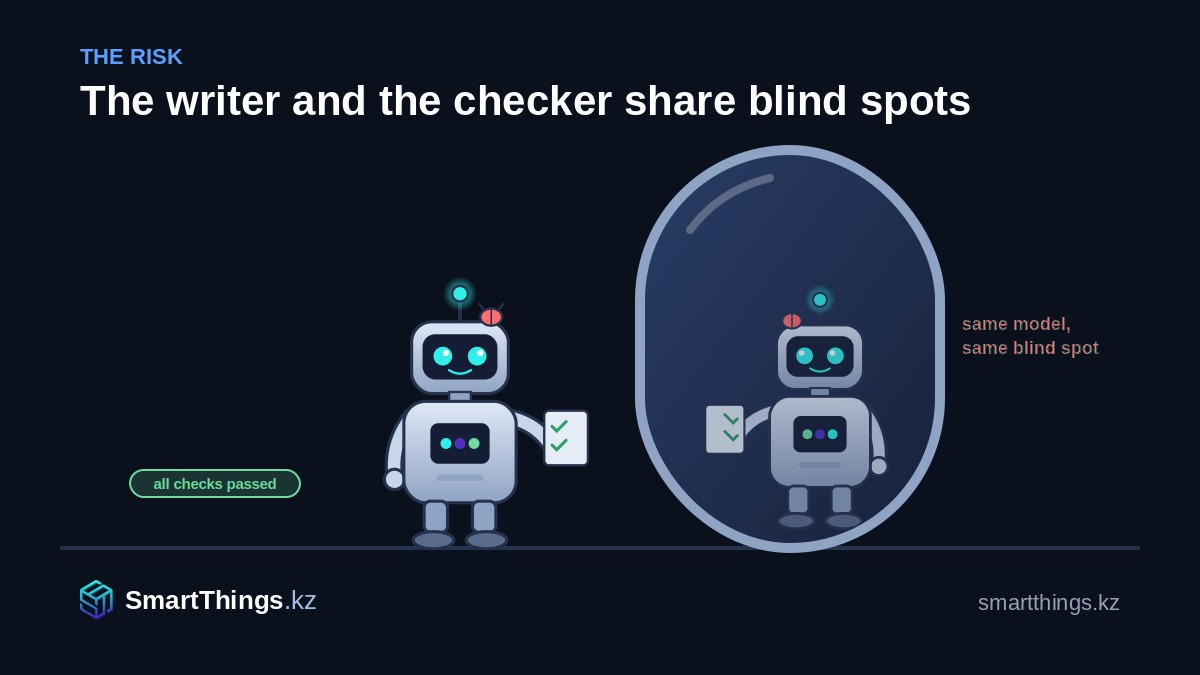
Lack of standards and loss of knowledge. There are no disclosure and auditing standards yet for software created by agents without human involvement. At the same time, the team is losing knowledge of the codebase: engineers who don't read the code gradually stop understanding it.
7. Where do we draw the line
For pet projects and internal tools with a low cost of error, the dark factory already provides a workable result. We do not apply this approach to enterprise systems, such as banking systems that work with personal or biometric data that is subject to audit. It's not about the quality of the code, but about the fact that it can't be verified, and the uncertainty of responsibility.
| Parameter | Pet project | Enterprise system |
| The price of error | low | high: financial, regulatory, reputational |
| Responsibility | on the author | It must be determined by the contract and the regulator. |
| Audit requirements | missing | required |
| Human review of the code | preferably | necessarily |
At the same time, in our opinion, some of the elements of the dark factory can be transferred to the fourth-level process without abandoning the review.:
- acceptance scenarios hidden from the implementing agent - protection against fitting the implementation to the tests;
- The review agent is like the first filter before a person's review, not instead of it;
- isolated execution environment for agents;
- risk-based merger policy: automatic merging is acceptable only for changes with a deliberately low cost of error;
- Run analysis: The number of repeats and typical reasons for failures indicate gaps in the specifications.
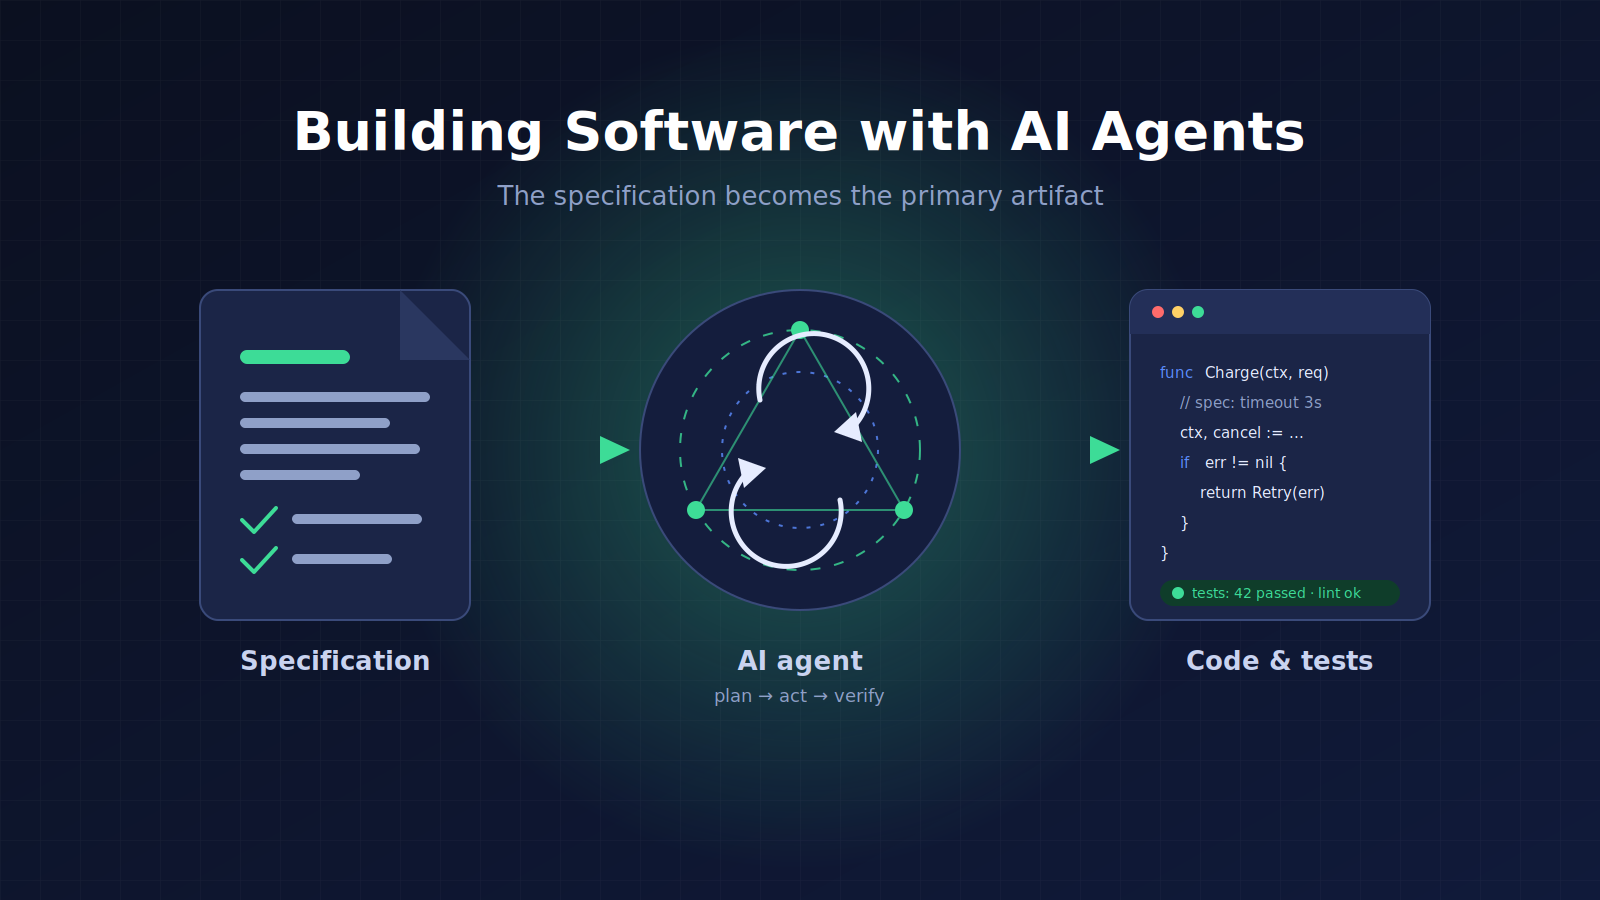
The common denominator of the fourth and fifth levels is the specification. The dark factory does not cancel the engineer's work, but transfers it entirely into the task statement and the verification criteria. If a team has not learned how to write precise specifications at the fourth level, it will not get reliable results at the fifth.
8. Conclusions
- The dark Factory is a workable development mode: in our experiment, the agents completed the tasks of a project of medium complexity, and we were satisfied with the result.
- The main limitation that we saw was not the quality of the code, but its volume, which precludes human verification, and the associated risks of vulnerabilities and misunderstood requirements.
- We do not use this approach today for enterprise systems, especially those working with personal and biometric data. For us, the boundary runs along the review of the code by a person.
- The dark factory is Harness's job, not the model's. In our experiment, the maintainability harness worked, but the behavior harness did not, and it is the behavior that determines the cost of an error in enterprise.
- Hidden acceptance scenarios, a review agent as a pre-filter, and an isolated execution environment can be used right now, while maintaining human control.
- At any level of autonomy, the result determines the quality of the specification.: this is the main harness guide, and no sensor compensates for its inaccuracy.
We will continue the experiments and will be happy to compare the results with teams that have also tried this approach.
SmartThings is an engineering company from Astana, resident of Astana Hub since March 2026. We work with product teams in the EU, UK and USA.
Аннотация. В этой статье мы рассматриваем концепцию «тёмной фабрики» (dark factory) — режима разработки, в котором AI-агенты пишут, тестируют и проверяют код без участия человека. Мы проверили её на собственном pet-проекте: реализовали в таком режиме систему контроля доступа с распознаванием лиц. Агенты выполнили задачи и получили работоспособный результат, однако объём сгенерированного кода не позволил нам проверить его вручную. Анализ через понятие харнесса показал, что проверка качества кода в нашем контуре сработала, а проверка поведения системы — нет. На основании эксперимента и опубликованной критики мы пришли к выводу, что для enterprise-разработки подход пока не применим, и выделили его элементы, которые можно использовать уже сегодня.
1. Постановка задачи
Термин пришёл из промышленности: «тёмной» называют фабрику, на которой производство полностью автоматизировано и освещение в цехах не требуется. В 2026 году его перенесли в разработку ПО: так стали называть процесс, в котором человек формулирует задачу, а весь путь от кода до слияния в основную ветку проходят агенты.
Нам эта идея интересна по понятной причине. Если агенты способны не только писать код, но и проверять его, узким местом команды становится уже не реализация, а постановка задачи. Мы хотели ответить на практический вопрос: при каких условиях можно отказаться от проверки кода человеком и можно ли это делать в системах с высокой ценой ошибки.
2. Уровни автономности
Чтобы понимать, о чём идёт речь, мы используем шкалу Д. Шапиро — шесть уровней автономности AI-разработки, от нулевого до пятого.
| Уровень | Название | Роль человека |
| 0 | Ручная разработка | пишет весь код |
| 1 | Делегирование задач | поручает агенту отдельные задачи: тесты, документацию |
| 2 | Парная работа | работает с агентом как с коллегой |
| 3 | Человек в контуре | ревьюирует изменения, предложенные агентом |
| 4 | Автономная разработка | пишет спецификации и проверяет планы |
| 5 | Тёмная фабрика | формулирует задачу; спецификация превращается в продукт без его участия |
По оценке Шапиро, около 90% разработчиков, активно использующих AI, находятся на втором уровне. Наш рабочий процесс в enterprise-проектах ближе всего к четвёртому: спецификацию готовит инженер, реализует её агент. При этом мы сохраняем обязательное ревью кода человеком, характерное для третьего уровня. Эксперимент, о котором пойдёт речь, мы провели на пятом.
3. Тёмная фабрика на практике
Прежде чем начинать эксперимент, мы изучили наиболее подробно описанный пример — внутреннюю команду компании StrongDM, о которой писал С. Уиллисон. Команда из трёх инженеров работает по двум правилам: код не пишут люди и код не проверяют люди. Бюджет на вызовы моделей — не менее 1 000 долларов в день на инженера.
Корректность у них обеспечивается тремя механизмами:
- сценарии как отложенная выборка (holdout set): сквозные пользовательские сценарии хранятся вне кодовой базы, и агент, пишущий код, не имеет к ним доступа;
- метрика удовлетворённости вместо бинарного результата теста — доля прохождений сценариев, которые с высокой вероятностью удовлетворили бы пользователя;
- цифровые двойники внешних сервисов — созданные агентами поведенческие копии Okta, Jira, Slack и других систем, позволяющие прогонять тысячи сценариев без ограничений внешних API.
Сам Уиллисон оставляет открытым главный вопрос, который интересовал и нас: на каком основании можно доверять коду, который не читал ни один человек, особенно в задачах, связанных с безопасностью.
4. Харнесс: всё, кроме модели
Пример StrongDM показывает, что надёжность тёмной фабрики обеспечивает не сама модель, а окружение вокруг неё. Для этого окружения в 2026 году закрепился термин харнесс (harness, буквально «упряжь»). Б. Бёклер (Thoughtworks) определяет его как всё в AI-агенте, кроме самой модели: спецификации, правила, инструменты, тесты, проверяющие агенты и среду исполнения.
Элементы харнесса делятся на два класса:
- направляющие (guides) действуют до генерации кода и задают, что и как агент должен сделать: спецификации, архитектурные соглашения, инструкции;
- датчики (sensors) действуют после и сообщают, что получилось: тесты, линтеры, статический анализ, агенты-ревьюеры.
Датчики, в свою очередь, бывают вычислительными (детерминированные тесты и линтеры) и основанными на выводе модели (агент-ревьюер, агент-тестировщик). Первые дёшевы и надёжны, но проверяют только то, что можно формализовать; вторые покрывают больше, но наследуют ошибки моделей.
Бёклер выделяет три области, которые регулирует харнесс: сопровождаемость кода, соответствие архитектуре и поведение системы. Лучше всего сегодня развиты инструменты для первой, хуже всего — для третьей. Ключевое ограничение она формулирует так: корректность находится вне компетенции любого датчика, если человек не описал ясно, чего он хочет.
Самый масштабный из опубликованных примеров — эксперимент OpenAI: команда из семи инженеров за пять месяцев получила около миллиона строк кода, не написав вручную ни одной, и слила около 1 500 изменений. Главный вывод команды — при сбое агента нужно спрашивать не «как заставить модель работать лучше», а «какой возможности не хватает в окружении». Люди управляют, агенты исполняют.
Отсюда следует тезис, важный для всей статьи: тёмная фабрика — это прежде всего задача построения харнесса, а не выбора модели. Уровень автономности, который может себе позволить команда, определяется тем, насколько полно харнесс покрывает все три области, и прежде всего поведение.
5. Наш эксперимент
5.1. Постановка
Для эксперимента мы выбрали систему контроля доступа: терминал распознавания лиц, журнал входов и выходов, учёт рабочего времени, загрузку фотографий сотрудников и управление структурой отделов. Это проект средней сложности, который мы реализовали как pet-проект.
Спецификации мы готовили в DevSpecAI — нашем инструменте для подготовки точных спецификаций. Реализацию вели с помощью Dark Factory — открытого консольного инструмента, который берёт задачи из репозитория и проводит каждую через три стадии: реализация агентом в изолированном контейнере, проверка качества кода вторым агентом и проверка соответствия сценариям третьим. Изменение, не прошедшее проверку, возвращается на доработку; прошедшее — автоматически сливается в основную ветку.
Контур проверки мы собрали из автотестов, агента-тестировщика, агента-ревьюера, конвейеров CI/CD и проверки результата на соответствие спецификации. Человек в этом контуре не участвовал. В терминах раздела 4 наш харнесс выглядел так:
| Элемент харнесса | Что мы использовали |
| Направляющие | спецификации DevSpecAI |
| Вычислительные датчики | автотесты, конвейеры CI/CD |
| Датчики на основе модели | агент-тестировщик, агент-ревьюер, проверка на соответствие спецификации |
5.2. Результаты
Результат оказался неоднозначным.
Что получилось. Код в целом был качественным, задачи выполнялись, итоговое поведение системы соответствовало тому, что мы от неё ожидали. Для pet-проекта это пригодный к использованию результат.
Что не получилось. Агенты сгенерировали столько кода, что проверить его полностью мы практически не могли. Отсюда два риска, которые в рамках подхода не устраняются: незамеченные уязвимости, в том числе потенциально эксплуатируемые, и неверно понятые требования, которые формально проходят все автоматические проверки.
Если разложить результат по областям харнесса, картина становится понятнее. Харнесс сопровождаемости сработал: код в целом был качественным. Харнесс поведения оказался недостаточным: подтвердить, что система делает именно то, что нужно, и не делает ничего лишнего, наши датчики не могли, а сами проверяющие агенты работали на той же спецификации, что и исполнитель.
Сколько это стоило. Точного учёта токенов мы не вели. На один проект средней сложности ушёл полный месячный лимит подписки Claude стоимостью 200 долларов. Это существенно меньше бюджета StrongDM, но и масштаб задачи несопоставим.
Для наших выводов важна предметная область. Система распознавания лиц работает с биометрическими данными — одной из наиболее чувствительных категорий персональных данных. Даже на учебном проекте агенты написали для неё работающий код, который никто из нас не может полностью прочитать. В промышленной эксплуатации у клиента мы считаем это неприемлемым.
6. Риски
Наши наблюдения совпали с анализом Stanford CodeX, опубликованным в ответ на описание подхода StrongDM. Мы выделяем четыре группы рисков.
Ответственность. Существующие правовые и договорные механизмы исходят из того, что работу кто-то проверил. Если код не читал ни один человек, непонятно, кто отвечает за сбой: инженеры, спроектировавшие процесс, поставщик модели или поставщик продукта.
Подмена цели. Агент, которому поставили цель пройти проверки, проходит именно проверки, а не обеспечивает работоспособность. Это частный случай закона Гудхарта: мера, ставшая целью, перестаёт быть мерой.
Общие слепые зоны. Если код пишет и проверяет один класс моделей, их систематические ошибки совпадают. Добавив ещё одного агента-проверяющего, мы не устраним ошибку, которую не видит ни один из них.
Отсутствие стандартов и потеря знаний. Для программного обеспечения, созданного агентами без участия человека, пока нет стандартов раскрытия и аудита. Одновременно команда теряет знание кодовой базы: инженеры, которые не читают код, постепенно перестают его понимать.
7. Где мы проводим границу
Для pet-проектов и внутренних инструментов с низкой ценой ошибки тёмная фабрика уже сегодня даёт работоспособный результат. Для enterprise-систем — банковских, работающих с персональными или биометрическими данными, подлежащих аудиту — мы подход не применяем. Дело не в качестве кода, а в том, что его невозможно проверить, и в неопределённости ответственности.
| Параметр | Pet-проект | Enterprise-система |
| Цена ошибки | низкая | высокая: финансовая, регуляторная, репутационная |
| Ответственность | на авторе | должна быть определена договором и регулятором |
| Требования аудита | отсутствуют | обязательны |
| Ревью кода человеком | желательно | обязательно |
Вместе с тем часть элементов тёмной фабрики, на наш взгляд, можно перенести в процесс четвёртого уровня, не отказываясь от ревью человеком:
- сценарии приёмки, скрытые от агента-исполнителя, — защита от подгонки реализации под тесты;
- агент-ревьюер как первый фильтр перед ревью человека, а не вместо него;
- изолированная среда исполнения для агентов;
- политика слияния по уровню риска: автоматическое слияние допустимо только для изменений с заведомо низкой ценой ошибки;
- аналитика прогонов: число повторов и типичные причины отказов указывают на пробелы в спецификациях.
Общий знаменатель четвёртого и пятого уровней — спецификация. Тёмная фабрика не отменяет работу инженера, а переносит её целиком в постановку задачи и в критерии проверки. Если команда не научилась писать точные спецификации на четвёртом уровне, на пятом она надёжного результата не получит.
8. Выводы
- Тёмная фабрика — работоспособный режим разработки: в нашем эксперименте агенты выполнили задачи проекта средней сложности, и результат нас устроил.
- Главное ограничение, которое мы увидели, — не качество кода, а его объём, исключающий проверку человеком, и связанные с этим риски уязвимостей и неверно понятых требований.
- Для enterprise-систем, особенно работающих с персональными и биометрическими данными, мы подход сегодня не используем. Для нас граница проходит по ревью кода человеком.
- Тёмная фабрика — задача харнесса, а не модели. В нашем эксперименте харнесс сопровождаемости сработал, а харнесс поведения — нет, и именно поведение определяет цену ошибки в enterprise.
- Скрытые сценарии приёмки, агент-ревьюер как предварительный фильтр и изолированная среда исполнения можно использовать уже сейчас, сохраняя контроль человека.
- На любом уровне автономности результат определяет качество спецификации: это главная направляющая харнесса, и никакой датчик не компенсирует её неточность.
Эксперименты мы продолжим и будем рады сравнить результаты с командами, которые тоже пробовали этот подход.
SmartThings — инженерная компания из Астаны, резидент Astana Hub с марта 2026 года. Работаем с продуктовыми командами в ЕС, Великобритании и США.
 Share