


The post has been translated automatically. Original language: Russian




In the early 2000s, I continued to read Joel on Software. By that time, Joel Spolsky had already worked at Microsoft, created Fog Creek Software, and became one of those authors who explained programming not only through languages and algorithms, but also through real engineering experience.
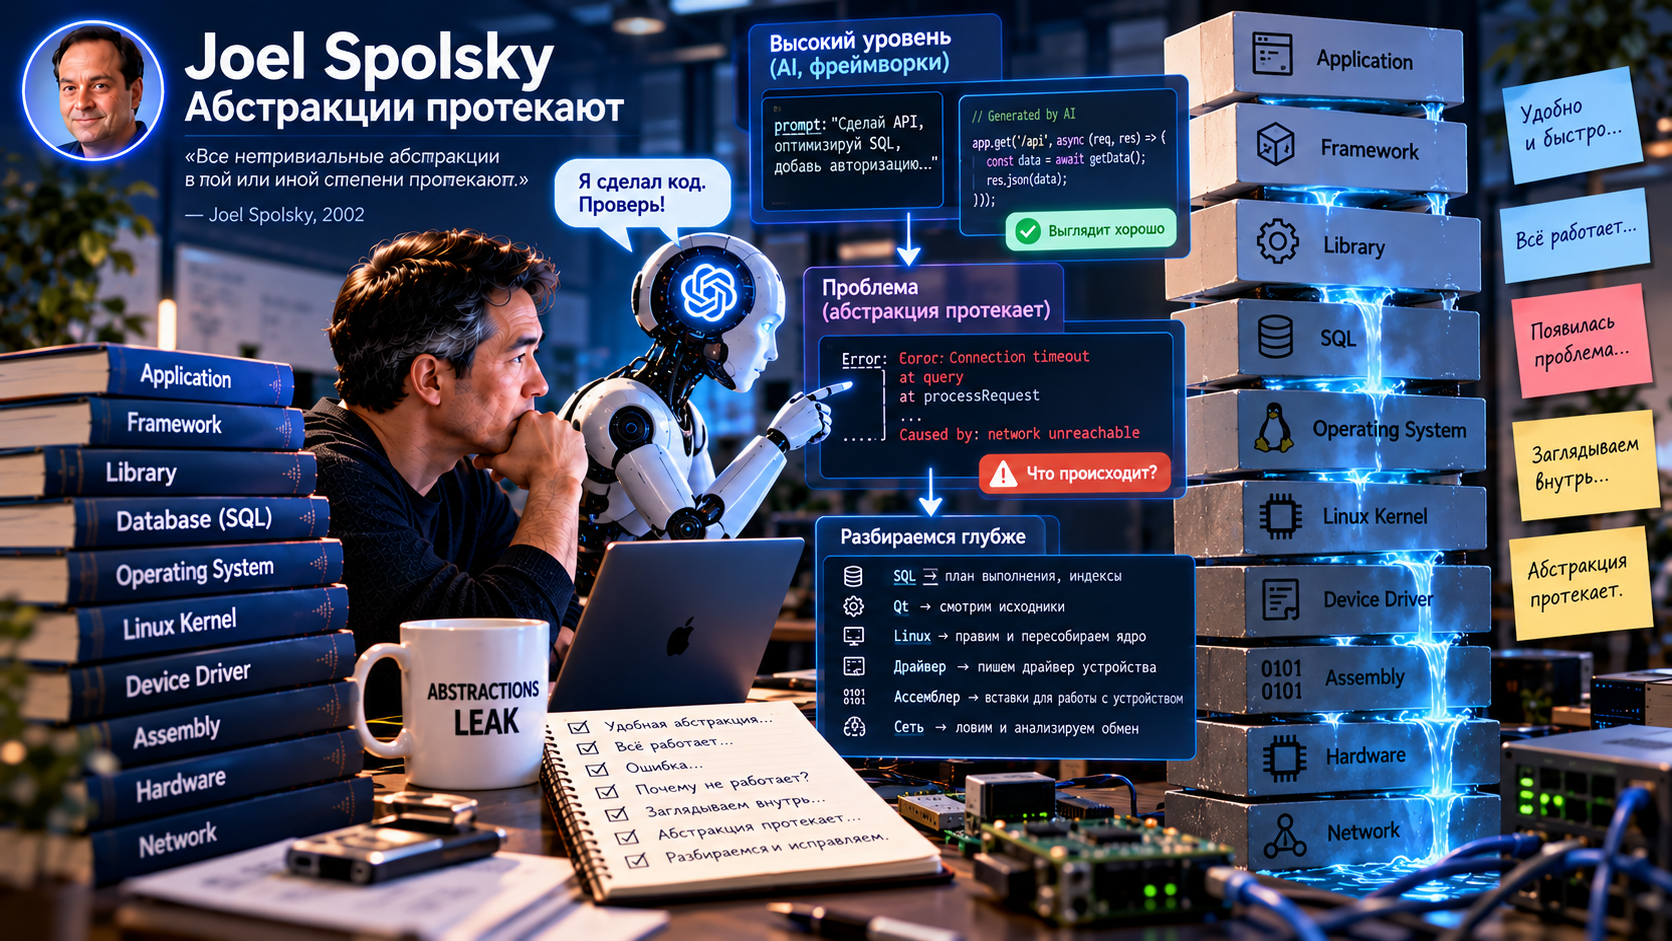
On November 11, 2002, he published the article The Law of Leaky Abstractions. Joel summed up her central idea very briefly: all non-trivial abstractions flow to one degree or another.
More than twenty years have passed, and I increasingly think that this is one of his most accurate articles.
Why do we need abstractions at all?
Almost all modern programming is based on abstractions.
When we work with a file, we don't want to think about disk sectors. When we run an SQL query, we don't want to manually describe the string search algorithm. When we open a network connection, we want to send data, not manage each packet ourselves.
This is the meaning of abstraction: a complex lower level turns into a simpler model.
Joel started his article with TCP. To a programmer, it looks like a reliable data link, although there is an unreliable network at the bottom. As long as everything is working, you can almost forget about packets, losses, and retransmission. But if the network becomes slow or disappears altogether, the lower level suddenly appears through a beautiful abstraction.
The same thing happens almost everywhere.
SQL is leaking too
One of Joel's examples is particularly familiar to anyone who has worked seriously with databases.
SQL allows us to describe what data we need without explaining to the database step by step how to search for it. In an ideal world, two logically identical queries should be executed approximately the same way.
In practice, one query can be executed instantly, while another is thousands of times slower. And then the beautiful abstraction "just write SQL" ends.
You have to open the execution plan, look at the indexes, the order of connections, statistics, and try to understand what the database is really doing inside. Joel used SQL specifically as one example of how implementation details inevitably leak out.
For me, getting into SQL at this level has become quite commonplace over time.
But it wasn't limited to that.
Sometimes you have to go all the way to the bottom
I had to write a non-standard device driver for Linux.
That is, at some point, the usual abstraction of the operating system is no longer enough. There is a physical device that behaves in a certain way, and a layer should appear between it and the program that simply did not exist before.
I had to figure out how the kernel sees this device, how the program should interact with it, and where the boundary between hardware and a regular application lies.
Sometimes I had to write assembler inserts to work with the hardware. At this level, it is almost impossible to pretend that there is no computer running the program.
Here are the registers.
Here's the memory.
Here is a specific processor command.
Abstraction is over.
Edit Qt and KDE
In another situation, the problem was much higher.
I've worked with Qt and KDE. It would seem that this is already a very convenient high-level world: windows, interface components, ready-made libraries, a huge number of already implemented features.
But sometimes the required behavior was simply not there or the implementation was not suitable for a specific task.
And then one of the main advantages of open source code became very practical: you could open the Qt or KDE sources, find the right place, change it and rebuild it.
Today it may sound a bit extreme: "you didn't like the library's behavior, so you started changing the library itself?"
But then it was a normal part of the job.
If abstraction prevented the system from doing what it needed, it was necessary to go down to a lower level.
Rebuild the core? An ordinary morning
It was the same with Linux.
Now most developers use the kernel as a given. I installed the system, got the update, and you're working.
But before broadband Internet and today's ready-made distributions, the situation was different. Editing the configuration, changing the necessary parts, and rebuilding the Linux kernel was almost like "good morning" to me.
You need certain equipment, you figure it out.
If you need another parameter, you change it.
Something doesn't work — you're looking at the source code.
This teaches you one thing very well: any convenient upper level ultimately stands on something lower.
And if you work long enough, sooner or later you'll have to go down there.
The network is also not as abstract as it seems.
Network programming is particularly good at confirming Joel's law.
On paper, everything looks beautiful: one program sends data, the other receives it. There is a protocol, libraries, connections.
But then the real network appears.
The package was delayed. The connection failed. The data did not arrive in the expected mode. Someone else's implementation of the protocol behaves a little differently.
And then you have to not just use the network library, but catch the real exchange and see what exactly went online.
What bytes were sent?
What did you get?
In what order?
Why does it work in one case and not in the other?
At this point, the beautiful "client sends a message to the server" model turns back into real packets and connection states.
Joel called it the price of experience.
There is another thought in the article that I particularly like.
Abstractions allow you to master about 90 percent of your daily work very quickly. But the remaining 10 percent may require years of experience. That's where Joel thinks the difference between a beginner and a really experienced programmer is especially noticeable.
A person can work perfectly with a high-level tool, as long as everything goes according to the standard scenario.
The real difficulties begin when abstraction leaks.
And then it's not enough to know which button to press or which function to call.
It is necessary to understand what exactly was hidden under it.
A high level does not cancel out a low one
There is a certain paradox of programming development in this.
We are constantly creating higher-level tools precisely in order to no longer deal with low-level details.
First, the assembler was replaced by high-level languages. Then libraries appeared. Then there are large environments, application frameworks, code generators, and cloud services.
Each new layer really allows you to do more.
But for some reason, old knowledge does not disappear.
Joel wrote about this back in 2002: new abstractions save work time, but they don't necessarily save learning time. To confidently use a high level, you have to understand at some point what is below.
My experience fully confirms this.
And now the biggest abstraction has appeared — AI.
In 2026, we have a new level.
You can say AI:
"Make me an API."
"Optimize this SQL."
"Add authorization."
"Fix the network error."
"Write a driver."
And he is really capable of producing a lot of ready-made code.
From a developer's point of view, this is an incredibly powerful abstraction. Sometimes you don't even need to remember the name of the required function or library class — it's enough to explain the task in human language.
But Joel's law has not gone away.
AI is also leaking.
As long as everything is working, everything is fine
If the generated code works, the abstraction level seems almost perfect.
You don't have to remember the syntax.
It is not necessary to know all the functions of the library.
You don't have to spend hours looking for an example.
You can describe the result and get an implementation.
But as soon as a non-standard problem appears, the same old question arises.:
What's really going on there?
The AI has written slow SQL — you will have to understand the query plan.
Wrong I used Qt — I'll have to know Qt.
I made a mistake working with the network, and I'll have to watch the packets.
I made a mistake in multithreading — I'll have to understand memory and synchronization.
I generated the wrong low—level code, so I may have to look at the machine instructions again.
The AI did not cancel the lower levels. He just let them ignore their existence for much longer.
And there is a new risk in this
Previously, a programmer gradually went through several levels of difficulty.
To write a network application, he studied the network at least a little. To work with the database, I gradually learned SQL. To do system programming, I inevitably encountered the memory and device of the operating system.
AI allows you to jump over some of these stages.
This is a huge advantage for the speed of development, but at the same time there is a danger: a person can get a working system, almost without understanding why it works.
So far, everything is normal, there is no problem.
But when the abstraction leaks, you'll still have to figure it out.
It is at this point that the experience becomes very expensive again.
Therefore, the low level will not disappear anywhere.
I don't think every modern programmer has to rebuild the Linux kernel or write drivers every day.
This is exactly the point of good abstractions — not to do unnecessary work.
But the developer must understand that abstraction is not reality. It's just a user-friendly interface to a more complex system.
The more responsible the software, the more important it is to know where these boundaries are.
And sometimes it's useful to have a person in the team who is able to go all the way down: from the application to the library, from the library to the operating system, from it to the network or hardware.
What's left of Joel's Law
When I think back to my own work, I realize that a significant part of the most difficult tasks began exactly where the next abstraction stopped working as promised.
SQL — I had to look deeper.
Qt and KDE — open and change sources.
Linux — edit and rebuild the kernel.
A non—standard device is to write a driver.
Hardware — use an assembler.
The network is to catch the real exchange.
It all started the same way every time: the high-level interface wasn't enough.
That's why Joel's article from twenty years ago seems especially relevant to me today. We've built even more abstraction layers and added AI on top of them.
But the law remained the same.:
the higher we go, the more convenient it is to work. But when something really breaks, sometimes you still have to go all the way down.
В начале 2000-х я продолжал читать Joel on Software. Джоэл Спольски к тому времени уже успел поработать в Microsoft, создать Fog Creek Software и стал одним из тех авторов, которые объясняли программирование не только через языки и алгоритмы, но и через реальный инженерный опыт.
11 ноября 2002 года он опубликовал статью The Law of Leaky Abstractions — «Закон протекающих абстракций». Её центральная мысль Джоэл сформулировал очень коротко: все нетривиальные абстракции в той или иной степени протекают.
Прошло больше двадцати лет, а я всё чаще думаю, что это одна из самых точных его статей.
Зачем вообще нужны абстракции
Практически всё современное программирование построено на абстракциях.
Когда мы работаем с файлом, нам не хочется думать о секторах диска. Когда выполняем SQL-запрос, не хочется вручную описывать алгоритм поиска строк. Когда открываем сетевое соединение, мы хотим отправить данные, а не самостоятельно управлять каждым пакетом.
Это и есть смысл абстракции: сложный нижний уровень превращается в более простую модель.
Джоэл начинал свою статью с TCP. Для программиста он выглядит как надёжный канал передачи данных, хотя внизу находится ненадёжная сеть. Пока всё работает, можно почти забыть о пакетах, потерях и повторной передаче. Но если сеть становится медленной или пропадает совсем, нижний уровень внезапно проявляется через красивую абстракцию.
То же происходит почти везде.
SQL тоже протекает
Один из примеров Джоэла особенно хорошо знаком каждому, кто серьёзно работал с базами данных.
SQL позволяет описать, какие данные нам нужны, не объясняя базе пошагово, как их искать. В идеальном мире два логически одинаковых запроса должны выполняться примерно одинаково.
На практике один запрос может выполняться мгновенно, а другой — в тысячи раз медленнее. И тогда заканчивается красивая абстракция «просто напиши SQL».
Приходится открывать план выполнения, смотреть индексы, порядок соединений, статистику и пытаться понять, что база реально делает внутри. Джоэл использовал именно SQL как один из примеров того, как детали реализации неизбежно просачиваются наружу.
Для меня лазить в SQL на этот уровень со временем стало совершенно обычным делом.
Но этим всё далеко не ограничивалось.
Иногда приходится идти до самого низа
Мне приходилось писать драйвер нестандартного устройства под Linux.
То есть в какой-то момент привычной абстракции операционной системы уже недостаточно. Есть физическое устройство, которое ведёт себя определённым образом, и между ним и программой должен появиться слой, которого раньше просто не существовало.
Приходилось разбираться, как ядро видит это устройство, как программа должна с ним взаимодействовать и где проходит граница между аппаратурой и обычным приложением.
Иногда приходилось писать ассемблерные вставки для работы с оборудованием. На этом уровне уже почти невозможно притворяться, что компьютера под программой нет.
Вот регистры.
Вот память.
Вот конкретная команда процессора.
Абстракция закончилась.
Править Qt и KDE
В другой ситуации проблема находилась значительно выше.
Я работал с Qt и KDE. Казалось бы, это уже очень удобный высокоуровневый мир: окна, компоненты интерфейса, готовые библиотеки, огромное количество уже реализованных возможностей.
Но иногда требуемого поведения там просто не было или реализация не подходила для конкретной задачи.
И тогда одно из главных преимуществ открытого исходного кода становилось очень практическим: можно было открыть исходники Qt или KDE, найти нужное место, изменить его и пересобрать.
Сегодня это может звучать несколько экстремально: «вам не понравилось поведение библиотеки — и вы полезли менять саму библиотеку?»
Но тогда это было нормальной частью работы.
Если абстракция не давала сделать то, что требовалось системе, приходилось спускаться на уровень ниже.
Пересобрать ядро? Обычное утро
То же самое было с Linux.
Сейчас большинство разработчиков используют ядро как данность. Поставил систему, получил обновление и работаешь.
Но до широкополосного интернета и сегодняшних готовых дистрибутивов ситуация была другой. Править конфигурацию, менять необходимые части и пересобирать ядро Linux для меня было почти как «с добрым утром».
Нужно определённое оборудование — разбираешься.
Нужен другой параметр — меняешь.
Что-то не работает — смотришь исходный код.
Это очень хорошо приучает к одной мысли: любой удобный верхний уровень в конечном счёте стоит на чём-то более низком.
И если работаешь достаточно долго, рано или поздно туда придётся спуститься.
Сеть тоже не такая абстрактная, как кажется
Сетевое программирование особенно хорошо подтверждает закон Джоэла.
На бумаге всё выглядит красиво: одна программа отправляет данные, другая принимает. Есть протокол, библиотеки, соединения.
Но потом появляется реальная сеть.
Пакет задержался. Соединение оборвалось. Данные пришли не в том режиме, который ожидался. Чужая реализация протокола ведёт себя немного иначе.
И тогда приходится уже не просто использовать сетевую библиотеку, а ловить реальный обмен и смотреть, что именно пошло по сети.
Какие байты отправили?
Что получили?
В каком порядке?
Почему в одном случае работает, а в другом нет?
В этот момент красивая модель «клиент отправляет сообщение серверу» превращается обратно в реальные пакеты и состояния соединения.
Джоэл называл это ценой опыта
В статье есть ещё одна мысль, которая мне особенно нравится.
Абстракции позволяют очень быстро освоить примерно 90 процентов повседневной работы. Но оставшиеся 10 процентов могут потребовать годы опыта. Именно там, по мысли Джоэла, особенно заметна разница между начинающим и действительно опытным программистом.
Человек может прекрасно работать с высокоуровневым инструментом, пока всё идёт по стандартному сценарию.
Настоящие сложности начинаются, когда абстракция дала течь.
И тогда уже недостаточно знать, какую кнопку нажать или какую функцию вызвать.
Нужно понимать, что именно скрывалось под ней.
Высокий уровень не отменяет низкий
В этом есть определённый парадокс развития программирования.
Мы постоянно создаём инструменты более высокого уровня именно для того, чтобы больше не заниматься низкоуровневыми деталями.
Сначала ассемблер заменили языками высокого уровня. Потом появились библиотеки. Затем большие среды, каркасы приложений, генераторы кода, облачные сервисы.
Каждый новый слой действительно позволяет делать больше.
Но старые знания почему-то не исчезают.
Джоэл писал об этом ещё в 2002 году: новые абстракции экономят время работы, но не обязательно экономят время обучения. Чтобы уверенно пользоваться высоким уровнем, приходится в какой-то момент понимать и то, что находится снизу.
Мой опыт это полностью подтверждает.
А теперь появилась самая большая абстракция — ИИ
В 2026 году у нас появился новый уровень.
Можно сказать ИИ:
«Сделай мне API».
«Оптимизируй этот SQL».
«Добавь авторизацию».
«Исправь сетевую ошибку».
«Напиши драйвер».
И он действительно способен выдать очень много готового кода.
С точки зрения разработчика это невероятно мощная абстракция. Иногда уже даже не нужно помнить название нужной функции или библиотечного класса — достаточно объяснить задачу человеческим языком.
Но закон Джоэла никуда не делся.
ИИ тоже протекает.
Пока всё работает — всё прекрасно
Если сгенерированный код работает, уровень абстракции кажется почти идеальным.
Не обязательно помнить синтаксис.
Не обязательно знать все функции библиотеки.
Не обязательно часами искать пример.
Можно описать результат и получить реализацию.
Но как только появляется нестандартная проблема, возникает всё тот же старый вопрос:
а что там реально происходит?
ИИ написал медленный SQL — придётся понимать план запроса.
Неправильно использовал Qt — придётся знать Qt.
Сделал ошибку в работе с сетью — придётся смотреть пакеты.
Ошибся в многопоточности — придётся понимать память и синхронизацию.
Сгенерировал неправильный низкоуровневый код — возможно, снова придётся смотреть машинные инструкции.
ИИ не отменил нижние уровни. Он просто позволил намного дольше не замечать их существование.
И в этом есть новый риск
Раньше программист постепенно проходил через несколько уровней сложности.
Чтобы написать сетевое приложение, он хотя бы немного изучал сеть. Чтобы работать с базой, постепенно узнавал SQL. Чтобы делать системное программирование, неизбежно встречался с памятью и устройством операционной системы.
ИИ позволяет перепрыгнуть часть этих этапов.
Это огромное преимущество для скорости разработки, но одновременно возникает опасность: человек может получить работающую систему, почти не понимая, почему она работает.
Пока всё штатно, проблемы нет.
Но когда абстракция протечёт, разбираться всё равно придётся.
Именно в этот момент опыт снова становится очень дорогим.
Поэтому низкий уровень никуда не исчезнет
Я не думаю, что каждый современный программист обязан каждый день пересобирать ядро Linux или писать драйверы.
В этом как раз и состоит смысл хороших абстракций — не делать лишнюю работу.
Но разработчик должен понимать, что абстракция не является реальностью. Она только удобный интерфейс к более сложной системе.
Чем ответственнее программное обеспечение, тем важнее знать, где проходят эти границы.
И иногда полезно иметь в команде человека, который способен пройти весь путь вниз: от приложения к библиотеке, от библиотеки к операционной системе, от неё к сети или оборудованию.
Что осталось от закона Джоэла
Когда я вспоминаю собственную работу, то понимаю, что значительная часть самых сложных задач начиналась именно там, где очередная абстракция переставала работать как обещано.
SQL — приходилось разбираться глубже.
Qt и KDE — открывать и менять исходники.
Linux — править и пересобирать ядро.
Нестандартное устройство — писать драйвер.
Аппаратура — использовать ассемблер.
Сеть — ловить реальный обмен.
Каждый раз всё начиналось одинаково: высокоуровневого интерфейса оказывалось недостаточно.
Именно поэтому статья Джоэла двадцатилетней давности сегодня кажется мне особенно актуальной. Мы построили ещё больше уровней абстракций и добавили поверх них ИИ.
Но закон остался прежним:
чем выше мы поднимаемся, тем удобнее работать. Но когда что-то действительно ломается, иногда всё равно приходится спускаться до самого низа.

 Share








