

The post has been translated automatically. Original language: Russian




A processor does far more than add and compare numbers. Real programs spend a large part of their time accessing memory: reading array elements, working with structure fields, storing intermediate values, and maintaining a stack. For that reason, the way an address is formed has a direct effect on both the instruction set and the internal design of the processor.
Donald Knuth’s MIX places addressing directly inside the general instruction format. Memora8 takes a simpler approach: a memory instruction uses a base register together with an offset encoded in the instruction.
Both designs can solve the same practical programming problems. The main difference is where the work is done — inside the hardware or in the instruction sequence produced by the program.
MIX carries part of the address calculation inside the instruction
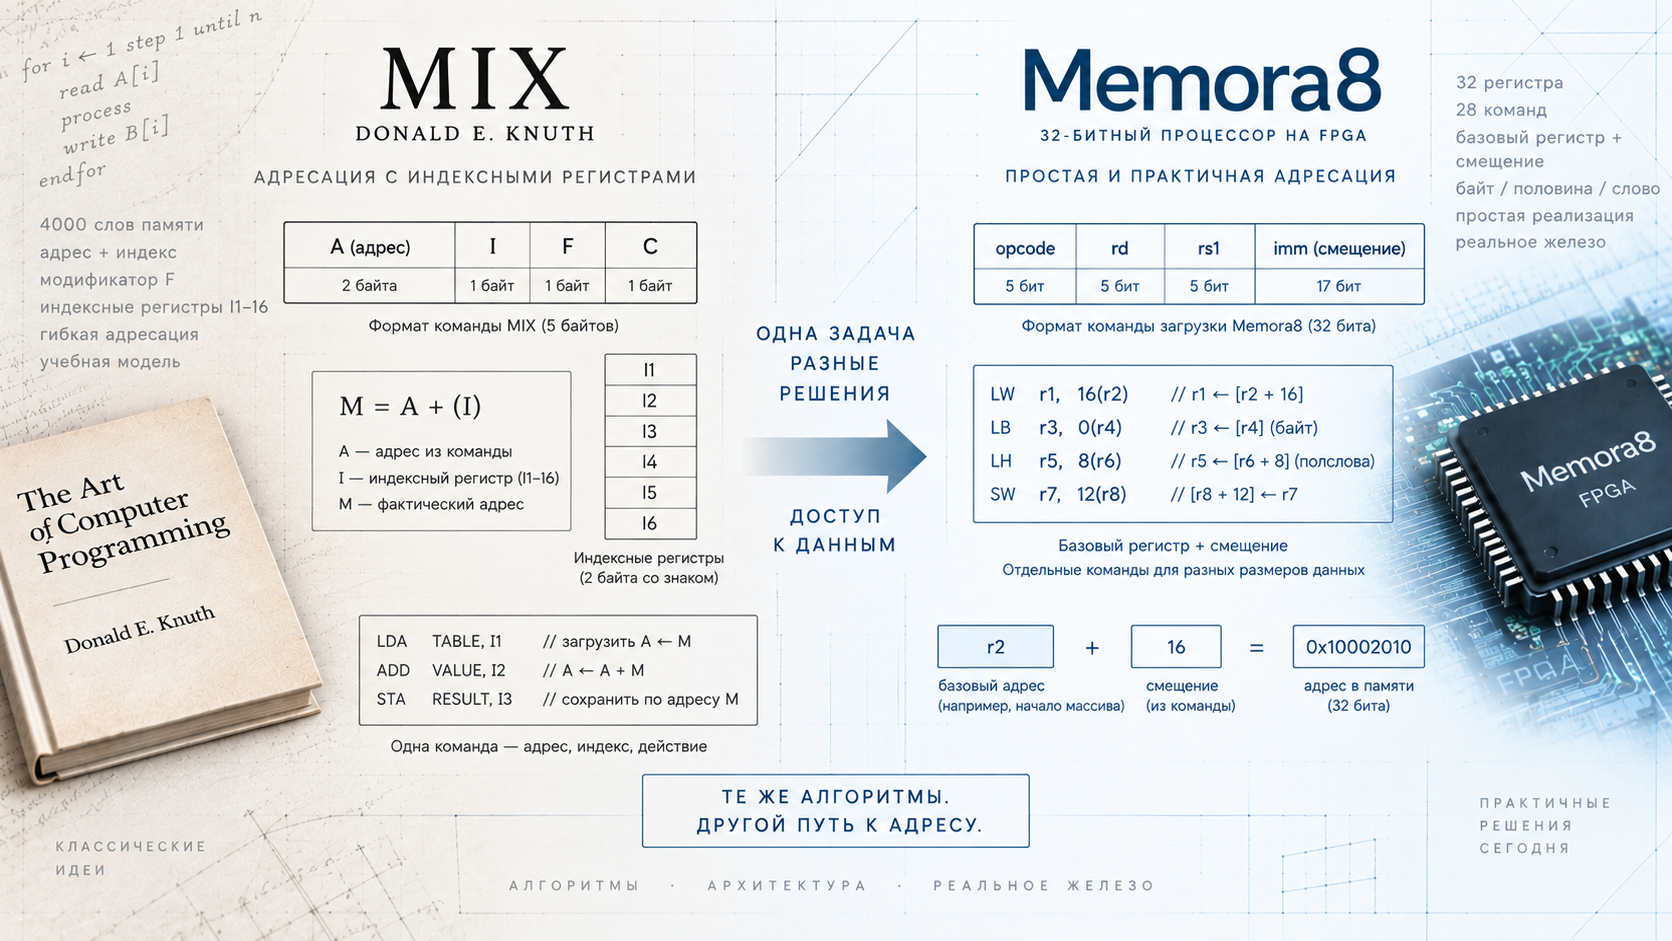
A MIX instruction contains an address field, an index field, a modifier, and an operation code. If no index register is selected, the address field is used directly. If an index register is specified, its value is added to the address.
That means every instruction already contains a small address-generation mechanism.
A program can keep the beginning of an array in the instruction and place the current position in an index register. During a loop, only the index value has to change, while the load or store instruction itself can remain unchanged.
For a machine designed to express algorithms clearly, this is a natural idea. Arrays, tables, and sequential data processing are common enough that Knuth made indexing a first-class architectural feature.
The indexed address is not merely a special case for load and store operations. It is part of the general way MIX interprets addresses before an instruction performs its specific action.
Why MIX has several index registers
Six index registers may look excessive for a relatively small machine, but they allow several independent positions to be maintained at the same time.
One register can track an input array, another can point into an output area, and a third can represent a position inside a lookup table.
Their purpose is visible directly from the architecture.
This makes programs easier to reason about, but it also means the processor must support a special class of registers, a dedicated instruction field for selecting them, and a defined rule for combining their contents with the address field.
For MIX, that extra structure is part of the machine’s expressiveness.
Memora8 chooses a different balance.
Memora8 has no separate index-register class
Memora8 uses 32 general-purpose registers. None of them is architecturally reserved as an index register.
A memory instruction forms its address by taking a base register and adding an immediate offset from the instruction.
The same mechanism works for many common cases.
A register can point to the start of a structure, while the offset selects a field. Another register can hold the beginning of an array. A stack pointer can be treated in exactly the same way.
If a loop needs to move through memory, the program can simply update the base register using ordinary arithmetic instructions.
From the processor’s point of view, there is no distinction between an index, a pointer, and an ordinary integer value.
This is one of the clearest differences between the two architectures.
MIX treats indexing as a dedicated architectural concept. Memora8 treats address calculation as ordinary arithmetic performed on general-purpose values.
What happens when base plus offset is not enough?
Some addresses are more complicated than a fixed displacement from a base register.
An array index may have to be multiplied by the size of an element. An address can also depend on several runtime values.
Memora8 does not solve such cases by adding more complex memory instructions.
Instead, the program computes the required address first using ordinary arithmetic. Once the address is ready, a regular load or store operation uses it as the base, possibly together with a small offset.
The complexity still exists, but it does not become a hidden feature of the memory instruction.
This follows a broader design rule in Memora8: if an operation can be expressed cleanly using existing mechanisms, there is no immediate need to add a new hardware mode for it.
The result may sometimes require more instructions, but the behavior of each memory access remains simple and predictable.
A MIX instruction can describe more at once
MIX combines several pieces of information in one instruction: an address, an index selection, and an additional modifier.
As a result, one instruction can say not only where data is located, but also part of how the final location or interpretation should be derived.
That can make the machine code compact.
The cost is that the hardware must interpret several instruction fields together.
Memora8 separates these concerns. Address generation uses a base register and an offset. If more calculation is required, it happens in earlier arithmetic instructions.
This creates two different styles.
MIX puts more meaning into each individual instruction.
Memora8 relies more on short sequences of simpler instructions.
Data size is handled separately
In MIX, address calculation is closely connected with another unusual feature: operations can work with selected fields of a machine word.
Memora8 separates these concepts.
There are dedicated memory operations for bytes, halfwords, and full 32-bit words. Stores follow the same general idea.
This means the processor does not need one universal mechanism for selecting arbitrary portions of a memory word after every access.
If a program needs an even smaller bit field, it can extract it later with shifts and logical operations.
The size of the memory access is therefore explicit in the instruction itself.
That makes the memory path easier to understand and easier to implement consistently in hardware.
Simple addressing does not mean simple memory
A small number of addressing modes should not be confused with a trivial memory system.
Memora8 can still have address translation, access checks, page mappings, and other mechanisms behind the instruction-level address.
Those mechanisms belong to a different layer.
The instruction set answers a narrower question: what address does this particular memory operation request?
For Memora8, the answer is deliberately simple — take a general-purpose register and add an offset.
Keeping this rule separate from the rest of the memory subsystem prevents the full complexity of memory management from leaking into every instruction format.
What is lost, and what is gained?
Rich addressing modes can reduce the number of machine instructions required by a program.
If one instruction can calculate a complex address and access memory at the same time, the program does not need several preparation steps.
That is a real advantage.
But every additional addressing form has to be recognized, decoded, supplied with operands, executed, and verified alongside every other instruction behavior.
As the number of special cases grows, the processor becomes harder to implement and harder to validate.
Memora8 accepts a different tradeoff. A complicated address may take a few ordinary instructions to prepare, while the actual load or store operation remains simple.
This is where the relationship between MIX and Memora8 becomes most interesting.
The goal is the same: make it practical for programs to move through data structures and memory.
Knuth solved that problem with dedicated index registers and an index field built into the instruction.
Memora8 already has 32 general-purpose registers, so a separate class of index registers is no longer necessary.
In MIX, an index is an architectural role.
In Memora8, an index is simply a value.
That small difference reflects a broader design principle: do not create a new hardware mechanism when an existing general mechanism can solve the same problem clearly enough.
Процессору недостаточно уметь складывать и сравнивать числа. Большая часть реальной программы постоянно обращается к памяти: читает элементы массивов, получает поля структур, сохраняет промежуточные результаты и работает со стеком. Поэтому способ вычисления адреса заметно влияет и на систему команд, и на устройство самого процессора.
В MIX Дональда Кнута адресация встроена непосредственно в общий формат машинной команды. В Memora8 она устроена гораздо проще: для обычного обращения к данным используются регистр с базовым адресом и смещение, записанное в инструкции.
Оба подхода позволяют решить одни и те же практические задачи, но распределяют работу между аппаратурой и программой по-разному.
Адрес уже является частью команды MIX
Команда MIX содержит адресное поле, поле индекса, модификатор и код операции. Адрес занимает первые два байта вместе со знаком, а следующий байт определяет индексный регистр. Если индекс не указан, используется непосредственно адрес из команды. Если указан, к нему прибавляется содержимое одного из шести индексных регистров I1–I6. Полученное значение Кнут обозначает как M — фактический адрес, с которым будет работать инструкция.
Таким образом, команда уже содержит небольшой механизм вычисления адреса.
Например, программа может хранить начало некоторой области памяти в самой инструкции, а положение нужного элемента — в индексном регистре. При каждом проходе цикла достаточно изменять индекс. Команда загрузки при этом остаётся прежней, а фактический адрес перемещается по массиву вместе со значением регистра.
Для алгоритмической машины это очень естественное решение. Массивы, таблицы и последовательная обработка данных встречаются постоянно, поэтому Кнут выделил индексирование в самостоятельный механизм архитектуры.
Причём индексирование используется не только командами чтения или записи памяти. В MIX понятие Mприменяется достаточно широко: сначала машина получает адрес с учётом выбранного индексного регистра, а затем конкретная инструкция решает, что с этим значением делать.
Адресация оказывается частью общего языка процессора.
Зачем понадобились шесть индексных регистров
Наличие сразу шести индексных регистров может показаться необычным для небольшой учебной машины. Но они хорошо соответствуют способу программирования, который заложен в MIX.
Одновременно можно вести несколько независимых позиций: например, индекс исходного массива, индекс результата и счётчик некоторой таблицы. Каждый из них получает собственный регистр, предназначенный именно для работы с адресами.
Такое разделение делает намерение программы хорошо заметным. Если используется I3, заранее известно, что это индексный регистр и его содержимое предназначено прежде всего для изменения адресной части команды.
Но вместе с удобством появляется специализация.
Процессор должен иметь отдельный тип регистров, отдельное поле для их выбора внутри инструкции и правила формирования итогового адреса. Кроме того, индексные регистры MIX отличаются от A и X размером и назначением.
Для Кнута это разумная цена за выразительность машины. Memora8 проводит границу в другом месте.
В Memora8 отдельного индексного механизма нет
У Memora8 все основные вычисления строятся вокруг 32 регистров общего назначения. Отдельных индексных регистров среди них нет.
Команды работы с памятью используют простой формат: один регистр содержит основу адреса, а инструкция добавляет к нему непосредственное смещение. В том же формате указывается регистр, из которого данные нужно записать в память или куда следует поместить результат чтения.
Это знакомая практическая схема.
Если в одном из регистров находится адрес начала структуры, смещение позволяет обратиться к её полю. Если регистр указывает на начало области памяти, можно прочитать данные на некотором расстоянии от него. Если программа проходит по массиву, базовый адрес можно изменять обычными арифметическими командами.
Процессор при этом не знает, является ли конкретный регистр указателем, индексом массива или обычным числом. Для него это просто 32-битное значение.
Именно этим подход Memora8 отличается от MIX наиболее заметно. Кнут выделяет индексирование как самостоятельную архитектурную возможность. Memora8 рассматривает вычисление адреса как частный случай обычной арифметики над значениями в регистрах.
Что происходит, если простого смещения недостаточно
Любая простая схема адресации вызывает закономерный вопрос: что делать, если адрес вычисляется сложнее?
Допустим, нужно обратиться к элементу массива, а его номер необходимо сначала умножить на размер элемента. Или адрес зависит сразу от нескольких переменных. Более богатая система команд могла бы добавить новые варианты адресации и выполнять часть такой работы непосредственно во время загрузки из памяти.
В Memora8 для этого не требуется расширять команду чтения.
Сначала программа вычисляет нужный адрес обычными операциями над регистрами. После этого команда загрузки или сохранения получает уже подготовленную основу адреса и добавляет предусмотренное форматом смещение.
То есть сложность не исчезает. Она просто переносится из устройства адресации в последовательность обычных команд.
Это один из характерных принципов Memora8: если задачу можно выразить уже существующими простыми операциями, не обязательно добавлять новый аппаратный вариант выполнения той же задачи.
В результате отдельная программа иногда выполняет больше инструкций, зато само обращение к памяти остаётся предсказуемым.
У MIX одна инструкция знает больше
На этом фоне особенно хорошо видно устройство MIX.
Команда MIX получает не только собственно адрес, но и указание, какой индексный регистр следует к нему добавить. Рядом находится поле-модификатор, которое для многих операций определяет ещё и часть машинного слова, с которой предстоит работать.
Поэтому одна команда может одновременно сообщить машине довольно много: где находятся данные, какой индекс нужно применить и какую часть полученного слова следует использовать.
Для программиста это позволяет выразить сложное действие компактно. Для архитектуры означает, что одна инструкция управляет сразу несколькими механизмами.
Memora8 разделяет эти задачи. Адрес формируется проще, размер данных задаётся разновидностью команды чтения или записи, а более сложное вычисление адреса выполняется обычными операциями до обращения к памяти.
Получаются два разных способа добиться выразительности.
У MIX она во многом находится внутри самой инструкции. У Memora8 — в возможности соединять простые инструкции между собой.
Размер данных — отдельный вопрос
В MIX адрес указывает на машинное слово, после чего модификатор может определить, какая его часть участвует в операции. Это тесно связывает адресацию с необычной особенностью MIX — работой с полями слова.
В Memora8 эти понятия разделены.
Для чтения памяти существуют отдельные команды для байта, половины 32-битного слова и полного слова. Для записи действует тот же общий принцип. Поэтому процессору не требуется универсальный механизм выбора произвольного поля уже после обращения к памяти.
Если требуется прочитать байт, выполняется команда чтения байта. Если нужны 32 бита, используется чтение слова.
Такое решение менее универсально, чем поля MIX, зато поведение каждой операции определяется непосредственно её кодом и проще проходит через тракт памяти процессора.
Это особенно существенно для реальной аппаратной реализации. Обращение к памяти в Memora8 имеет собственную стадию конвейера, где формируется доступ и выполняются необходимые проверки. Чем меньше различных вариантов трактовки одной и той же команды приходится поддерживать на этом пути, тем проще сохранять единые правила выполнения.
Простая адресация не означает простую память
Здесь важно разделять две вещи.
Небольшое количество способов сформировать адрес внутри команды не означает, что вся система памяти Memora8 должна быть примитивной. За обычным адресом могут находиться механизмы отображения памяти, страницы и проверки доступа. Для программы это отдельный уровень архитектуры.
Система команд отвечает на более узкий вопрос: как инструкция сообщает процессору, к какому адресу данных она хочет обратиться?
В рассматриваемой версии Memora8 ответ намеренно простой: взять значение обычного регистра и добавить смещение.
Это позволяет не смешивать вычисление адреса с устройством всей подсистемы памяти. Команда формирует адрес, а дальнейшие механизмы уже определяют, разрешён ли доступ и где физически находятся нужные данные.
Такое разделение также уменьшает количество специальных случаев внутри самой инструкции.
Что потеряно и что приобретено
Богатая адресация экономит команды. Если процессор способен одновременно вычислить сложный адрес и выполнить обращение к памяти, программе не приходится заранее готовить его отдельными операциями.
Это реальное преимущество, и именно поэтому более сложные способы адресации неоднократно появлялись в процессорных архитектурах.
Но за экономию машинных команд платит аппаратура.
Каждый дополнительный вариант нужно распознать, получить необходимые операнды, вычислить результат и провести его через процессор с правильными правилами для всех остальных инструкций. Чем больше способов сделать почти одно и то же, тем больше состояний системы приходится учитывать при реализации и проверке.
Для Memora8 был выбран другой компромисс. Пусть сложный адрес иногда требует предварительного вычисления, зато само обращение к памяти строится вокруг небольшого количества понятных правил.
И здесь снова обнаруживается связь с MIX не через копирование конкретного механизма, а через вопрос, который стоит за ним.
Кнуту было необходимо дать алгоритмам удобный способ двигаться по данным, и для этого он ввёл шесть специальных индексных регистров и индексное поле в каждой инструкции.
Memora8 решает ту же задачу, но уже имея 32 обычных регистра и ориентируясь на аппаратную реализацию в FPGA. Поэтому отдельный класс индексных регистров становится необязательным: адрес можно строить из тех же значений и теми же операциями, которыми программа пользуется для остальных вычислений.
В MIX индекс является частью архитектурной роли регистра.
В Memora8 индекс — это просто число.
И это небольшое различие хорошо показывает общее направление всей архитектуры Memora8: не создавать новый тип механизма, пока ту же задачу можно достаточно ясно решить уже существующим.

 Share








