
The post has been translated automatically. Original language: Russian



CRM creates a very convincing sense of order. The client has a card, a stage has been selected for the transaction, the amount has been filled in, a responsible person has been appointed, dates and tasks are set. Everything is laid out by fields, which means it seems that this data can be trusted.
The problem is that most of the errors in CRM don't look like a mistake at all.
A phone with an extra digit is easy to spot. Much more dangerous is a field in which the correct value is written, but it is no longer relevant. Or two similar fields that employees understand slightly differently. The status can be selected correctly, although the real situation with the client has changed a long time ago.
Such data easily passes any checks, gets into reports, runs automatic scripts and becomes a context for AI.
At this point, a small inaccuracy ceases to live only inside one card.
The error may look completely normal.
Let's imagine that the CRM has a date for the next contact. The value is filled in, the format is correct, and the system is satisfied.
But where did this date come from?
Did the manager install it after talking to the client? Was it automatically transferred from the old task? Did the client then write to the chat and the agreement changed? Is there another field nearby with a similar meaning that is already being used by another process?
Everything is fine for the database. For a human, the value also looks convincing. The error will appear only when someone starts making a decision based on it.
A similar story happens with payments. The account's currency is stored in one place, and the currency of a specific operation is stored in another. The value itself is correct in both cases. If you confuse the meaning of the fields, the money suddenly starts getting into the wrong reports.
Even the word "paid" requires a definition. Has the invoice been issued? Has the client reported the payment? Has the money been received yet? Has an advance been made? Has the purchase been completed?
While CRM just stores information, such a difference can remain unnoticeable for a long time. As soon as analytics are available, the value of each field becomes part of the calculation.
Most of the dirt appears gradually
Usually, no one sits down in the morning to mess up the CRM.
The system develops together with the company. A new process appears, and an additional field is created for it. Then integration is connected and brings its own meaning. Another department needs similar information, but in a slightly different way. The old field can no longer be deleted, because automation is tied to it.
In a few years, there may well be two dates for the next contact, several ways to identify the person responsible, and three different signs that the customer has paid.
Each of them appeared at some point for an understandable reason.
A separate problem arises at the border of divisions. Sales, support, marketing, and finance look at the same customer from different angles. An agreement is important for the manager. For accounting - the fact of receipt of money. For marketing, it is the customer's source. For the manager, it's who the result belongs to in the end.
All these data can be correct at the same time, if it is clear in advance exactly what each of them means.
Without such definitions, CRM is gradually turning into a place where multiple versions of the same reality are stored.
A beautiful report easily hides bad data.
You can still see problems in individual cards. In aggregated analytics, they become almost invisible.
The dashboard shows 27%, 14 million, or 346 customers. The number looks accurate simply because it has two decimal places and a neat graph next to it.
At the same time, there may be old responsible persons, incorrect statuses, duplicates, transactions with another currency, or clients that the system counted twice.
The higher the level of aggregation, the more difficult it is to see the origin of the error.
Therefore, good analytics should allow you to go the other way. From the total figure, to the group, then to the manager, and from there to the specific clients and events from which this figure was collected.
This is useful not only for finding bugs.
If the indicator cannot be properly explained at the level of the initial data, it is difficult for the manager to make a decision even when the calculation is technically correct.
For example, the message "the manager has increased the number of problem clients" is almost useless without the ability to understand the reasons. A part may not have a next action. Someone has an overdue agreement. Someone has already paid an advance and was mistakenly included in the sample.
After disclosing the figure, it becomes clear whether there is a management problem there.
Automation makes data quality even more important.
Sometimes a person notices an oddity and stops.
The manager opens the card, sees the contradiction between the status and the last correspondence, and first understands the situation. The automatic script usually works differently: the condition is met, which means that the next action is triggered.
If the data is incorrect, the system may send an inappropriate message, move the transaction, change the person responsible, or set an unnecessary task.
The more processes that work without the participation of employees, the more expensive the bad source information becomes.
With AI, this dependence increases even more.
The model can understand free speech well, compare the history of communication and find connections between a large number of facts. But if the old status, the new agreement, and two fields with different values of the same entity are inside the CRM at the same time, the AI has another task: to understand what to believe from this.
A confident answer in a bad context is still a bad answer.
Therefore, before implementing complex AI scenarios, it is useful to understand rather boring things: what data is basic, where it comes from, how quickly it becomes obsolete, and what event can change it.
Fields without precise meaning are especially dangerous.
Many CRM systems have fields that everyone has been using for a long time, but different employees explain them in slightly different ways.
You can do a simple experiment. Select one important field and ask several people separately what exactly should be stored in it.
If the answers differ, the problem already exists.
It is even more useful to ask at what point the value should be updated. It turns out that agreeing on a name is often easier than agreeing on a data lifecycle.
Who changes the responsible person after the transfer of the client? What happens to the old value after payment? Do I need to clear the next date if the client contacted me earlier? How can I account for a refund? What is considered a new client after several years of absence?
It is from such small issues that large discrepancies in analytics are then collected.
The name of the field only answers the question of what was put there approximately. For normal operation, you also need to understand the source, the time of the update, and the rules by which the value ceases to be relevant.
CRM cleanliness does not mean that all fields are filled in.
Sometimes they try to improve the quality of data in the most obvious way: to make more fields mandatory.
As a result, there are actually fewer empty values.
Instead, "Other" appears, random dates, the first suitable option from the list, and values that the employee filled out just to save the card.
Formally, the database is getting cleaner. In terms of meaning, sometimes the opposite happens.
The lack of information is also information. If we don't know the date of the client's decision yet, an honest empty field is more useful than a fictitious date that will later be included in the forecast.
Therefore, commitment works well where the employee is really required to know the answer at this point in the process. In all other cases, it may simply mask the unknown.
It's not the cards that need to be cleaned, but the rules.
Periodic deduplication is useful. Old contacts should be updated, unnecessary fields should be removed, errors should be corrected.
But if the data logic itself remains the same, in a few months the database will return to approximately the same state.
It is much more useful to select key business entities and agree on where the source of truth for each of them is located. Where does the payment fact come from? How the current responsible person is determined. How the following arrangement is fixed. Which currency is used by a particular indicator. What exactly does each important status mean.
After that, you can see which processes are capable of changing these values and whether there are several systems that do this independently of each other.
A good CRM check doesn't require a lot of auditing at all. You can take twenty random clients and try to restore their history based on the system data alone.
Who is responsible for the client now? What's going on with him? When was the last meaningful contact? What have we agreed on? What should happen next? Did he pay and what exactly does CRM confirm this?
If you have to answer these questions with the words "it depends on which field to look at," the problem is already clear.
Data is not needed for the sake of order
A perfectly clean CRM most likely does not exist. People make mistakes, processes change, integrations are updated, new products and new ways of interacting with customers appear.
Therefore, the goal is not in a sterile database.
You need to understand which data really affects sales, automatic actions, analytics, and executive decisions. It is to them that the requirements should be particularly high.
A phone with a typo will ruin one call. An incorrectly determined source of truth can ruin a report for the entire department for months.
And the more a company trusts CRM to make decisions on its own, the more noticeable this difference becomes.
Good data is the data that the system and the person use to equally understand what is happening to the client right now.
AI внутри CRM становится полезным ровно в тот момент, когда получает контекст.
Одно дело попросить модель написать вежливый ответ клиенту. Для этого достаточно нескольких предложений. Совсем другое - спросить, почему сделка остановилась, что уже обсуждали с клиентом, какой у него тариф, кто с ним работал раньше и что лучше сделать дальше.
Чем больше система знает, тем точнее может быть ответ.
Отсюда легко сделать следующий шаг: раз все данные уже находятся в CRM, почему бы просто не показать AI всё?
Технически это самый простой вариант. С точки зрения бизнеса далеко не всегда лучший.
Доступ лучше начинать с задачи
Представим AI, который помогает менеджеру отвечать клиентам.
Для этой работы ему действительно может понадобиться история переписки, текущая сделка, предыдущие договорённости, используемый продукт и несколько важных полей карточки.
Но нужны ли ему сделки других менеджеров? Финансовые показатели всего отдела? Внутренние комментарии руководителя? Данные по сотрудникам? История клиентов, с которыми этот менеджер никогда не работал?
Скорее всего, нет.
Это примерно тот же принцип, по которому компании давно настраивают права сотрудников. Бухгалтеру нужен один набор информации, продавцу другой, руководителю третий. Никому не дают доступ ко всей системе только потому, что технически это возможно.
С AI полезно начинать с того же вопроса: какие данные нужны для конкретной задачи?
Не «что модель умеет прочитать», а «без какой информации она не сможет нормально выполнить работу».
Разница кажется небольшой, но сильно меняет архитектуру.
Читать и действовать - разные права
Доступ к данным сам по себе ещё не означает право что-то менять.
AI может прочитать переписку и подготовить краткое резюме. Может посмотреть историю сделки и подсказать менеджеру следующий шаг. Может найти в CRM клиентов, по которым давно не было активности.
Все эти сценарии почти не меняют исходные данные.
Совсем другой уровень начинается, когда агент получает возможность самостоятельно отправлять сообщения, менять этапы, создавать документы, редактировать поля или запускать бизнес-процессы.
Цена ошибки здесь заметно выше.
Поэтому права на чтение и права на действие полезно разделять. Иногда AI достаточно дать возможность увидеть информацию и подготовить предложение, а последнее действие оставить сотруднику.
Например, система может определить, что клиент давно не выходил на связь, показать историю и предложить текст сообщения. Менеджер проверяет контекст и нажимает «Отправить».
Если этот сценарий месяцами работает предсказуемо, часть решений можно постепенно передавать агенту.
Так доступ расширяется вместе с доверием к конкретному процессу, а не выдаётся целиком в первый день.
Не вся информация в карточке предназначена клиенту
CRM хранит не только факты.
В ней бывают внутренние заметки, комментарии менеджеров, оценки перспектив сделки, обсуждение скидки, история ошибок, причины отказа и другая информация, которая помогает сотрудникам работать между собой.
Человек обычно понимает разницу между тем, что известно компании, и тем, что можно сказать клиенту.
Для AI эту границу нужно задавать явно.
Представим внутренний комментарий: клиент заинтересован, но скидку пока не предлагать. Такая заметка полезна менеджеру. Если агент использует её как контекст для ответа, он не должен написать клиенту: «Мы пока решили не давать вам скидку».
Другой пример - причина, по которой компания считает сделку рискованной. Эта информация может быть полезна руководителю и модели, которая готовит прогноз, но совершенно не обязательно должна участвовать в клиентской переписке.
Поэтому одного контроля доступа недостаточно. Важно ещё понимать для чего конкретные данные разрешено использовать.
AI может видеть информацию для анализа и при этом не иметь права воспроизводить её во внешнем сообщении.
Контекст тоже может быть лишним
Есть ещё менее очевидная проблема.
Большой контекст не всегда делает ответ лучше.
Если по клиенту накопилось пять лет истории, сотни сообщений, несколько старых сделок и десятки технических событий, передавать всё это модели при каждом вопросе бессмысленно.
Часть информации давно устарела. Некоторые события относятся к другому продукту. Старые договорённости уже не действуют. Внутри истории могут находиться противоречивые данные.
Мы уже привыкли думать, что главное преимущество AI - способность переваривать большие объёмы информации. На практике не менее важным становится умение правильно выбрать маленькую часть этих данных.
Для ответа на вопрос клиента про текущую оплату обычно не нужна вся его история с момента регистрации.
Полезнее дать модели свежую переписку, актуальную сделку, факт последней оплаты и действующие договорённости.
Получается интересная вещь: качество AI зависит не только от количества доступных данных, но и от качества отбора контекста.
CRM должна уметь не просто хранить историю, а понимать, какая её часть сейчас имеет значение.
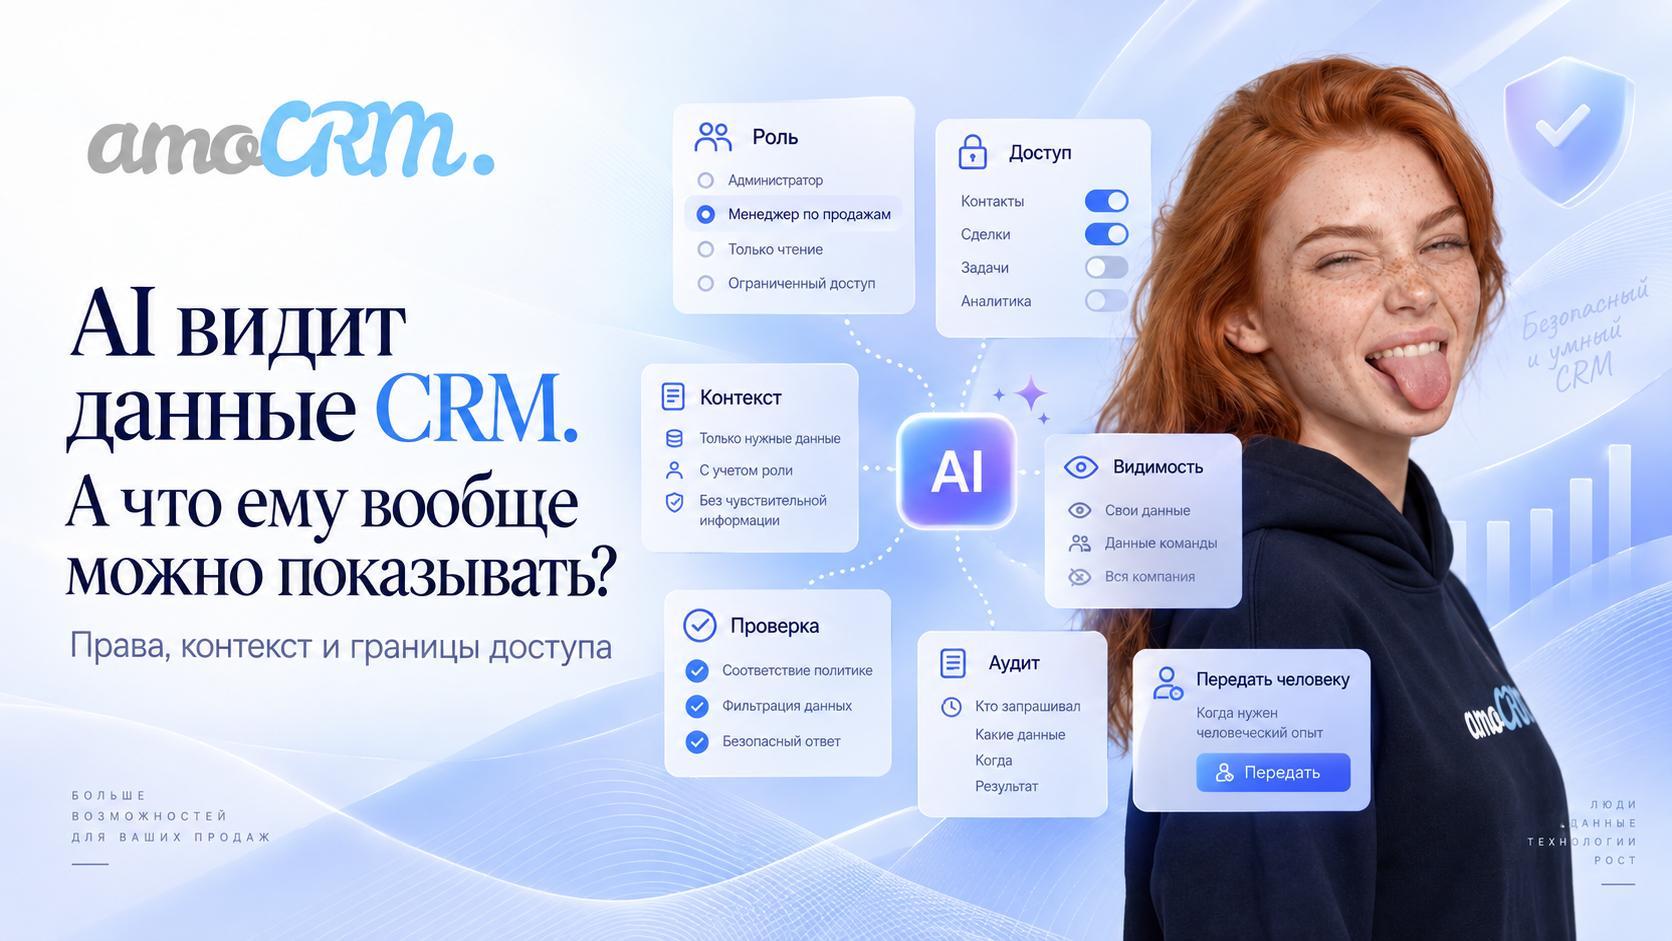
Права сотрудника и права AI лучше связывать
Есть простой ориентир, который сильно облегчает настройку.
Если AI работает как помощник конкретного менеджера, логично, чтобы он не получал больше информации, чем доступно самому менеджеру.
Сотрудник не видит определённый отдел - его помощнику эти данные тоже не нужны. Нет доступа к финансовому полю - AI не должен обходить это ограничение. Менеджеру запрещено экспортировать определённую информацию - агенту тоже не стоит давать такую возможность через другой интерфейс.
Это особенно важно потому, что AI делает доступ к данным намного удобнее.
Человеку раньше пришлось бы открыть несколько разделов CRM, поставить фильтры и собрать информацию вручную. Теперь достаточно спросить: «Покажи всех крупных клиентов, которые собираются уйти».
Если модель технически имеет доступ к большей части базы, один обычный вопрос может неожиданно превратиться в очень широкий запрос данных.
Поэтому привычные права доступа никуда не исчезают. Наоборот, с появлением AI их значение становится выше.
Руководителю и менеджеру нужен разный AI
Один из интересных эффектов появляется, когда AI используется людьми с разными ролями.
Менеджер может спросить: «Что мне сегодня нужно сделать по своим клиентам?»
Руководитель задаёт другой вопрос: «У кого из команды вырос риск по крупным сделкам?»
Формулировки похожи, но для ответа требуется разный объём данных.
Менеджеру достаточно собственного портфеля. Руководителю нужна агрегированная информация по команде и возможность провалиться глубже, если появилось отклонение.
Поэтому идея одного всемогущего AI, который одинаково работает для всей компании, выглядит удобно только на старте.
Гораздо естественнее, когда возможности агента зависят от роли пользователя, его прав и задачи, которую он выполняет сейчас.
Тогда AI становится продолжением существующей системы управления доступом, а не способом её обойти.
Особенно осторожно стоит относиться к свободным запросам
В обычном интерфейсе CRM доступ к информации ограничен самой структурой продукта. Пользователь открывает конкретный раздел, выбирает фильтр, видит разрешённые поля.
Разговорный интерфейс снимает большую часть этих ограничений.
Можно задать вопрос, о котором разработчики интерфейса вообще не думали: «Какие наши клиенты одновременно дают самую большую выручку и чаще остальных обращаются в поддержку?»
Для бизнеса это полезнейшая возможность.
Но именно поэтому контроль должен происходить не только на уровне кнопок и экранов. Нужно проверять данные, которые используются для самого ответа.
Модель не должна сначала получить всю базу, а потом решить, какую часть можно показать сотруднику. Ограничение лучше применять раньше: в контекст попадает только та информация, к которой пользователь имеет право обратиться.
Это менее эффектная часть AI-проектов, чем качество ответов, но для реальной эксплуатации она намного важнее.
Полезно знать, что именно увидел AI
Когда сотрудник принимает решение по карточке, обычно можно восстановить его действия: что он открыл, какие данные изменил, кому написал.
С AI полезно сохранять похожую прозрачность.
Не обязательно записывать каждое техническое движение модели. Но для важных действий должно быть понятно, на какой информации был основан результат.
Если агент решил изменить статус сделки, отправить сообщение или передать клиента другому сотруднику, хорошо иметь возможность понять, какие данные повлияли на решение.
Это помогает разбирать ошибки, улучшать сценарии и постепенно расширять возможности агента там, где он уже показал стабильную работу.
Без такой прозрачности появляется неприятная ситуация: действие произошло правильно девяносто девять раз, а на сотый никто не может объяснить, почему система поступила иначе.
Меньше доступа не обязательно означает меньше пользы
Когда компании только начинают использовать AI, часто кажется, что ограничения будут ухудшать его работу.
Иногда происходит обратное.
Чётко ограниченный контекст уменьшает количество устаревшей и случайной информации. Ролевая модель помогает точнее понимать задачу пользователя. Разделение чтения и действий снижает последствия ошибки. А понятные правила передачи человеку позволяют использовать AI даже там, где полностью автономная работа пока слишком рискованна.
В итоге вопрос «что можно показать AI?» лучше решать так же, как вопрос доступа любого нового сотрудника.
Сначала определить его работу.
Потом понять, какая информация для неё нужна.
После этого дать минимально достаточные права и расширять их там, где появилась понятная польза.
AI действительно может видеть гораздо больше человека и обрабатывать эти данные намного быстрее. Именно поэтому доступ к информации становится частью самого продукта, а не просто настройкой безопасности где-то в админке.
Хороший AI в CRM должен знать достаточно, чтобы помочь. Но совсем не обязательно знать всё.
 Share