



The post has been translated automatically. Original language: Russian




Artificial intelligence has dramatically changed the programming process itself. Today, you can describe a task in ordinary language and get a function, module, database query, tests, or even a significant part of the application in a few seconds.
It really speeds up the work. But at the same time, a new problem arises: the code can now be produced faster than a person can understand the system.
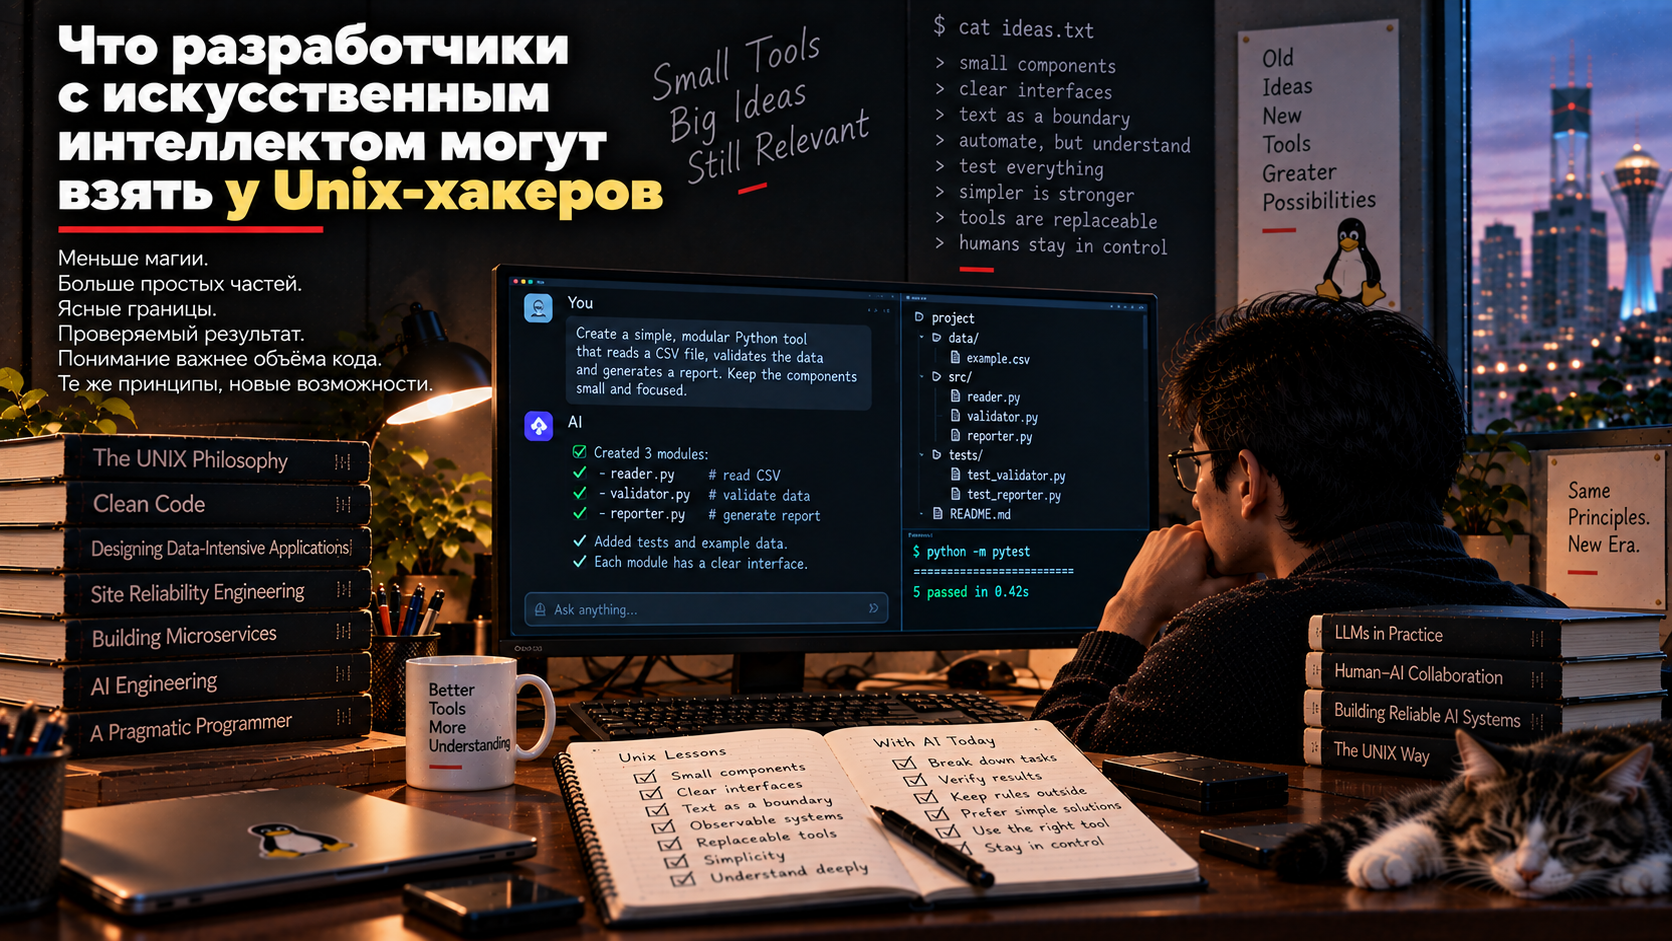
That's why the old Unix ideas suddenly become especially useful. The hackers of the sixties, seventies, and eighties knew nothing about language models, but many of their engineering habits are very well suited for artificial intelligence development.
It has become cheaper to write code
Previously, complexity at least had a natural price. To add another layer, class, library, or subsystem, the programmer had to write this code himself.
Today, the cost of code production has dropped dramatically. You can ask artificial intelligence to add a new level of abstraction, handle another case, or rebuild multiple files at the same time.
A minute later, a solution appears that would have taken an hour or a day before.
But the cost of understanding the code has hardly changed.
A person still needs to figure out what exactly was created, what dependencies appeared, where the boundaries of the components are located, and why the system now works the way it does.
Therefore, the main deficit today is no longer a code.
The main deficit is understanding.
Divide the task into small parts
One of the main lessons of Unix is that small components are easier to understand, test, and connect.
This works especially well with artificial intelligence.
You can ask the model: "Make an authorization system." But this is too big a task. This formulation hides user storage, password verification, session creation, access rights, account recovery, logging, and dozens of other solutions.
It is much more reliable to divide the work.
First, determine what exactly each component should do. Then give each part a clear input and output. And after that, assign artificial intelligence to write the implementation.
The smaller the task, the easier it is to verify the answer.
Don't ask to write the whole system at once
Artificial intelligence often creates large amounts of code very convincingly. The files look logical, the names are reasonable, and the comments are correct.
Because of this, there is a false feeling that the architecture has also turned out well.
But the model can make many locally reasonable decisions that together create a complex system. One component knows too much about the other, logic is duplicated, data goes through unnecessary transformations, and errors are hidden behind several levels of abstraction.
The larger the task, the more difficult it is for a person to notice such problems.
The Unix approach offers almost the opposite strategy: to build a large system from parts whose structure can be explained separately.
Each component must have a clear purpose.
Before asking artificial intelligence to write code, it's useful to answer a simple question: what one thing should this component do?
If the answer takes several paragraphs, it is possible that the border is poorly chosen.
For example, a component may be responsible for reading a file. The other is for checking the data structure. The third one is for saving the result.
Each part individually looks limited. But that's exactly what's good.
It is easier for artificial intelligence to create a small, understandable component. It is easier for the developer to check it. And later it is easier to replace it.
Getting in and out is more important than a beautiful code
When artificial intelligence writes code, the developer easily begins to evaluate it by its appearance.
Beautiful names. Neat classes. Good comments.
But something else is more important: what does the component get and what does it return?
If the boundary is clear, the internal implementation can be changed. One tool wrote the code today, another tomorrow. One library is in use today, and another one a year later.
As long as the entry and exit agreement is maintained, the system remains manageable.
This is very close to Unix, where a program is valuable not because others know its internal structure, but because it predictably accepts data and outputs a result.
Artificial intelligence doesn't have to know everything.
The more context we give the model, the smarter it seems to work.
Therefore, there is a desire to give her the entire project: the source code, documentation, architecture, requirements, and revision history, and then ask her to fix the problem.
Sometimes it's justified.
But as the main way of development, this approach is dangerous. If artificial intelligence needs to understand the entire system in order to change a small function, this may be a sign that the architecture itself is too connected.
A good border reduces the necessary context.
To change a component, it is enough to know its purpose, interface, and several neighboring conventions.
This is useful not only for the model. A person needs the same thing.
A verifiable result is more important than a plausible one
Language models are good at generating plausible code.
But plausible and correct are not the same thing.
Therefore, the task should have a verifiable result whenever possible. The function must pass the tests. The data transformation should have a clear example of input and expected output. The error must be reproduced.
The clearer the verification, the less you have to trust the model.
Instead of ""does this look like the right code?", a much better question appears: "does the component fulfill the specified contract?"
Unix culture has always valued tools whose behavior can be directly tested.
This becomes even more important for working with artificial intelligence.
Don't let the model endlessly finish building the architecture
There is a typical scenario. There is a small problem, artificial intelligence offers a new abstraction. Then another auxiliary structure appears for this abstraction. Then there is a separate management class.
After a while, the system becomes significantly larger, although the initial task was small.
The model does not experience fatigue from writing additional code. For her, three more files are almost worthless.
They are expensive for humans.
Each new component needs to be understood, maintained, and considered for future changes.
Therefore, it is useful to ask one more question: is it possible to solve the problem by existing means?
Sometimes the best code is the one that didn't have to be added.
The text becomes a good border again
Unix has made plain text a universal way to interact between programs.
This is especially interesting today because language models also work best with text.
The source code, documentation, settings, logs, rules, and task descriptions can all be read directly by artificial intelligence.
Therefore, systems with clear text borders are often easier to use together with artificial intelligence.
If important knowledge is hidden inside a complex closed format, the model requires a special tool. If it is presented in a clear text, you can work with it almost immediately.
The old Unix principle suddenly gets a new field of application.
Don't hide the rules inside the conversation
There is a new danger.
The developer explains an important rule to the model. The model writes the code. After a week, the conversation is forgotten, and the rule remains only in the resulting implementation.
Then comes the next conversation and another rule.
In this way, the system gradually accumulates knowledge, the source of which is already difficult to restore.
It's better when important rules exist separately from individual conversations with artificial intelligence.
This can be documentation, architecture description, verifiable constraints, tests, or other explicit data.
Then the model uses knowledge, but it does not become the only place where this knowledge exists.
Artificial intelligence should be a replaceable tool
A Unix hacker usually appreciates a tool that can be replaced with another one without rebuilding the entire system.
The same principle is useful here.
If the architecture is completely dependent on the features of one model, one supplier, or one If there is no way to communicate with the model, the system becomes fragile.
It is better to consider artificial intelligence as one of the components.
It receives understandable data, performs the task, and returns the result.
Today, this component can use a single model. Another one tomorrow. In some cases, a regular algorithm may appear instead of a model altogether.
The less the rest of the system knows about the internal structure of artificial intelligence, the easier it will survive technology changes.
Do not use artificial intelligence where a simple program is sufficient.
The language model seems to be a universal tool. Therefore, it is tempting to apply it even to tasks that have long been reliably solved by ordinary code.
But if the rule can be expressed by a simple function, the function is often better.
If you need to sort the numbers accurately, there is no point in asking the language model for this. If the date format is known, it is better to check it using the usual algorithm. If the rule is formal and unambiguous, deterministic code gives a more predictable result.
Artificial intelligence is especially useful where you need to work with human language, ambiguity, a lot of context, or difficult-to-formalize knowledge.
A good architecture uses the strengths of each tool.
A person must understand the assembled system.
Artificial intelligence can write a significant part of the program, but the responsibility for architecture still remains with humans.
This does not mean that you need to personally remember every line of code.
But the developer must understand the main components, the movement of data, the key dependencies and the reasons for important decisions.
If the system is working, but no one can draw its device on the blackboard, this is an alarming sign.
The faster artificial intelligence creates code, the more often it is useful to stop and explain to yourself again what happened.
Simplicity becomes a competitive advantage
Before the advent of artificial intelligence, programmers often struggled with time constraints.
Now, more and more often, we have to deal with an abundance of opportunities.
You can quickly add a feature, integration, additional mode, or a new layer.
But the system does not benefit from the amount of code written.
It benefits from how well it can be understood and changed.
Therefore, simplicity becomes even more valuable.
Not because we can write less code now.
It's because we can write too much too easily.
Unix hackers have left a useful habit
Old Unix hackers worked with machines that were incomparably weaker than modern ones. Memory was expensive, processors were slow, and the network was limited.
Today, the problem is almost the opposite. There are a lot of computing resources, a lot of ready-made libraries, and artificial intelligence is able to produce code almost instantly.
But the basic engineering issue remained the same.
Is it possible to understand the system?
Is it possible to divide it into clear parts?
Is it possible to replace one tool with another?
Is it possible to check the result?
Is it possible to solve the problem easier?
It is these questions that make the old Unix philosophy surprisingly modern.
Artificial intelligence has made programming faster.
Therefore, today it is especially important not only to be able to write code, but to be able not to create unnecessary complexity.
Искусственный интеллект резко изменил сам процесс программирования. Сегодня можно описать задачу обычным языком и за несколько секунд получить функцию, модуль, запрос к базе, тесты или даже значительную часть приложения.
Это действительно ускоряет работу. Но одновременно возникает новая проблема: код теперь можно производить быстрее, чем человек успевает понимать систему.
Именно поэтому старые идеи Unix неожиданно становятся особенно полезными. Хакеры шестидесятых, семидесятых и восьмидесятых годов ничего не знали о языковых моделях, но многие их инженерные привычки очень хорошо подходят для разработки с искусственным интеллектом.
Код стало писать дешевле
Раньше сложность хотя бы имела естественную цену. Чтобы добавить ещё один слой, класс, библиотеку или подсистему, программист должен был написать этот код сам.
Сегодня стоимость производства кода резко снизилась. Можно попросить искусственный интеллект добавить новый уровень абстракции, обработать ещё один случай или перестроить несколько файлов одновременно.
Через минуту появляется решение, на которое раньше ушёл бы час или день.
Но стоимость понимания кода почти не изменилась.
Человеку всё равно нужно разобраться, что именно было создано, какие зависимости появились, где находятся границы компонентов и почему система теперь работает именно так.
Поэтому главный дефицит сегодня — уже не код.
Главный дефицит — понимание.
Делить задачу на маленькие части
Один из основных уроков Unix состоит в том, что небольшие компоненты легче понимать, проверять и соединять.
Это особенно хорошо работает с искусственным интеллектом.
Можно попросить модель: «Сделай систему авторизации». Но это слишком большая задача. Под такой формулировкой скрываются хранение пользователей, проверка паролей, создание сеанса, права доступа, восстановление учётной записи, журналирование и десятки других решений.
Гораздо надёжнее разделить работу.
Сначала определить, что именно должен делать каждый компонент. Затем дать каждой части понятный вход и выход. И уже после этого поручать искусственному интеллекту писать реализацию.
Чем меньше задача, тем легче проверить ответ.
Не просить написать всю систему сразу
Искусственный интеллект часто очень убедительно создаёт большие объёмы кода. Файлы выглядят логично, названия разумны, комментарии правильные.
Из-за этого возникает ложное ощущение, что архитектура тоже получилась хорошей.
Но модель может сделать много локально разумных решений, которые вместе создают сложную систему. Один компонент знает слишком много о другом, логика дублируется, данные проходят через лишние преобразования, а ошибки скрываются за несколькими уровнями абстракции.
Чем больше задача, тем труднее человеку заметить такие проблемы.
Unix-подход предлагает почти противоположную стратегию: строить большую систему из частей, устройство которых можно объяснить отдельно.
Каждый компонент должен иметь ясное назначение
Перед тем как просить искусственный интеллект написать код, полезно ответить на простой вопрос: какую одну вещь должен делать этот компонент?
Если ответ занимает несколько абзацев, возможно, граница выбрана плохо.
Например, компонент может отвечать за чтение файла. Другой — за проверку структуры данных. Третий — за сохранение результата.
Каждая часть по отдельности выглядит ограниченной. Но именно это и хорошо.
Искусственному интеллекту проще создать небольшой понятный компонент. Разработчику проще его проверить. А позже его проще заменить.
Вход и выход важнее красивого кода
Когда искусственный интеллект пишет код, разработчик легко начинает оценивать его по внешнему виду.
Красивые имена. Аккуратные классы. Хорошие комментарии.
Но важнее другое: что компонент получает и что возвращает?
Если граница ясна, внутреннюю реализацию можно менять. Сегодня код написал один инструмент, завтра другой. Сегодня используется одна библиотека, через год другая.
Пока сохраняется договор о входе и выходе, система остаётся управляемой.
Это очень близко к Unix, где программа ценна не потому, что окружающие знают её внутреннее устройство, а потому, что она предсказуемо принимает данные и выдаёт результат.
Искусственный интеллект не должен знать всё
Чем больше контекста мы передаём модели, тем умнее кажется её работа.
Поэтому возникает желание дать ей весь проект: исходный код, документацию, архитектуру, требования, историю изменений и затем попросить исправить проблему.
Иногда это оправданно.
Но как основной способ разработки такой подход опасен. Если для изменения небольшой функции искусственному интеллекту нужно понимать всю систему, это может быть признаком слишком сильной связанности самой архитектуры.
Хорошая граница уменьшает необходимый контекст.
Чтобы изменить компонент, достаточно знать его назначение, интерфейс и несколько соседних соглашений.
Это полезно не только для модели. То же самое нужно и человеку.
Проверяемый результат важнее правдоподобного
Языковые модели хорошо генерируют правдоподобный код.
Но правдоподобный и правильный — не одно и то же.
Поэтому задача должна по возможности иметь проверяемый результат. Функция должна проходить тесты. Преобразование данных должно иметь понятный пример входа и ожидаемого выхода. Ошибка должна воспроизводиться.
Чем яснее проверка, тем меньше приходится доверять модели.
Вместо вопроса «похоже ли это на правильный код?» появляется гораздо лучший вопрос: «выполняет ли компонент заданный договор?»
Unix-культура всегда ценила инструменты, поведение которых можно непосредственно проверить.
Для работы с искусственным интеллектом это становится ещё важнее.
Не позволять модели бесконечно достраивать архитектуру
Есть типичный сценарий. Возникает небольшая проблема, искусственный интеллект предлагает новую абстракцию. Затем для этой абстракции появляется ещё одна вспомогательная структура. Потом отдельный управляющий класс.
Через некоторое время система становится значительно больше, хотя исходная задача была небольшой.
Модель не испытывает усталости от написания дополнительного кода. Для неё ещё три файла почти ничего не стоят.
Для человека они стоят дорого.
Каждый новый компонент нужно понимать, поддерживать и учитывать при следующих изменениях.
Поэтому полезно задавать ещё один вопрос: можно ли решить проблему уже существующими средствами?
Иногда лучший код — тот, который не пришлось добавлять.
Текст снова становится хорошей границей
Unix сделал обычный текст универсальным способом взаимодействия между программами.
Сегодня это особенно интересно, потому что языковые модели тоже лучше всего работают именно с текстом.
Исходный код, документация, настройки, журналы, правила, описания задач — всё это искусственный интеллект может читать непосредственно.
Поэтому системы с ясными текстовыми границами часто легче использовать вместе с искусственным интеллектом.
Если важное знание спрятано внутри сложного закрытого формата, модели требуется специальный инструмент. Если оно представлено в понятном тексте, с ним можно работать почти сразу.
Старый Unix-принцип неожиданно получает новую область применения.
Не прятать правила внутри разговора
Есть и новая опасность.
Разработчик объясняет модели важное правило. Модель пишет код. Через неделю разговор забыт, а правило остаётся только в получившейся реализации.
Затем появляется следующий разговор и ещё одно правило.
Так система постепенно накапливает знания, источник которых уже трудно восстановить.
Лучше, когда важные правила существуют отдельно от отдельных разговоров с искусственным интеллектом.
Это может быть документация, описание архитектуры, проверяемые ограничения, тесты или другие явные данные.
Тогда модель использует знание, но не становится единственным местом, где это знание существует.
Искусственный интеллект должен быть заменяемым инструментом
Unix-хакер обычно ценит инструмент, который можно заменить другим без перестройки всей системы.
Тот же принцип полезен и здесь.
Если архитектура полностью зависит от особенностей одной модели, одного поставщика или одного способа общения с моделью, система становится хрупкой.
Лучше рассматривать искусственный интеллект как один из компонентов.
Он получает понятные данные, выполняет задачу и возвращает результат.
Сегодня этот компонент может использовать одну модель. Завтра другую. В некоторых случаях вместо модели вообще может появиться обычный алгоритм.
Чем меньше остальная система знает о внутреннем устройстве искусственного интеллекта, тем легче она переживёт изменения технологий.
Не использовать искусственный интеллект там, где достаточно простой программы
Языковая модель кажется универсальным инструментом. Поэтому возникает соблазн применять её даже к задачам, которые давно и надёжно решаются обычным кодом.
Но если правило можно выразить простой функцией, функция часто лучше.
Если нужно точно отсортировать числа, нет смысла просить об этом языковую модель. Если известен формат даты, его лучше проверять обычным алгоритмом. Если правило формально и однозначно, детерминированный код даёт более предсказуемый результат.
Искусственный интеллект особенно полезен там, где нужно работать с человеческим языком, неоднозначностью, большим количеством контекста или трудно формализуемыми знаниями.
Хорошая архитектура использует сильную сторону каждого инструмента.
Человек должен понимать собранную систему
Искусственный интеллект может написать значительную часть программы, но ответственность за архитектуру всё равно остаётся у человека.
Это не значит, что нужно лично помнить каждую строку кода.
Но разработчик должен понимать основные компоненты, движение данных, ключевые зависимости и причины важных решений.
Если система работает, но никто не может нарисовать её устройство на доске, это тревожный признак.
Чем быстрее искусственный интеллект создаёт код, тем чаще полезно останавливаться и снова объяснять самому себе, что получилось.
Простота становится конкурентным преимуществом
До появления искусственного интеллекта программисты часто боролись с нехваткой времени.
Теперь всё чаще приходится бороться с избытком возможностей.
Можно очень быстро добавить функцию, интеграцию, дополнительный режим или новый слой.
Но система выигрывает не от количества написанного кода.
Она выигрывает от того, насколько хорошо её можно понимать и изменять.
Поэтому простота становится ещё ценнее.
Не потому, что мы теперь можем писать меньше кода.
А потому, что мы можем слишком легко написать слишком много.
Unix-хакеры оставили полезную привычку
Старые Unix-хакеры работали с машинами, которые были несравнимо слабее современных. Память была дорогой, процессоры медленными, сеть ограниченной.
Сегодня проблема почти противоположная. Вычислительных ресурсов много, готовых библиотек много, а искусственный интеллект способен производить код почти мгновенно.
Но базовый инженерный вопрос остался тем же.
Можно ли понять систему?
Можно ли разделить её на ясные части?
Можно ли заменить один инструмент другим?
Можно ли проверить результат?
Можно ли решить задачу проще?
Именно эти вопросы делают старую философию Unix удивительно современной.
Искусственный интеллект сделал программирование быстрее.
Поэтому сегодня особенно важно не просто уметь писать код, а уметь не создавать лишнюю сложность.

 Share








