
The post has been translated automatically. Original language: Russian



What happens when a managed system is it getting so big and complex that splitting into separate subsystems is no longer enough?
This particular issue was investigated in one of the most ambitious experiments of the CONTOUR — Recursive-Fractal Multicontour Topology project .
The task was to test the multi -level management architecture, where a huge number of devices simultaneously participate in various processes, causal relationships arise between levels, competing impacts, failures and recovery.
How did the experiment go?
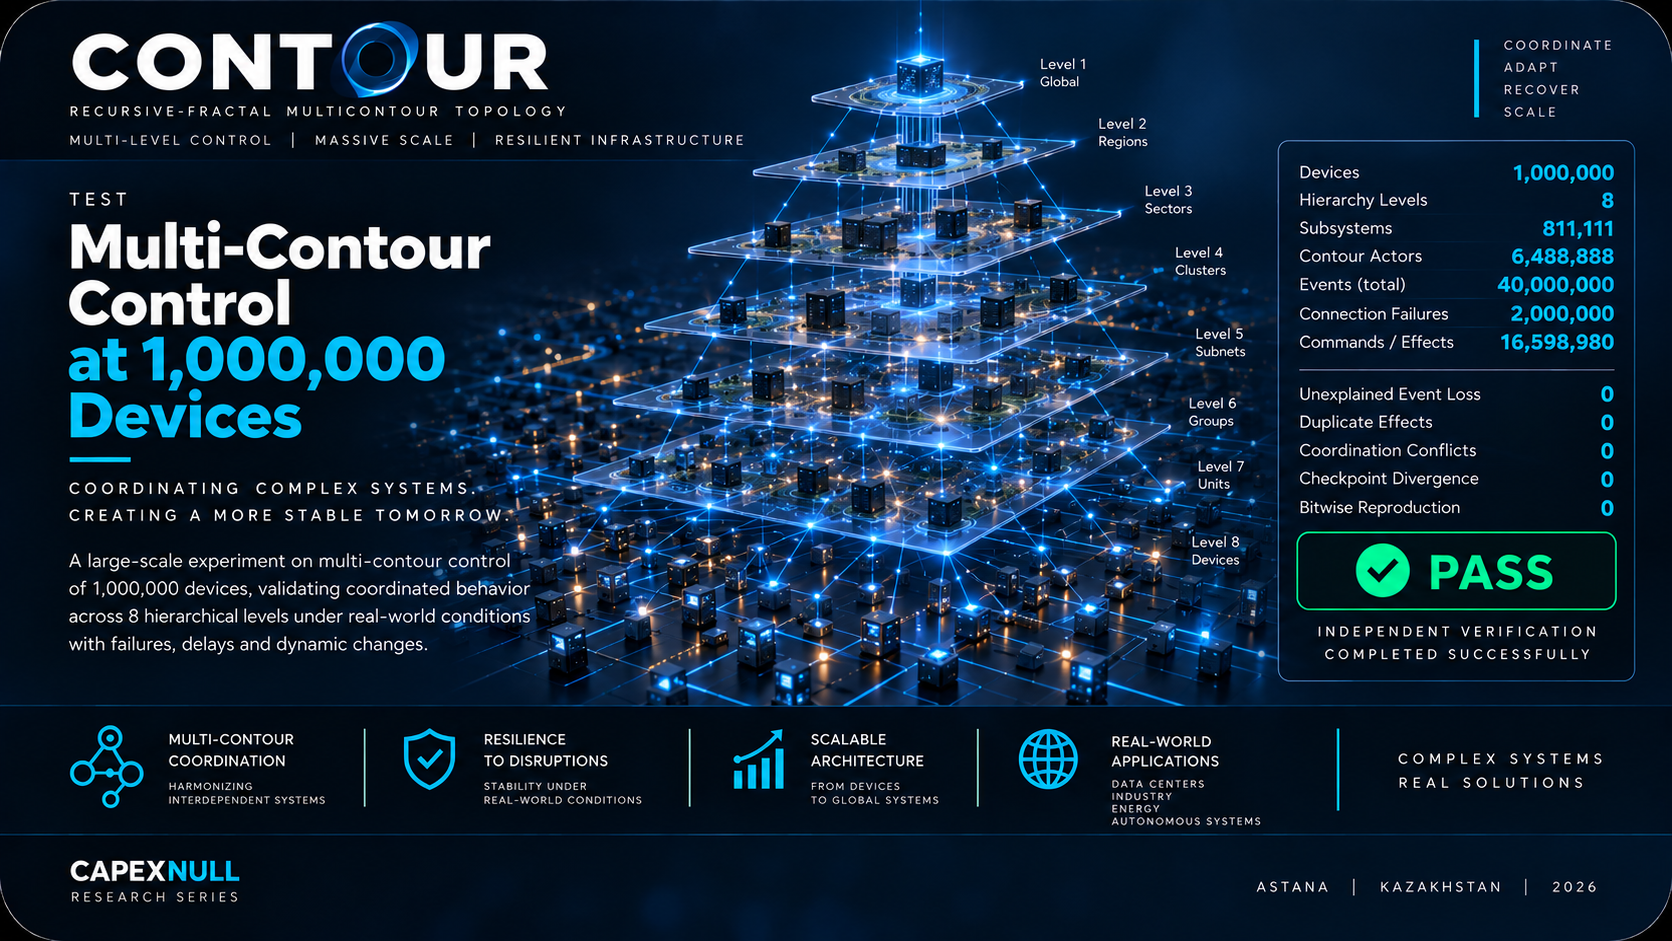
The test simulated a system of:
1,000,000 devices.
8 levels of hierarchy.
811,111 subsystems of different hierarchy levels.
6,488,888 contour actors — 8 contours for each subsystem.
The system processed 40,000,000 events in 40 clock cycles .
Each of the 40,000,000 initial events has gone through a full processing cycle: analysis and terminal processing. Thus, the number of initial, analyzed , and terminal events was 40,000,000 each.
Additionally, delays, jitter, reordering of delivery, data duplication, and communication disruptions were simulated.
A total of 2,000,000 communication disruptions were created .
What was happening inside the system
The test included device and circuit competition, causal relationships between levels, cascading failures, partial recovery, re -degradation, and global recovery.
As a result, the system generated and executed 16,598,980 commands and the same number of effects.
At the same time:
Unexplained loss of events — 0;
duplicated effects — 0;
coordination conflicts — 0;
control point discrepancies — 0;
discrepancies in bitwise reproduction are 0.
Independent full playback — PASS.
Efficiency
The total time of the experiment was 30.675 seconds.
Measured performance — 1 303,985 events per second.
The maximum memory consumption is about 760 MiB.
The final test result is a PASS.
Have similar experiments been conducted before?
The millionth scale is found in research on distributed computing systems, networks, infrastructure , and other large systems.
However, the scale itself is only one characteristic of the experiment.
In the search for a direct published analogue of this experimental protocol, we found So far, it has failed: 1,000,000 managed devices, 8 levels of hierarchy, millions of contour actors, inter -level causality, contour competition, cascading failures, recovery and deterministic control of results within a single test.
What are such systems for?
Modern infrastructure is gradually turning from a set of individual machines into huge interconnected dynamic systems.
Data centers.
Energy networks.
Industrial complexes.
Telecommunication infrastructure.
Cloud platforms.
Autonomous transport systems.
Robotic complexes.
Millions of IoT devices.
In such systems, a solution that is optimal for one circuit may degrade the performance of the other circuit or the system as a whole.
Therefore, scaling the number of devices solves only part of the problem.
It requires the ability to coordinate the interaction between the levels of the system, take into account causal relationships, survive violations and restore a consistent state.
This is exactly what this experiment was testing. CONTOUR.
What's next
In previous posts, I talked about Pers_A, an artificial personality capable of acquiring its own experience and shaping individual behavior.
Today it's a completely different scale.
1,000,000 devices.
40,000,000 events.
8 levels of hierarchy.
6,488,888 contour actors.
2,000,000 communication failures.
0 unexplained losses.
And this is just one of the areas of CAPEXNULL's research.
Next up are DATACENTER and DELIVERY.
And then we'll go back to Pers_A again.
The information avalanche is just beginning!
Что происходит, когда управляемая система становится настолько большой и сложной, что разделения на отдельные подсистемы уже недостаточно?
Именно этот вопрос исследовался в одном из наиболее масштабных экспериментов проекта CONTOUR — Recursive-Fractal Multicontour Topology (рекурсивно-фрактальная многоконтурная топология).
Задача состояла в проверке многоуровневой архитектуры управления, где огромное количество устройств одновременно участвует в различных процессах, между уровнями возникают причинные связи, конкурирующие воздействия, отказы и восстановление.
Как проходил эксперимент
В испытании моделировалась система из:
1 000 000 устройств.
8 уровней иерархии.
811 111 подсистем разных уровней иерархии.
6 488 888 контурных акторов — по 8 контуров на каждую подсистему.
За 40 тактов система обработала 40 000 000 событий.
Каждое из 40 000 000 исходных событий прошло полный цикл обработки: анализ и терминальную обработку. Таким образом, количество исходных, проанализированных и терминальных событий составило по 40 000 000.
Дополнительно моделировались задержки, джиттер, изменение порядка доставки, дублирование данных и разрывы связи.
Всего было создано 2 000 000 нарушений связи.
Что происходило внутри системы
Испытание включало конкуренцию устройств и контуров, причинные связи между уровнями, каскадные отказы, частичное восстановление, повторную деградацию и глобальное восстановление.
В результате система сформировала и исполнила 16 598 980 команд и столько же эффектов.
При этом:
необъяснённые потери событий — 0;
дублированные эффекты — 0;
конфликты координации — 0;
расхождения контрольных точек — 0;
расхождения при побитовом воспроизведении — 0.
Независимое полное воспроизведение — PASS.
Производительность
Полное время выполнения эксперимента составило 30,675 секунды.
Измеренная производительность — 1 303 985 событий в секунду.
Максимальное потребление памяти — около 760 MiB.
Итоговый результат испытания — PASS.
Проводились ли подобные эксперименты раньше?
Миллионный масштаб встречается в исследованиях распределённых вычислительных систем, сетей, инфраструктуры и других крупных систем.
Однако сам масштаб — только одна характеристика эксперимента.
В проведённом поиске прямого опубликованного аналога данного экспериментального протокола обнаружить пока не удалось: 1 000 000 управляемых устройств, 8 уровней иерархии, миллионы контурных акторов, межуровневая причинность, конкуренция контуров, каскадные отказы, восстановление и детерминированный контроль результатов в рамках единого испытания.
Для чего нужны такие системы?
Современная инфраструктура постепенно превращается из набора отдельных машин в огромные взаимосвязанные динамические системы.
Дата-центры.
Энергетические сети.
Промышленные комплексы.
Телекоммуникационная инфраструктура.
Облачные платформы.
Автономные транспортные системы.
Робототехнические комплексы.
Миллионы IoT-устройств.
В таких системах решение, оптимальное для одного контура, может ухудшить работу другого контура или системы в целом.
Поэтому масштабирование количества устройств решает только часть задачи.
Требуется способность координировать взаимодействие между уровнями системы, учитывать причинные связи, переживать нарушения и восстанавливать согласованное состояние.
Именно это проверял данный эксперимент CONTOUR.
Что дальше
В предыдущих публикациях я рассказывал о Pers_A — искусственной личности, способной приобретать собственный опыт и формировать индивидуальное поведение.
Сегодня — совсем другой масштаб.
1 000 000 устройств.
40 000 000 событий.
8 уровней иерархии.
6 488 888 контурных акторов.
2 000 000 нарушений связи.
0 необъяснённых потерь.
И это лишь одно из направлений исследований CAPEXNULL.
Дальше — DATACENTER и DELIVERY.
А затем мы снова вернёмся к Pers_A.
Информационная лавина только начинается!
 Share