
The post has been translated automatically. Original language: Russian




Imagine AI using your product, finding what prevents it from achieving the intended result and helping fix those obstacles. Give it a task and a reference outcome, and each run can help improve the product for every user. Delegating repetitive checks to AI can also reduce testing costs and free professional testers to focus on complex cases.
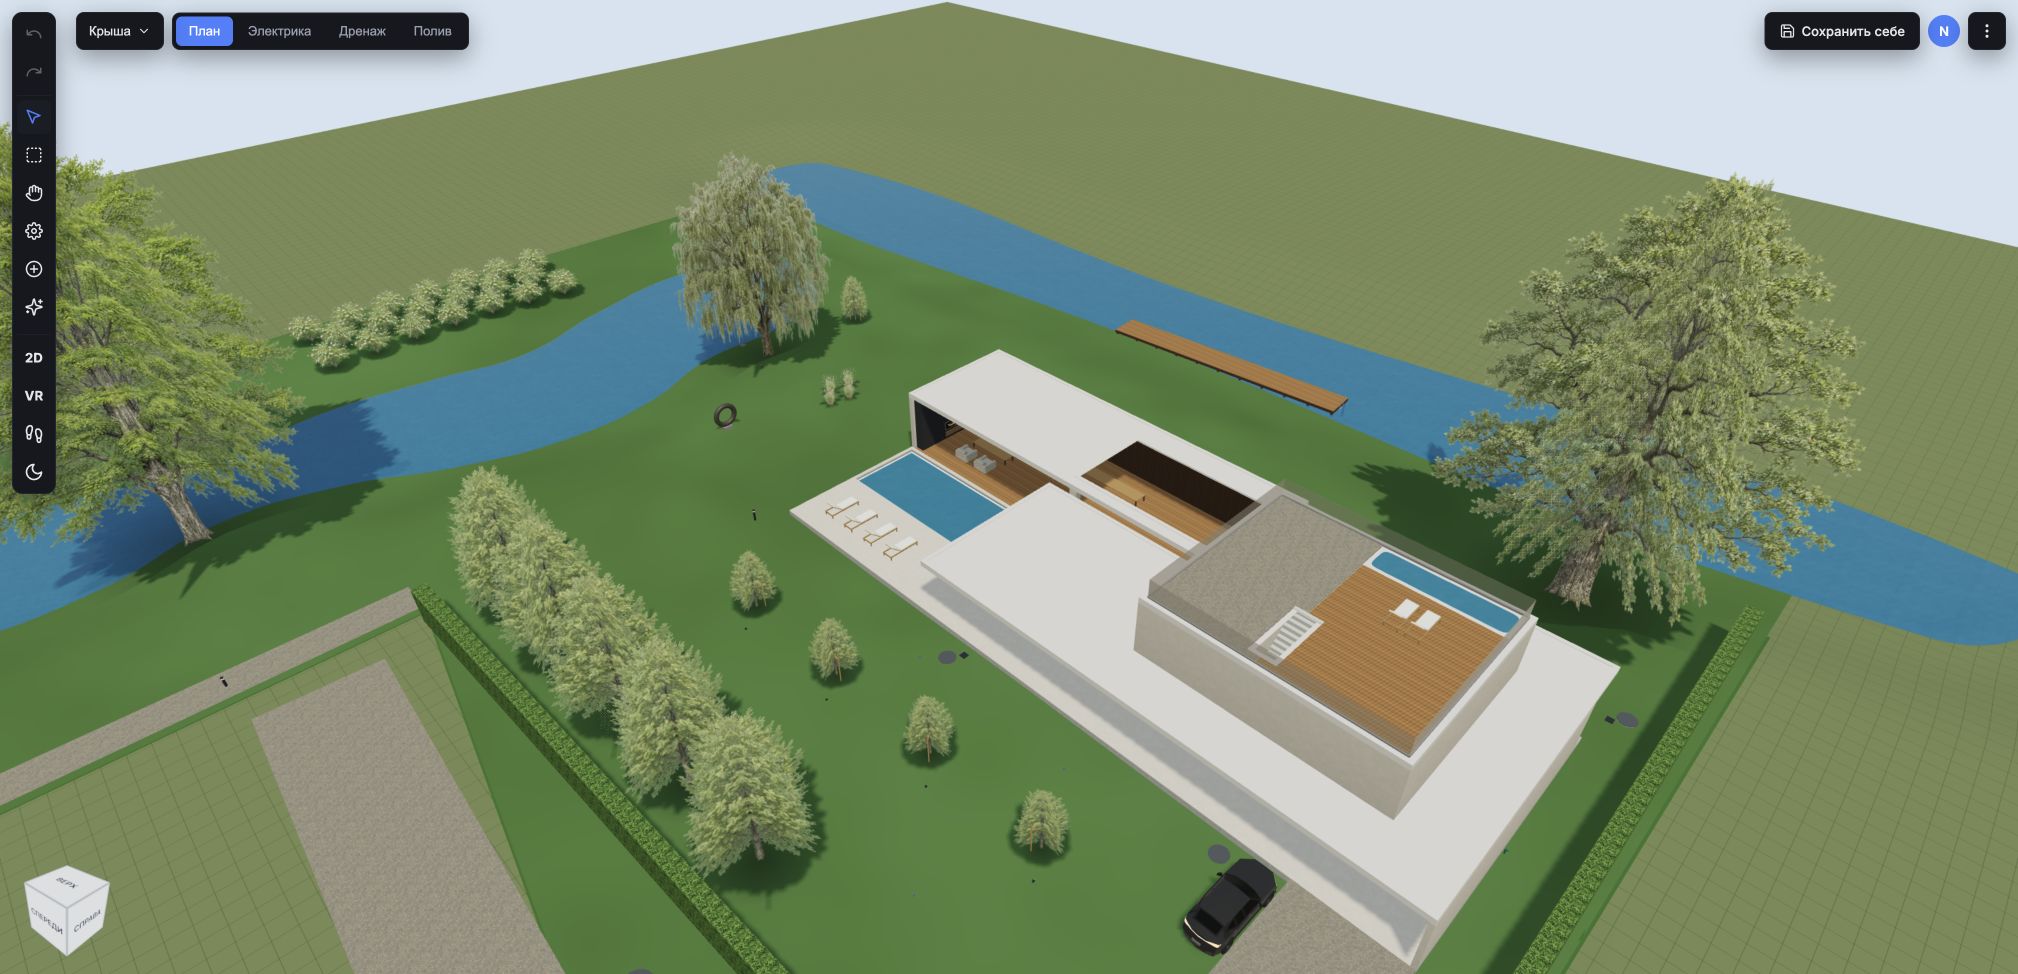
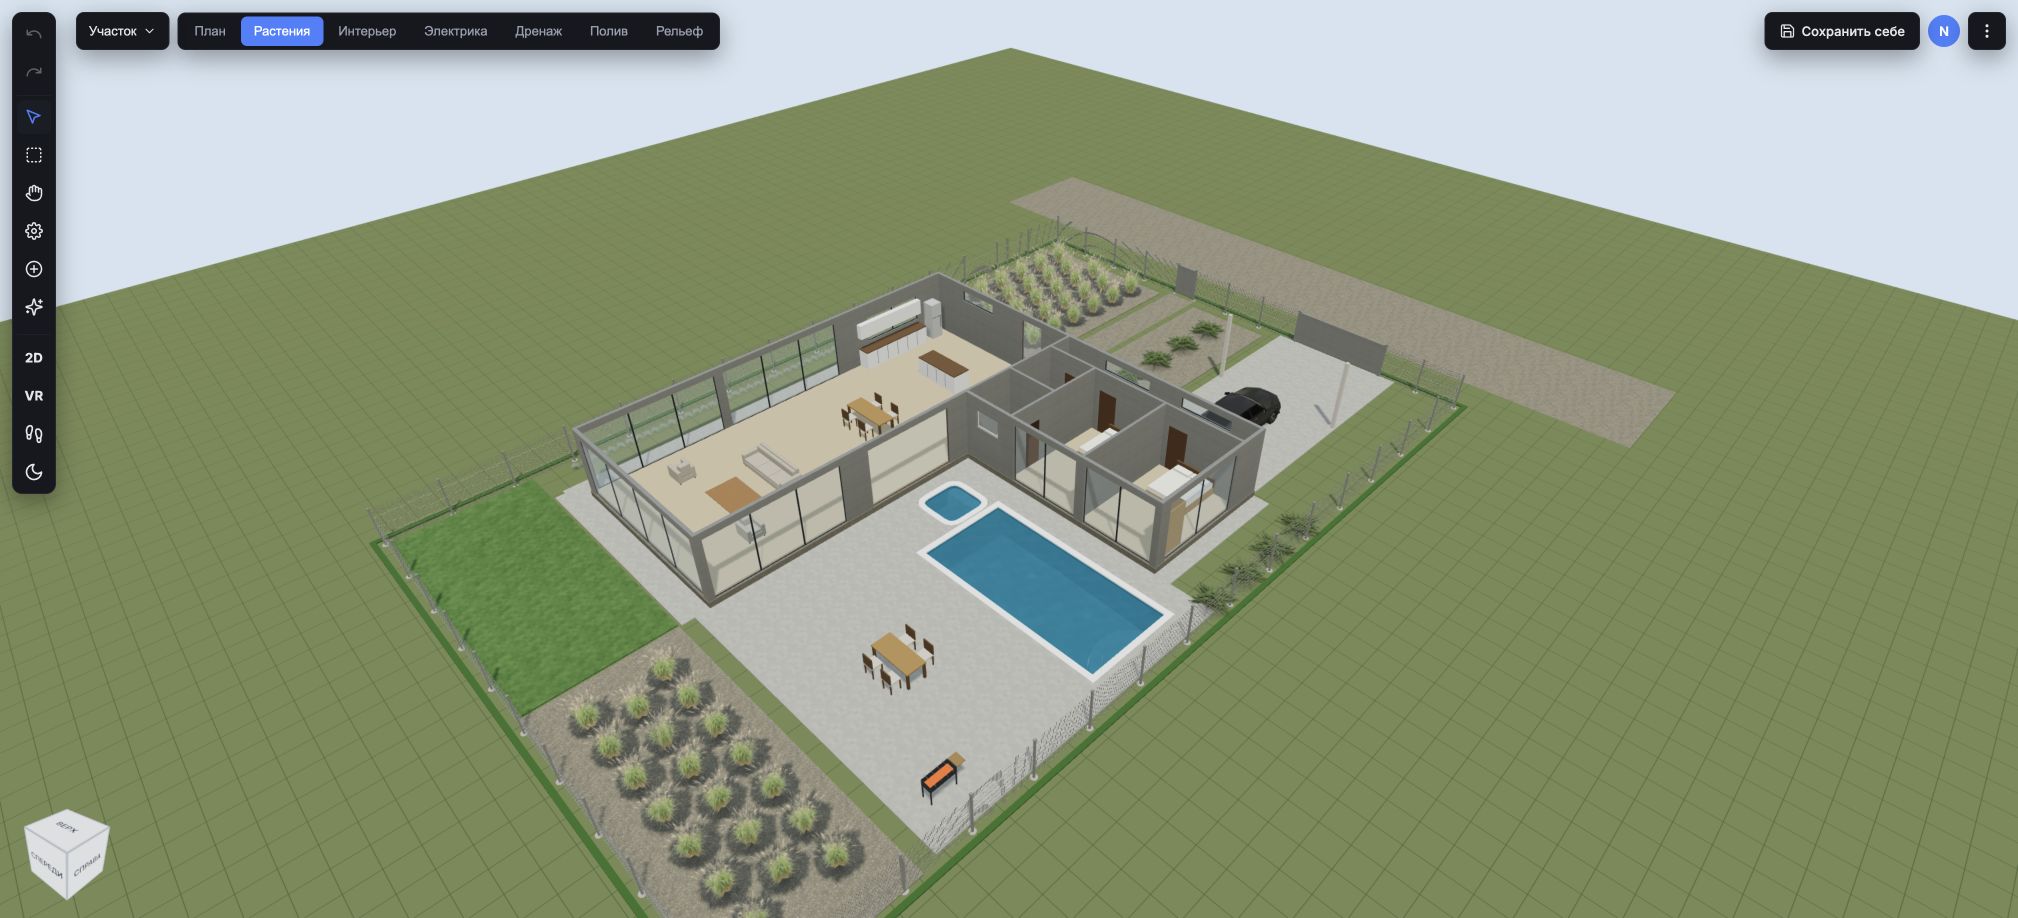
In Gardmi, we apply this approach to home design: an agent reconstructs houses from published plans and photographs. The outputs are a house model and a list of concrete improvements to the editor.
Three ingredients: a tool, input data and a reference
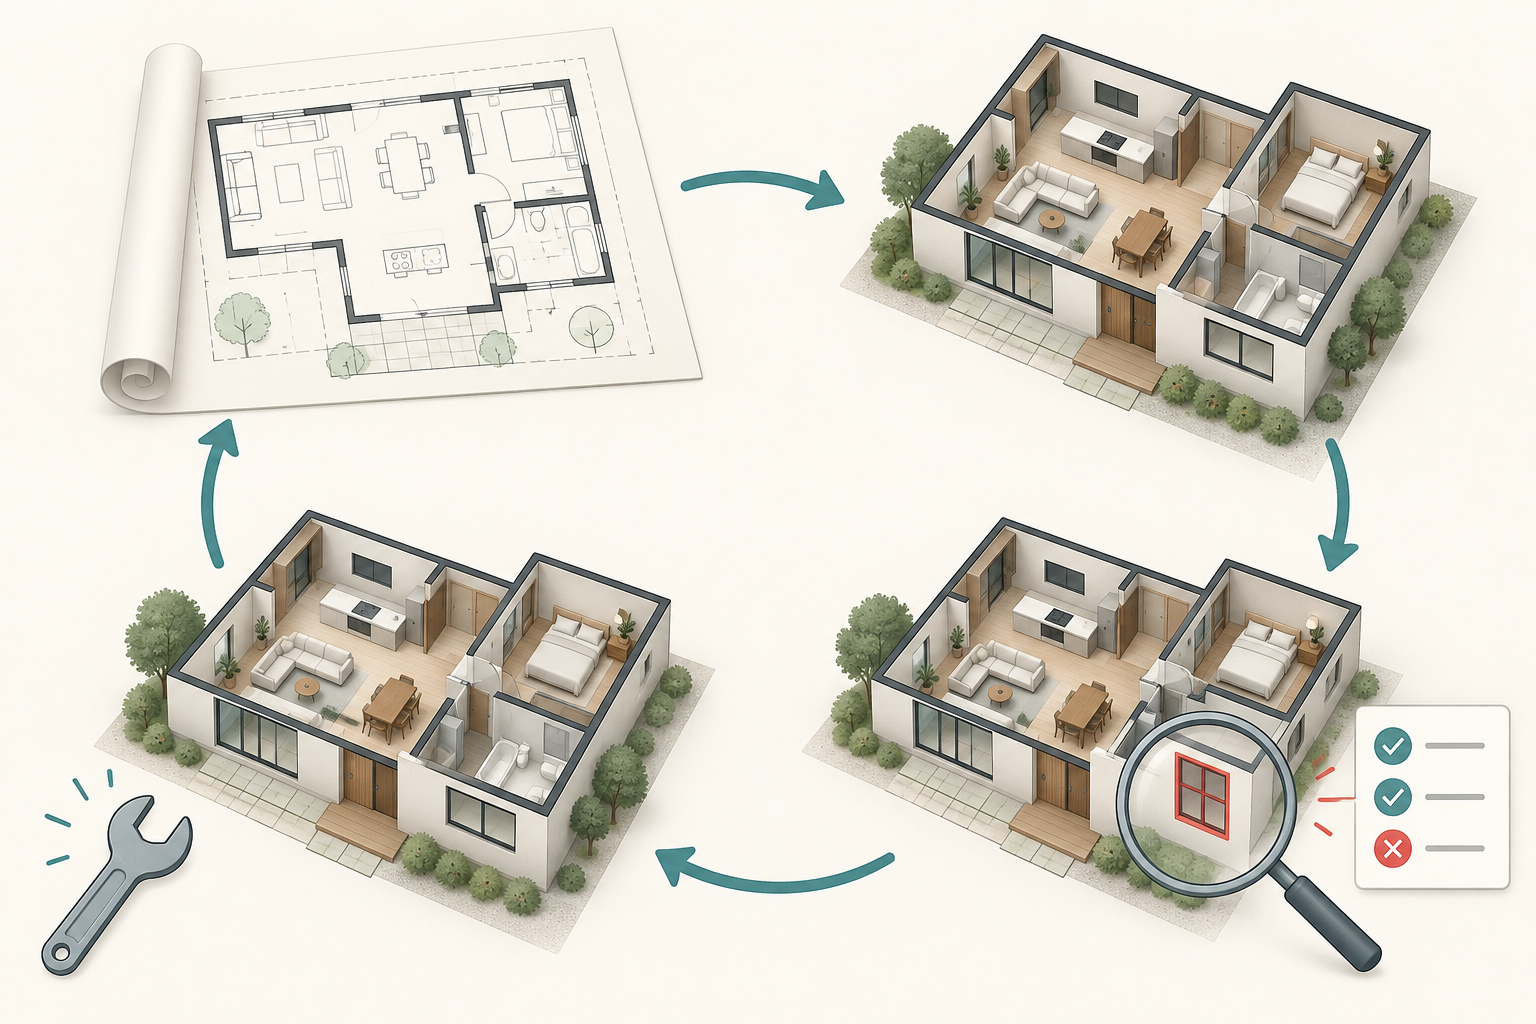
When an agent can use a tool, access input data and compare the outcome against a reference, a feedback loop becomes possible: perform the task → measure discrepancies → identify their causes → fix them → check again.
A reference might be a drawing, a spreadsheet with known totals, expected software behaviour or acceptance criteria. The essential property is verifiability. “Make it better” is vague; “every room has an entrance, dimensions match the plan and furniture does not intersect walls” provides a basis for testing.
A related pattern in agent systems is evaluator–optimizer: one step creates an output, while another evaluates it and returns feedback. Anthropic describes it as useful where clear criteria and iterative feedback can improve results. We extend the loop to include changes to the tool itself. Pattern description.

An architectural project becomes an editor test
For our scenarios, we choose published house designs with distinctive geometry: panoramic glazing, terraces, pools and changes in elevation. Reconstructing them requires combinations of editor capabilities that isolated button tests may miss.
Work begins with source analysis. The agent extracts dimensions and layout, separates confirmed information from assumptions, then builds a model using the editor's available operations. Photographs support appearance checks; plans support geometry checks. An unknown dimension remains an assumption: a photograph is not a measured survey.
The second output is a record of obstacles. These runs in Gardmi uncovered cases including:
- Panoramic glazing. The window creation operation lacked parameters for the required height. Extending the operation allowed the agent to express the intended geometry.
- Floor association. Where walls on different floors shared axes, a window could attach to a wall on the wrong floor. The fix changed the general wall selection mechanism.
- Furniture against walls. Wardrobes and beds were left with small unintended gaps. A shared snapping mechanism and furniture placement checks were introduced.
These are three different failure causes: insufficient tool expressiveness, incorrect behaviour and imprecise placement. Each needs a different response. Rephrasing a prompt will not fix an editor geometry bug; changing the editor will not help if the agent misread the source plan.
Two improvement loops
An inner loop corrects the individual project. An outer loop involves the team or a development agent improving the product and rerunning the scenarios.
The inner loop can move a wardrobe. The outer loop can improve furniture snapping so the same issue does not recur elsewhere. A discovery becomes especially valuable when it produces a regression test, checking that a previously resolved problem stays resolved.
A shared mechanism change must also be checked against earlier scenarios. Improving one house while breaking openings or exports in another is not a completed iteration. This resembles evaluation-driven development, where explicit quality criteria and tests guide changes. Agent systems benefit from combining code-based checks, model assessment and human expertise. Agent evaluation practice.
Why each room needs its own loop
What matters here is an informal “attention budget”: the model's ability to work through many details and reconcile them at once. This differs from context window size. All plans, photographs and requirements may fit into the input, yet the model may still miss some relationships. “Attention” here is a practical metaphor for thoroughness, not a separately measured model limit.
Image generation provides a useful analogy. A convincing portrait of one person does not mean a model will draw ten different people equally well, preserving each face, pose and spatial relationship. More independent requirements make it harder to satisfy each precisely: attributes may blend, while details repeat or become distorted. These problems are studied as compositional generation and attribute binding, for example in T2I-CompBench. This illustrates complexity; it does not claim that image generators and agents share the same failure mechanism.
With references, each image's role matters as well as the number of images. Several consistent viewpoints can clarify an object; photographs with different styles, details and unclear priorities can make the task harder. For each step, it helps to select the relevant plan fragment and photographs and specify what should be reproduced from each.
The same practical principle applies to home design: reduce the number of details an agent must reconcile in one step. Replace “furnish the entire house and check everything” with one room, its constraints, an outcome and a check. Each area receives its own refinement cycle.
In Gardmi, reconstructing one of the houses exposed the need for staged construction: geometry and room dimension discrepancies were discovered during final review, after windows, furniture and lighting had already been added. The pipeline was organised around dependencies: foundations and walls first, then openings, finishes, equipment and furniture. Stage checks let work stop before details accumulate on an incorrect foundation.
For furniture, this principle can be applied room by room:
- Give the agent the room outline, doors, windows, purpose and required furniture.
- Place major items with their dimensions and orientation in mind.
- Check intersections, access, door opening and agreement with the reference.
- Resolve findings and save the accepted result before moving to the next room.
Each room receives an explicit work and evaluation step. This is hierarchical decomposition: a project is divided into systems, then into local tasks. It helps allocate effort, though extra calls and checks may increase total cost. It is not a universal promise of faster or cheaper execution.
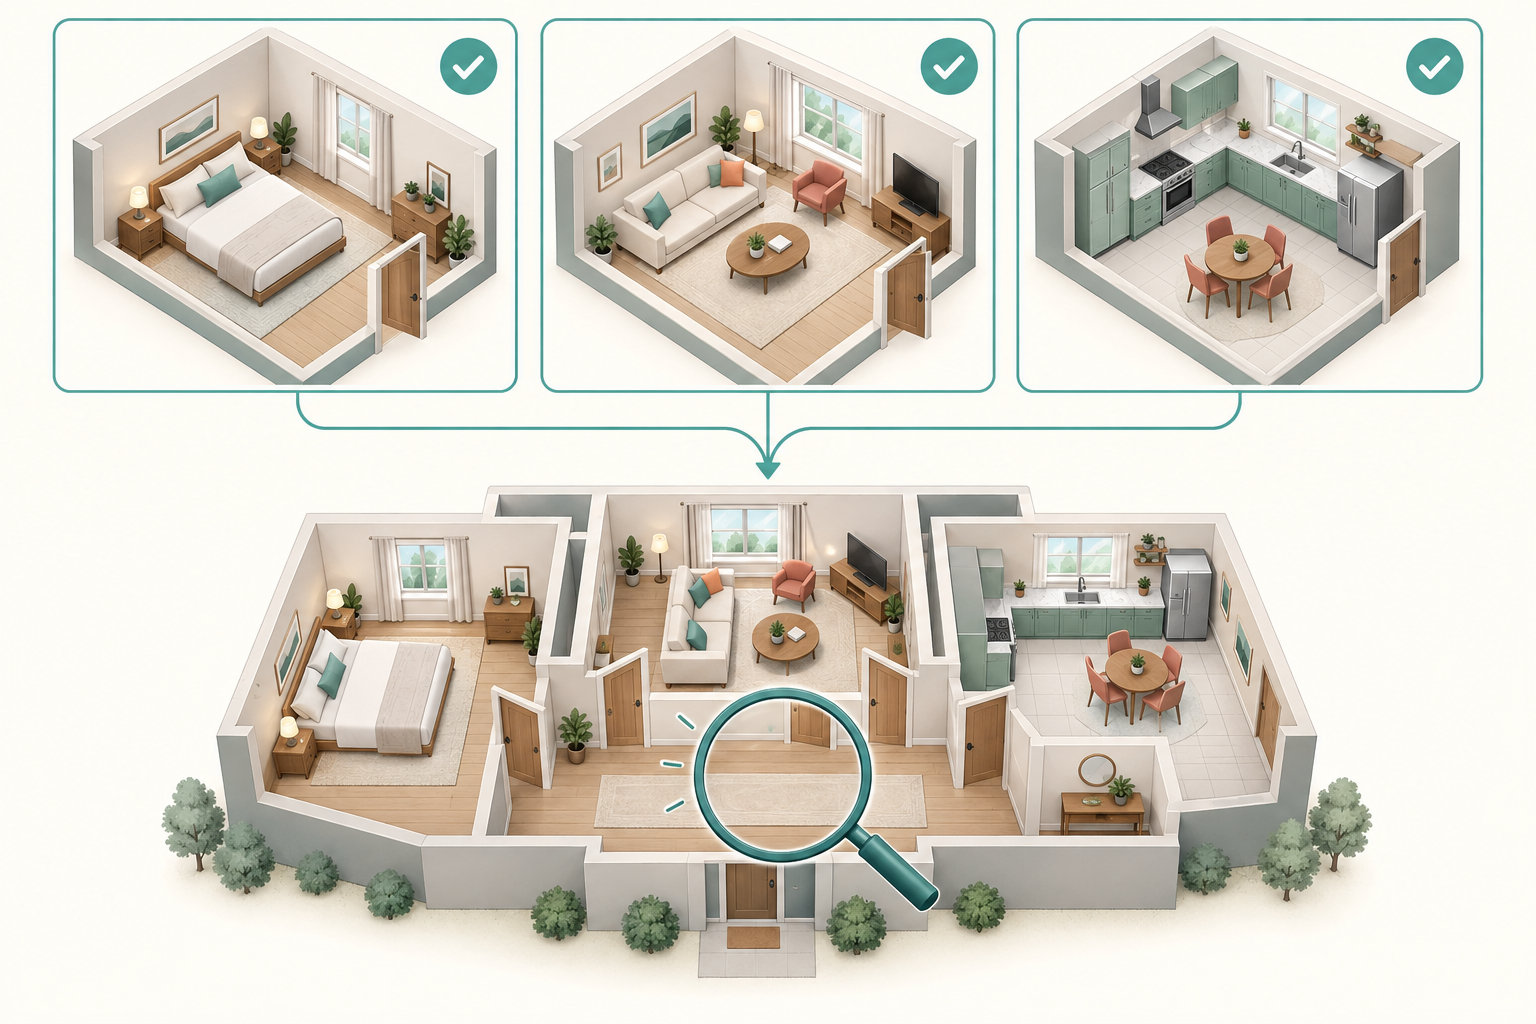
Local checks are followed by integration checks: passages between rooms, stairs between floors and overall dimensions must agree. Well-furnished rooms alone do not guarantee a usable house.
Making feedback useful
A reviewer needs concrete grounds for criticism. Dimensions and intersections are best checked computationally; appearance can be compared using images from similar viewpoints; ambiguous decisions need clear evaluation criteria and human input. One attractive screenshot does not establish that an entire model is correct.
An agent's self-report also cannot replace verification. In the reasoning tasks studied by Huang and colleagues, self-correction without external feedback sometimes reduced performance. This is not a claim that all modern models cannot self-correct, but a reason to rely on observable results. ICLR 2024 study.
It also helps to keep separate projects that have not been used to improve the tool. They reveal whether improvements transfer to new cases. Set criteria and iteration limits in advance: the loop should finish with a verified outcome or a clear account of remaining limitations.
The same approach applies beyond 3D: compare document layout with a reference, spreadsheet formulas and control totals with known results, or generated interfaces with designs and interaction scenarios. Its strength lies in accumulating reproducible evidence of what prevents users from completing their tasks. Each investigated case can improve the tool for the next task.
Представьте, что ИИ сам пользуется вашим продуктом, находит, что мешает получить нужный результат, и помогает это исправить. Если дать ему задачу и образец результата, каждый такой прогон может улучшать продукт для всех пользователей. А передача ИИ повторяющихся проверок может снизить затраты на тестирование и освободить время профессионального тестировщика для сложных случаев.
В Gardmi мы применяем этот подход к проектированию домов: агент воссоздаёт их по опубликованным планам и фотографиям. На выходе получаем модель дома и список конкретных улучшений редактора.
Три составляющие цикла: инструмент, исходные данные и эталон
Если агент умеет пользоваться инструментом, получает исходные данные и может сравнить результат с эталоном, появляется основа для замкнутого цикла обратной связи: выполнить задачу → измерить расхождения → установить причину → исправить → повторить проверку.
Эталоном может быть чертёж, таблица с известными итогами, ожидаемое поведение программы или набор критериев приёмки. Ключевое условие — проверяемость. Указание «сделай лучше» слишком расплывчато; требование «в каждой комнате есть вход, размеры соответствуют плану, мебель не пересекает стены» уже позволяет организовать проверку.
В агентных системах близкий шаблон называют evaluator–optimizer: один шаг создаёт результат, другой оценивает его и возвращает замечания. Anthropic описывает его как подход для задач с ясными критериями и полезной итеративной обратной связью. Здесь мы расширяем цикл: по результатам проверки меняется и сам инструмент. Описание подхода.
Когда архитектурный проект становится тестом редактора
Для наших сценариев мы выбираем опубликованные проекты домов с выразительной геометрией: панорамные окна, террасы, бассейны, перепады уровней. Они требуют сочетания возможностей редактора, которое трудно проверить изолированными тестами отдельных кнопок.
Работа начинается с разбора источников. Агент выделяет размеры и планировку, отделяет известные данные от допущений и затем собирает модель через доступные операции редактора. Фотографии помогают сверять внешний вид, планы — геометрию. Неизвестный размер остаётся допущением: фотография не превращается в точный обмерный чертёж.
Важен и второй результат — журнал препятствий. В ходе таких прогонов в Gardmi обнаружились, в частности, следующие случаи:
- Панорамное остекление. Операции создания окон не хватало параметров для нужной высоты. Решением стало расширение операции, чтобы агент мог выразить требуемую геометрию.
- Привязка к этажу. При совпадающих осях стен окно могло привязаться к стене другого этажа. Исправление затронуло общий выбор подходящей стены.
- Мебель у стены. Шкафы и кровати оставляли небольшие случайные зазоры. Появились общий механизм привязки и проверка положения мебели.
Это три разных причины неудачи: недостаточная выразительность инструмента, ошибка его поведения и недостаточная точность размещения. Для каждой нужен свой ответ. Переписанный запрос не исправит геометрическую ошибку редактора, а правка редактора не поможет, если агент неверно прочитал исходный план.
Два контура улучшения
Полезно различать внутренний контур, в котором агент исправляет конкретный проект, и внешний, в котором команда или агент разработки исправляет продукт и повторно запускает сценарии.
В первом случае можно переставить шкаф. Во втором — улучшить общую привязку мебели, чтобы ошибка не повторялась в других проектах. Исправление становится особенно ценным, когда из найденного случая получается регрессионный тест: проверка того, что уже решённая проблема не вернулась.
После изменения общего механизма нужно повторить и прежние сценарии. Если новый дом стал лучше, а в другом исчезли проёмы или сломался экспорт, цикл ещё не завершён. Такое развитие продукта через проверяемые задачи близко к evaluation-driven development — разработке, в которой критерии качества и проверки направляют изменения. Для агентных систем полезно сочетать проверки кодом, оценку моделью и человеческую экспертизу. Практика оценки агентов.
Почему комнатам нужен собственный цикл
Здесь важен условный «бюджет внимания» — способность модели одновременно проработать множество деталей и согласовать их между собой. Это отличается от размера контекстного окна: все планы, фотографии и требования могут поместиться на входе, но модель всё равно упустит часть связей. «Внимание» здесь — понятная метафора качества проработки, а не название отдельного измеренного лимита модели.
Наглядная аналогия — генерация изображений. Убедительный портрет одного человека ещё не означает, что модель столь же хорошо нарисует десять разных людей, сохранив особенности каждого лица, позы и взаимное расположение. Чем больше независимых требований нужно выполнить одновременно, тем сложнее сохранить точность каждого: признаки могут смешиваться, детали — повторяться или искажаться. Такие задачи исследуют как композиционную генерацию и привязку признаков к объектам — например, в T2I-CompBench. Это аналогия сложности, а не утверждение об одинаковом механизме ошибок у генератора изображений и агента.
С референсами важен не только их объём, но и роль каждого. Несколько согласованных ракурсов могут уточнить объект; набор фотографий с разными стилями, деталями и неясными приоритетами может усложнить результат. Поэтому для текущего шага полезно выделять нужный фрагмент плана и относящиеся к нему фотографии, явно указывая, что именно из них нужно воспроизвести.
В проектировании дома действует тот же практический принцип: уменьшить число деталей, которые агент должен согласовать за один шаг. Вместо «расставь мебель во всём доме и всё проверь» — отдельная комната, её ограничения, результат и проверка. Каждая зона получает собственный цикл проработки.
В Gardmi необходимость этапной сборки проявилась при воспроизведении одного из домов: ошибки геометрии и размеров комнат обнаружились на финальной проверке, когда уже были добавлены окна, мебель и освещение. Пайплайн организовали по зависимостям: сначала основа и стены, затем проёмы, отделка, оборудование и мебель. Проверка этапа позволяет остановиться до того, как неверная основа обрастёт деталями.
Для мебели этот принцип удобно довести до уровня комнаты:
- Передать агенту контур комнаты, двери, окна, назначение и необходимый состав мебели.
- Разместить крупные предметы с учётом габаритов и ориентации.
- Проверить пересечения, подходы, открывание дверей и соответствие референсу.
- Исправить замечания и сохранить принятый результат перед следующей комнатой.
Так каждая комната получает явный этап работы и оценки. Это иерархическая декомпозиция: проект делится на системы, системы — на локальные задачи. Она помогает распределять усилия, хотя дополнительные вызовы и проверки могут увеличить суммарные затраты. Универсального обещания «быстрее и дешевле» здесь нет.
После локальных проверок остаётся интеграционная: согласованы ли проходы между комнатами, лестницы между этажами и общие размеры. Хорошо обставленные комнаты ещё не гарантируют удобный дом.
Как сделать обратную связь полезной
Проверяющему нужны конкретные основания для замечаний. Размеры и пересечения лучше проверять вычислениями, внешний вид — сопоставлением изображений в близких ракурсах, неоднозначные решения — по понятной оценочной шкале с участием человека. Один красивый скриншот не доказывает правильность всей модели.
Самоотчёт агента также не заменяет проверку. В исследовании Huang и соавторов на изученных задачах рассуждения самокоррекция без внешней обратной связи иногда ухудшала результат. Это не запрет на самопроверку всех современных моделей, но веская причина опираться на наблюдаемые результаты. Исследование, ICLR 2024.
Наконец, полезно сохранять отдельные проекты, на которых инструмент ещё не дорабатывали. Они покажут, переносится ли улучшение на новые случаи. Критерии и лимит итераций задаются заранее: цикл должен завершаться проверенным результатом либо понятным перечнем оставшихся ограничений.
Такую схему можно применять и за пределами 3D: в редакторе документов сравнивать вёрстку с образцом, в обработке таблиц — формулы и контрольные суммы, в конструкторе интерфейсов — результат с макетом и сценариями взаимодействия. Сильная сторона подхода — накопление воспроизводимых свидетельств о том, что именно мешает пользователю. Каждый разобранный случай может улучшить инструмент для следующей задачи.
 Share