
The post has been translated automatically. Original language: Russian




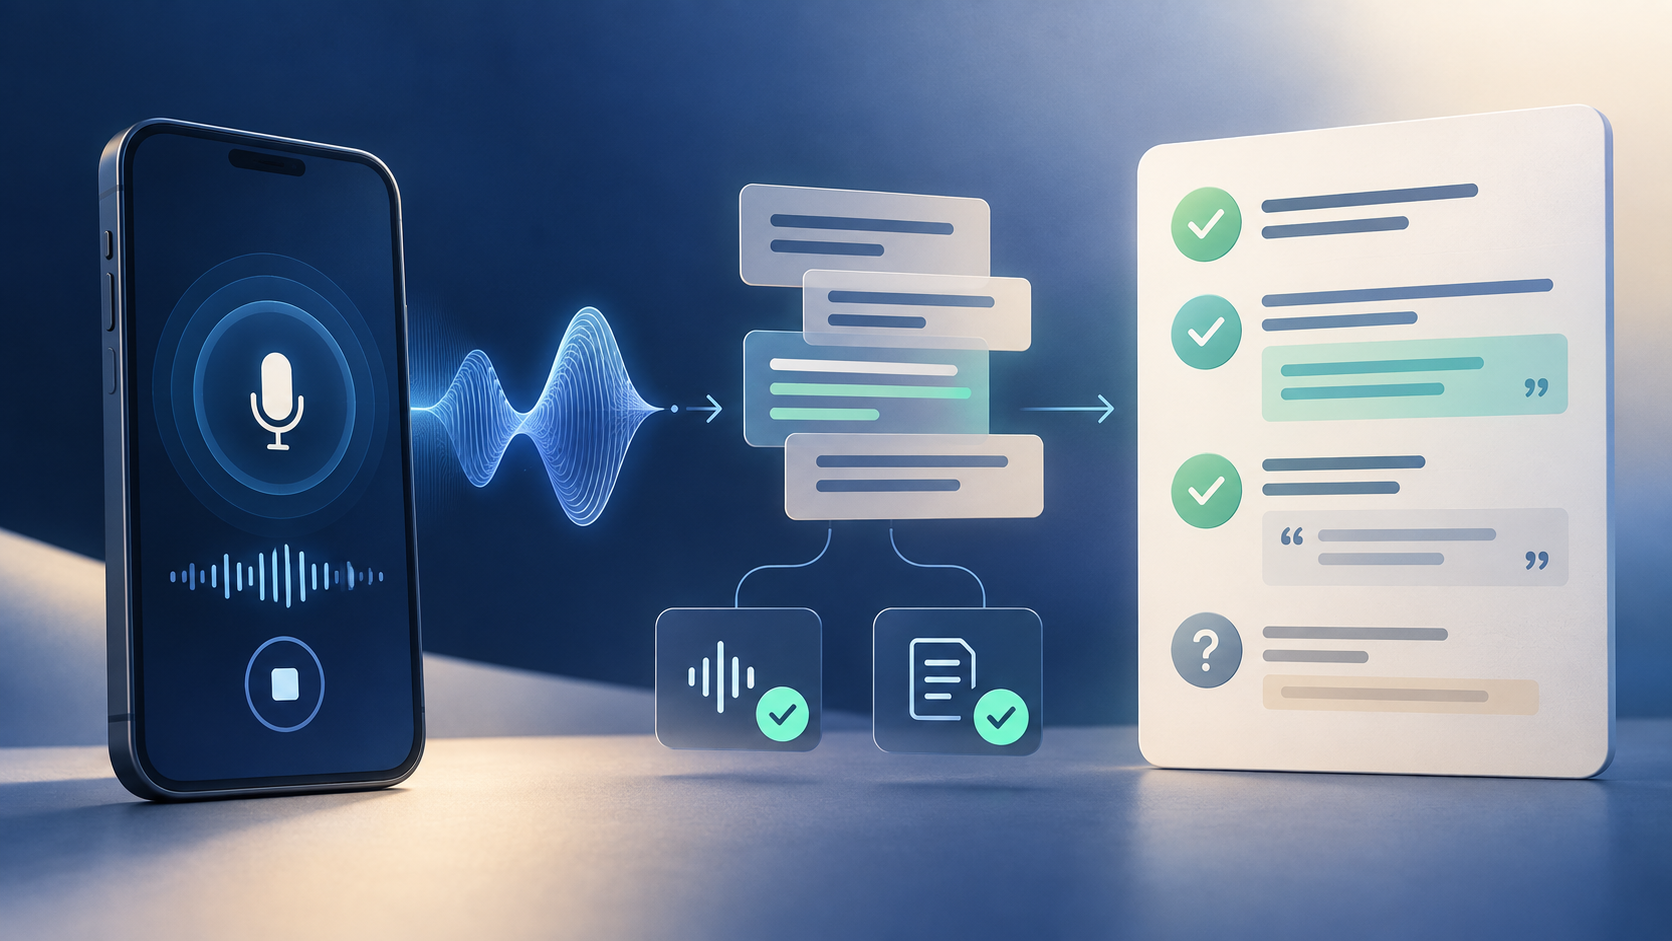
When we started to figure out what the verification of an oral response in a mobile application should consist of, the scheme seemed simple: record the voice, get a transcript, send the text to the model and show the user the score. In practice, it is precisely this short chain that most often creates distrust.
The problem is that there are several different tasks between recording and useful feedback. Everyone has their own mistakes, and they can't be mixed into one "smart" result. A bad sound is not a bad language. An inaccurate transcription is not a speaker's mistake. And a beautiful comment without a quote from the answer is difficult to verify.
Below are the principles that help make such a feature more honest and useful.
1. First the quality of the recording, then the quality of the response
""The first question of the system should not be "how many points did the person answer?", but "do we have enough material to check?".
The recording may be too short, with almost no speech, or with such a noise level that speech recognition begins to guess words. If you immediately send this result for evaluation, the user will receive comments on phrases that they may not have uttered at all.
Therefore, it is better to separate the recording quality into a separate stage. If there is not enough material, the system should honestly report it and offer to try again. This answer is less effective than an instant score, but it does not give away a technical problem for poor knowledge of the language.
2. The transcript is a working draft.
Automatic transcription is useful, but it cannot be considered a verbatim copy of speech. The speech recognition service adds punctuation, selects the spelling of words, and divides speech into sentences. Sometimes he makes mistakes in the boundaries of phrases or hesitantly recognizes a separate section.
Hence the important rule: you can not lower the score for commas, capital letters, or spelling of a word if the source material was oral speech. A person does not "pronounce" punctuation. The car added this decoration.
Here is a simple example. The person says one related thought: "The aim should be to build confidence, not train every child for a particular job." Speech recognition can put an end to the second part. A fragment that looks unfinished will appear on the screen, and the text model will want to correct the grammar. But there was no dot or separate sentence in the recording. Such an "error" exists only in decryption. For the user, this is not a small thing: one clearly unfair remark quickly devalues the entire report.
Uncertain fragments should also be marked separately. They can be shown to the user for verification, but it is dangerous to use them as proof of a grammatical or lexical error. If the system is not sure that it has heard this particular word, it should not base a conclusion about a person's skills on it.
3. Do not promise what the system has not measured.
The response text allows you to analyze the content, coherence, vocabulary, and many grammatical constructions. But the pronunciation, intonation, and naturalness of the sound cannot be reliably assessed from a single text.
It's easy to fall into the trap here: the interface expects the final figure, and the model readily generates it. As a result, the user sees the exact score, although some of the criteria were not actually checked.
A more honest option is to explicitly specify the boundaries of the result. For example, you can show an assessment of the linguistic features found in the response, but not call it a complete assessment of oral speech. It is better to designate an inaccessible criterion as inaccessible, rather than filling it with a plausible number.
4. A score without evidence is almost useless.
Even a correct final assessment does little to help you figure out what to do next. A useful report should answer at least four questions:
1. What has already turned out well in the answer?
2. Where is the specific problem?
3. How can I correct this particular phrase without changing the meaning of the answer?
4. What short exercise will help you avoid repeating the mistake?
For each comment, you need to rely on the source material: an accurate quote, an explanation, and a corrected version. Then the person can compare the comment with their answer, agree with it, or notice a system error.
It is especially important to keep the original transcript separate from the corrected version. If you only show the "improved" text, the user will not see the difference and will not understand what he has learned.
5. An improved answer doesn't have to invent a new life.
Models are good at writing coherent texts and therefore often make the answer brighter: they add a place, an event, an emotion, or a personal detail. This looks convincing for an example of good style, but it creates a problem for learning feedback. The user no longer receives an improved version of their response, but someone else's story.
It's safer to separate the two results. The first is a minimally corrected response that preserves the meaning and facts of the user. The second is a stronger example with a better structure and language, but still without fictional events, dates, people, and achievements.
This approach requires additional verification after generation. It's not enough to ask the model to "not invent anything." It is necessary to separately look for contradictions, new personal facts and corrections that change the original idea.
6. The service error is also part of the user scenario.
Any external processing sometimes takes too long or fails. At this point, it is especially important not to lose the record and not force the person to pay a second time - with money, limit, or time.
A practical scenario looks like this: the original response is saved before the analysis begins, a repeat request continues the same attempt, and the limit is deducted only after the finished report appears. If the record is unusable or the processing failed, the user should be able to repeat the check without penalty.
This is not the most noticeable part of the AI function, but it determines whether a person will trust the product after the first failure.
7. Short checklist before release
Before publishing the feature, it is useful to check a few simple questions:
- is the poor recording quality separated from the weak response;
- does the user see the original transcript;
- are uncertainly recognized fragments excluded from the assessment;
- are punctuation marks given out for oral errors?;
- is it specified which criteria are actually tested;
- does each comment have a quote and an understandable correction?;
- does the improved answer retain its original meaning;
- is it safe to repeat the processing after a failure;
- whether the limit is deducted only for the finished and saved result.
An AI assessment does not become useful when it quickly shows a beautiful figure. It becomes useful when the user understands the origin of each output, sees the boundaries of the system, and can turn feedback into the next specific action.
Когда мы начали разбирать, из чего должна состоять проверка устного ответа в мобильном приложении, схема казалась простой: записать голос, получить расшифровку, передать текст модели и показать пользователю оценку. На практике именно такая короткая цепочка чаще всего и создаёт недоверие.
Проблема в том, что между записью и полезной обратной связью есть несколько разных задач. У каждой свои ошибки, и их нельзя смешивать в один «умный» результат. Плохой звук - это ещё не плохой язык. Неточная расшифровка - не ошибка говорящего. А красивый комментарий без цитаты из ответа трудно проверить.
Ниже - принципы, которые помогают сделать такую функцию честнее и полезнее.
1. Сначала качество записи, потом качество ответа
Первый вопрос системы должен звучать не «на сколько баллов ответил человек?», а «достаточно ли у нас материала для проверки?».
Запись может оказаться слишком короткой, почти без речи или с таким уровнем шума, что распознавание начинает угадывать слова. Если сразу отправить этот результат на оценивание, пользователь получит замечания к фразам, которых он, возможно, вообще не произносил.
Поэтому качество записи лучше выделять в отдельный этап. Если материала недостаточно, система должна честно сообщить об этом и предложить повторить попытку. Такой ответ менее эффектный, чем мгновенный балл, зато он не выдаёт техническую проблему за слабое знание языка.
2. Расшифровка - это рабочий черновик
Автоматическая расшифровка полезна, но её нельзя считать дословной копией речи. Сервис распознавания сам добавляет пунктуацию, выбирает написание слов и делит речь на предложения. Иногда он ошибается в границах фраз или неуверенно распознаёт отдельный участок.
Отсюда важное правило: нельзя снижать оценку за запятые, заглавные буквы или написание слова, если исходным материалом была устная речь. Человек не «произносит» пунктуацию. Это оформление добавила машина.
Вот простой пример. Человек произносит одну связанную мысль: «The aim should be to build confidence, not train every child for a particular job». Распознавание может поставить точку перед второй частью. На экране появится фрагмент, который выглядит незаконченным, и текстовая модель захочет исправить грамматику. Но в записи не было ни точки, ни отдельного предложения. Такая «ошибка» существует только в расшифровке. Для пользователя это не мелочь: одно явно несправедливое замечание быстро обесценивает весь отчёт.
Неуверенные фрагменты тоже стоит помечать отдельно. Их можно показать пользователю для сверки, но опасно использовать как доказательство грамматической или лексической ошибки. Если система не уверена, что услышала именно это слово, она не должна строить на нём вывод о навыках человека.
3. Не обещать то, чего система не измерила
Текст ответа позволяет анализировать содержание, связность, словарный запас и многие грамматические конструкции. Но по одному тексту нельзя надёжно оценить произношение, интонацию и естественность звучания.
Здесь легко попасть в ловушку: интерфейс ожидает итоговую цифру, а модель охотно её генерирует. В результате пользователь видит точный балл, хотя часть критериев фактически не проверялась.
Более честный вариант - явно указать границы результата. Например, показать оценку языковых признаков, найденных в ответе, но не называть её полной оценкой устной речи. Недоступный критерий лучше обозначить как недоступный, а не заполнять правдоподобным числом.
4. Балл без доказательств почти бесполезен
Даже корректная итоговая оценка мало помогает понять, что делать дальше. Полезный отчёт должен отвечать как минимум на четыре вопроса:
1. Что в ответе уже получилось хорошо?
2. Где находится конкретная проблема?
3. Как исправить именно эту фразу, не меняя смысл ответа?
4. Какое короткое упражнение поможет не повторить ошибку?
Для каждого замечания нужна опора на исходный материал: точная цитата, объяснение и исправленный вариант. Тогда человек может сопоставить комментарий со своим ответом, согласиться с ним или заметить ошибку системы.
Особенно важно хранить исходную расшифровку отдельно от исправленной версии. Если показывать только «улучшенный» текст, пользователь не увидит разницу и не поймёт, чему научился.
5. Улучшенный ответ не должен придумывать новую жизнь
Модели хорошо пишут связные тексты и поэтому часто делают ответ ярче: добавляют место, событие, эмоцию или личную деталь. Для примера хорошего стиля это выглядит убедительно, но для учебной обратной связи создаёт проблему. Пользователь получает уже не улучшенную версию своего ответа, а чужую историю.
Безопаснее разделять два результата. Первый - минимально исправленный ответ с сохранением смысла и фактов пользователя. Второй - более сильный пример с лучшей структурой и языком, но всё ещё без выдуманных событий, дат, людей и достижений.
Такой подход требует дополнительной проверки после генерации. Недостаточно попросить модель «ничего не придумывать». Нужно отдельно искать противоречия, новые личные факты и исправления, которые меняют исходную мысль.
6. Ошибка сервиса - тоже часть пользовательского сценария
Любая внешняя обработка иногда занимает слишком много времени или завершается сбоем. В этот момент особенно важно не потерять запись и не заставить человека платить второй раз - деньгами, лимитом или временем.
Практичный сценарий выглядит так: исходный ответ сохраняется до начала анализа, повторный запрос продолжает ту же попытку, а лимит списывается только после появления готового отчёта. Если запись непригодна или обработка завершилась ошибкой, пользователь должен иметь возможность повторить проверку без наказания.
Это не самая заметная часть AI-функции, но именно она определяет, будет ли человек доверять продукту после первого сбоя.
7. Короткий чек-лист перед выпуском
Перед публикацией функции полезно проверить несколько простых вопросов:
- отделяется ли плохое качество записи от слабого ответа;
- видит ли пользователь исходную расшифровку;
- исключаются ли неуверенно распознанные фрагменты из оценки;
- не выдаются ли знаки препинания за ошибки устной речи;
- указано ли, какие критерии реально проверены;
- есть ли у каждого замечания цитата и понятное исправление;
- сохраняет ли улучшенный ответ исходный смысл;
- можно ли безопасно повторить обработку после сбоя;
- списывается ли лимит только за готовый и сохранённый результат.
AI-оценка становится полезной не тогда, когда быстро показывает красивую цифру. Она становится полезной, когда пользователь понимает происхождение каждого вывода, видит границы системы и может превратить обратную связь в следующее конкретное действие.
 Share