

The post has been translated automatically. Original language: Russian




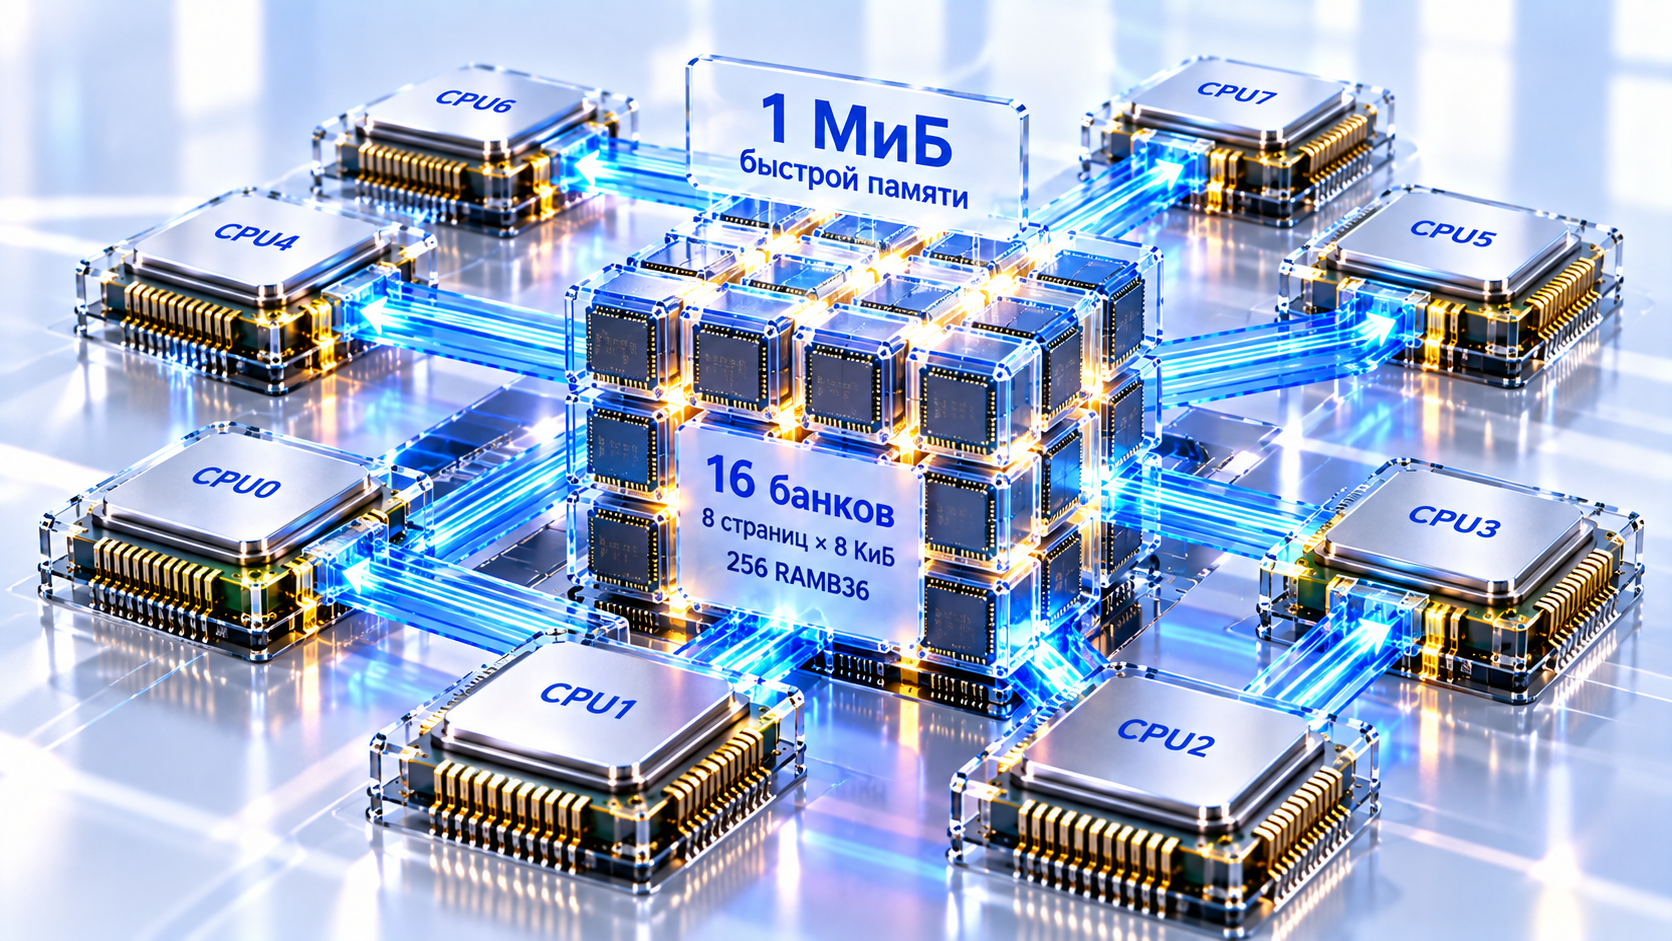
When we say that a processor cluster has 1 MiB of fast internal memory, it sounds like a simple parameter. But on FPGAs, it's not just the total amount of memory that matters. It is equally important how many processors access it at the same time, how far the control signals travel, and how many switching levels are located between the processor and a particular bank.
For Memora8, the main question was: is it possible to save memory reads in one clock cycle with eight processors and 1 MiB of internal SRAM?
To answer it, I had to go through several memory organization options and check each of them after real placement and tracing on the Artix-7 XC7A200T.
Why does one beat matter?
In Memora8, reading commands and regular data should remain as short as possible. If accessing internal memory requires several intermediate stages, the processor pipeline becomes more complicated and the latency of most programs increases.
Therefore, a goal was set for fast routes.:
request for an address
↓
block memory
↓
result on the next clock cycleThat is, reading takes one clock cycle from the processor's point of view.
At a frequency of 125 MHz, the duration of one clock cycle is 8 nanoseconds. During this time, the signal must pass from the processor through the bank and page selection, enter the block memory input and meet the time constraints of the crystal.
It was the physical length of this path that proved to be the main limitation.
First, we tried full connectivity.
The most convenient architecture option is to allow each processor to access any memory bank directly.
This scheme works well for a small number of processors. In an experiment with four processors and ten banks, it was possible to maintain full direct access of each processor to the entire memory and close the 125 MHz frequency.
After deeper registration of write operations, the time limits were met with a positive margin. This confirmed that the very idea of single-touch reading on Artix-7 is quite realistic.
The problem appeared when zooming.
Eight processors changed the picture
The next option contained eight processors and sixteen banks, with each processor still having to have global access to all banks.
This option has already passed the time limits.
The result showed a negative time margin, a large number of violations, and long routes to block memory entrances. It was not the computing node of the processor that became critical, but the way to select the right bank and the right page.
This is an important point. Logically, the circuit remained simple enough, but physically the connections became too long.
The more processors get access to all the banks, the more switches and conductors have to be placed between them.
Limit not the memory, but the line of sight
After that, we changed the question itself.
Instead of asking how to give each processor the full 1 MiB directly, we decided to check how much memory each processor really needs to see in one clock cycle.
This is how the local topology appeared.
In one variant, eight processors were placed as the vertices of a cube. Each processor worked directly only with the nearest banks, and not with the entire cluster memory.
As a result, the global switch has disappeared. Instead of one large network, several short local connections appeared.
This allowed for quick access.
32 banks and 1 MiB of SRAM
The cubic version used 32 memory banks.
Each bank contained four pages of 8 KiB each:
4 pages × 8 KiB = 32 KiB per bankTotal volume:
32 banks × 32 KiB = 1 MiBIt took 256 RAMB36 blocks to implement this volume on the XC7A200T.
Each processor directly saw seven banks:
6 general banks
+
1 local bank
=
7 banksThis gave 224 KiB of memory with direct single-cycle access for each processor.
The rest of the cluster's memory remained available through page movement.
Why is a page more important than a single word?
In classical shared memory, it is often assumed that any processor can read any word at any time.
Memora8 is designed differently. The main unit of memory allocation is an 8 KiB page.
If the processor needs a page that is currently far away, it can first be moved to a locally accessible bank. After that, the program works with it with the usual read and write operations without a long global path.
This allows you to transfer an expensive operation from the level of each memory access to the level of rare movement of an entire page.
Instead of:
each LOAD can go through the entire crystalit turns out:
the page is moved in advance

, the processor is running locallyFor the physical implementation, this is a huge difference.
What the full eight-processor version showed
The full cubic version with eight processors, 32 banks and 1 MiB of memory was placed and traced on the Artix-7 XC7A200T.
After tracing, it turned out approximately:
18 893 LUT
9 302 FF
256 RAMB36All connections were successfully routed, and there were no trace errors left.
Due to time constraints, the result was almost at the border, but still positive.:
Frequency 125 MHz
WNS +0.001 ns
WHS +0.090 ns
error 0In other words, the specified time limits have been met.
This was an important result for us: an eight-processor cluster with 1 MiB of internal SRAM can actually save processor reads in one clock cycle.
Why is the stock so small?
A positive margin of one thousandth of a nanosecond looks almost symbolic.
But this does not mean that the memory itself is necessarily at the limit. The experimental scheme used additional control logic, which artificially switched different access modes and created a heavy load on routing.
As a result, the critical path passed largely through interconnections, rather than through logical elements.
This once again confirmed the main conclusion of the entire series of experiments: for such a memory, the limitation is not the calculation, but the physical distance between the blocks.
The following scheme has become even more compact
After the cube, we continued to search for a more regular structure and switched to the option with sixteen common banks of eight pages each.
The total volume remained the same:
16 banks × 8 pages × 8 KiB = 1 MiBBut the structure of the links has become simpler.
In the K4,4 topology variant, each bank connects a specific pair of processors in advance. This further restricts global paths and reduces the number of possible request sources for a single bank.
The experiment with such a scheme also took place at a frequency of 125 MHz.
The result of the 16-bank option
After placement and tracing, the following indicators were obtained:
23 205 LUT
7 999 FF
256 RAMB36Due to time constraints:
WNS +0.025 ns
WHS +0.075 ns
trace errors 0Single-touch reading of commands and data has been preserved.
Compared to the previous cubic version, the time margin has become slightly better, although the logic itself has changed and a direct comparison only by the number of logical elements would be incorrect.
Something else is more important to us: 1 MB of memory, eight processors, and reading in one clock cycle were confirmed again on a real trace.
Why can't we just look at the amount of logic
When developing on FPGAs, you often want to compare options based on the number of LUTs or registers.
But this is not enough for Memora8 memory.
For example, a circuit may use fewer logic gates, but have very long connections between them. Then it will lose to a larger scheme with a local structure.
Therefore, the key metrics for us have become:
- are the time limits being met?;
- how many connections remain long;
- where is the critical path?;
- is it possible to save a read in one tact;
- how regularly banks and processors are placed.
These are the physical properties of the entire circuit, not of a single module.
Why writing can be slower than reading
During the experiments, another useful rule became clear.
It is not necessary to require the same delay from reading and writing.
For reading, it is important to get data quickly, because the execution of commands directly depends on it. The recording can be carried out through additional registers and performed in several stages.
It was this approach that helped close the time constraints in several memory options.
It turns out a reasonable compromise.:
reading by the processor is a short path
, writing is a deeper path
, moving pages is a separate slow pathNot all memory operations need to have the same latency.
FPGA as a means of architecture verification
These experiments proved useful not only for a specific implementation on Artix-7.
They showed which properties of architecture are really important.
Full global connectivity is convenient logically, but it does not scale well physically. The local structure of banks requires a little more involvement from the operating system, but it allows you to keep a short access path.
That is why the FPGA for us is not only a temporary platform before the future crystal. It allows you to detect architectural errors even before manufacturing your own processor.
If the circuit already at the FPGA level requires too long global connections, there is reason to review the architecture itself in advance.
The main result of the experiment
As a result, it was possible to confirm the practical possibility of the following configuration:
8 processors
1 MiB of internal SRAM
256 blocks of RAMB36
125 MHz
processor reads in 1 clock cycleThis was made possible not by increasing the number of pipeline stages or reducing the frequency, but by changing the memory structure.
Instead of the idea of "every processor sees everything," Memora8 is gradually moving to a different model.: each processor quickly sees the nearest memory, and the system moves entire pages to where they are needed for calculations.
For the software model, this is an additional responsibility of the operating system. For hardware, it is possible to replace long global paths with short local connections.
It is precisely this kind of exchange that looks more promising for Memora8 today.
Когда мы говорим, что у процессорного кластера есть 1 МиБ быстрой внутренней памяти, это звучит как простой параметр. Но на ПЛИС важен не только общий объём памяти. Не менее важно, сколько процессоров одновременно к ней обращаются, насколько далеко проходят управляющие сигналы и сколько уровней переключения находится между процессором и конкретным банком.
Для Memora8 основной вопрос звучал так: можно ли сохранить чтение памяти за один такт при восьми процессорах и 1 МиБ внутренней SRAM?
Чтобы ответить на него, пришлось пройти несколько вариантов организации памяти и проверить каждый из них после реального размещения и трассировки на Artix-7 XC7A200T.
Почему один такт имеет значение
В Memora8 чтение команд и обычных данных должно оставаться максимально коротким. Если обращение к внутренней памяти требует нескольких промежуточных стадий, усложняется конвейер процессора и увеличивается задержка большинства программ.
Поэтому для быстрых путей была поставлена цель:
запрос адреса
↓
блочная память
↓
результат на следующем тактеТо есть чтение занимает один такт с точки зрения процессора.
На частоте 125 МГц длительность одного такта составляет 8 наносекунд. За это время сигнал должен пройти от процессора через выбор банка и страницы, попасть во вход блочной памяти и удовлетворить временным ограничениям кристалла.
Именно физическая длина этого пути оказалась главным ограничением.
Сначала мы попробовали полную связность
Самый удобный вариант архитектуры — позволить каждому процессору напрямую обращаться к любому банку памяти.
Для небольшого числа процессоров такая схема работает хорошо. В эксперименте с четырьмя процессорами и десятью банками удалось сохранить полный прямой доступ каждого процессора ко всей памяти и закрыть частоту 125 МГц.
После более глубокой регистрации операций записи временные ограничения были выполнены с положительным запасом. Это подтвердило, что сама идея одноктактового чтения на Artix-7 вполне реалистична.
Проблема появилась при масштабировании.
Восемь процессоров изменили картину
Следующий вариант содержал восемь процессоров и шестнадцать банков, причём каждый процессор по-прежнему должен был иметь глобальный доступ ко всем банкам.
Такой вариант уже не прошёл временные ограничения.
Полученный результат показал отрицательный запас времени, большое количество нарушений и длинные маршруты до входов блочной памяти. Критическим стал не вычислительный узел процессора, а именно путь выбора нужного банка и нужной страницы.
Это важный момент. Логически схема оставалась достаточно простой, но физически соединения стали слишком длинными.
Чем больше процессоров получают доступ ко всем банкам, тем больше переключателей и проводников приходится размещать между ними.
Ограничить не память, а прямую видимость
После этого мы изменили сам вопрос.
Вместо того чтобы спрашивать, как дать каждому процессору весь 1 МиБ напрямую, мы решили проверить, сколько памяти каждый процессор действительно должен видеть за один такт.
Так появилась локальная топология.
В одном из вариантов восемь процессоров были размещены как вершины куба. Каждый процессор напрямую работал только с ближайшими банками, а не со всей памятью кластера.
В результате глобальный коммутатор исчез. Вместо одной большой сети появились несколько коротких локальных соединений.
Это позволило сохранить быстрый доступ.
32 банка и 1 МиБ SRAM
В кубическом варианте использовалось 32 банка памяти.
Каждый банк содержал четыре страницы по 8 КиБ:
4 страницы × 8 КиБ = 32 КиБ на банкОбщий объём:
32 банка × 32 КиБ = 1 МиБДля реализации такого объёма на XC7A200T потребовалось 256 блоков RAMB36.
Каждый процессор напрямую видел семь банков:
6 общих банков
+
1 локальный банк
=
7 банковЭто давало 224 КиБ памяти с непосредственным одноктактовым доступом для каждого процессора.
Остальная память кластера оставалась доступной через перемещение страниц.
Почему страница важнее отдельного слова
В классической общей памяти часто предполагается, что любой процессор может в любой момент прочитать любое слово.
Memora8 устроен иначе. Основной единицей размещения памяти является страница размером 8 КиБ.
Если процессору понадобится страница, которая сейчас находится далеко, её можно сначала переместить в локально доступный банк. После этого программа работает с ней обычными операциями чтения и записи без длинного глобального пути.
Это позволяет перенести дорогую операцию с уровня каждого обращения к памяти на уровень редкого перемещения целой страницы.
Вместо:
каждый LOAD может идти через весь кристаллполучается:
страница перемещается заранее
↓
процессор работает локальноДля физической реализации это огромная разница.
Что показал полный восьмипроцессорный вариант
Полный кубический вариант с восемью процессорами, 32 банками и 1 МиБ памяти удалось разместить и трассировать на Artix-7 XC7A200T.
После трассировки получилось примерно:
18 893 LUT
9 302 FF
256 RAMB36Все соединения были успешно проложены, ошибок трассировки не осталось.
По временным ограничениям результат оказался практически на границе, но всё же положительным:
частота       125 МГц
WNS           +0,001 нс
WHS           +0,090 нс
ошибки 0То есть заданные временные ограничения были выполнены.
Для нас это был важный результат: восьмипроцессорный кластер с 1 МиБ внутренней SRAM действительно может сохранять чтение процессором за один такт.
Почему запас получился таким маленьким
Положительный запас в одну тысячную наносекунды выглядит почти символически.
Но это не означает, что сама память обязательно находится на пределе. В экспериментальной схеме использовалась дополнительная управляющая логика, которая искусственно переключала разные режимы доступа и создавала жёсткую нагрузку на маршрутизацию.
Критический путь в итоге проходил в значительной степени через межсоединения, а не через логические элементы.
Это ещё раз подтвердило основной вывод всей серии экспериментов: для такой памяти ограничением становится не вычисление, а физическое расстояние между блоками.
Следующая схема стала ещё компактнее
После куба мы продолжили поиск более регулярной структуры и перешли к варианту с шестнадцатью общими банками по восемь страниц каждый.
Общий объём остался тем же:
16 банков × 8 страниц × 8 КиБ = 1 МиБНо структура связей стала проще.
В варианте с топологией K4,4 каждый банк заранее связывает определённую пару процессоров. Это ещё сильнее ограничивает глобальные пути и уменьшает количество возможных источников запроса для одного банка.
Эксперимент с такой схемой также прошёл на частоте 125 МГц.
Результат варианта с 16 банками
После размещения и трассировки были получены следующие показатели:
23 205 LUT
7 999 FF
256 RAMB36По временным ограничениям:
WNS +0,025 нс
WHS +0,075 нс
ошибки трассировки 0Одноктактовое чтение команд и данных сохранилось.
По сравнению с предыдущим кубическим вариантом запас по времени стал немного лучше, хотя сама логика изменилась и прямое сравнение только по числу логических элементов было бы неправильным.
Для нас важнее другое: 1 МиБ памяти, восемь процессоров и чтение за один такт снова подтвердились на реальной трассировке.
Почему нельзя смотреть только на количество логики
При разработке на ПЛИС часто хочется сравнивать варианты по числу LUT или регистров.
Но для памяти Memora8 этого недостаточно.
Например, схема может использовать меньше логических элементов, но иметь очень длинные соединения между ними. Тогда она проиграет более крупной схеме с локальной структурой.
Поэтому для нас ключевыми метриками стали:
- выполняются ли временные ограничения;
- сколько соединений остаются длинными;
- где находится критический путь;
- удаётся ли сохранить чтение за один такт;
- насколько регулярно размещаются банки и процессоры.
Это физические свойства всей схемы, а не отдельного модуля.
Почему запись может быть медленнее чтения
В ходе экспериментов выяснилось ещё одно полезное правило.
Не обязательно требовать одинаковой задержки от чтения и записи.
Для чтения важно быстро получить данные, потому что от этого напрямую зависит выполнение команд. Запись можно провести через дополнительные регистры и выполнить за несколько стадий.
Именно такой подход помог закрыть временные ограничения в нескольких вариантах памяти.
Получается разумный компромисс:
чтение процессором — короткий путь
запись — более глубокий путь
перемещение страниц — отдельный медленный путьНе все операции памяти должны иметь одинаковую задержку.
ПЛИС как средство проверки архитектуры
Эти эксперименты оказались полезны не только для конкретной реализации на Artix-7.
Они показали, какие свойства архитектуры действительно важны.
Полная глобальная связность удобна логически, но плохо масштабируется физически. Локальная структура банков требует немного больше участия от операционной системы, зато позволяет сохранять короткий путь доступа.
Именно поэтому ПЛИС для нас — не только временная платформа перед будущим кристаллом. Она позволяет обнаруживать архитектурные ошибки ещё до изготовления собственного процессора.
Если схема уже на уровне ПЛИС требует слишком длинных глобальных соединений, есть основания заранее пересмотреть саму архитектуру.
Главный результат эксперимента
В итоге удалось подтвердить практическую возможность следующей конфигурации:
8 процессоров
1 МиБ внутренней SRAM
256 блоков RAMB36
125 МГц
чтение процессором за 1 тактЭто стало возможным не благодаря увеличению числа стадий конвейера или снижению частоты, а благодаря изменению структуры памяти.
Вместо идеи «каждый процессор видит всё» Memora8 постепенно переходит к другой модели: каждый процессор быстро видит ближайшую память, а система перемещает целые страницы туда, где они нужны для вычислений.
Для программной модели это дополнительная ответственность операционной системы. Для аппаратуры — возможность заменить длинные глобальные пути короткими локальными соединениями.
Именно такой обмен сегодня выглядит для Memora8 более перспективным.

 Share








