The post has been translated automatically. Original language: Russian




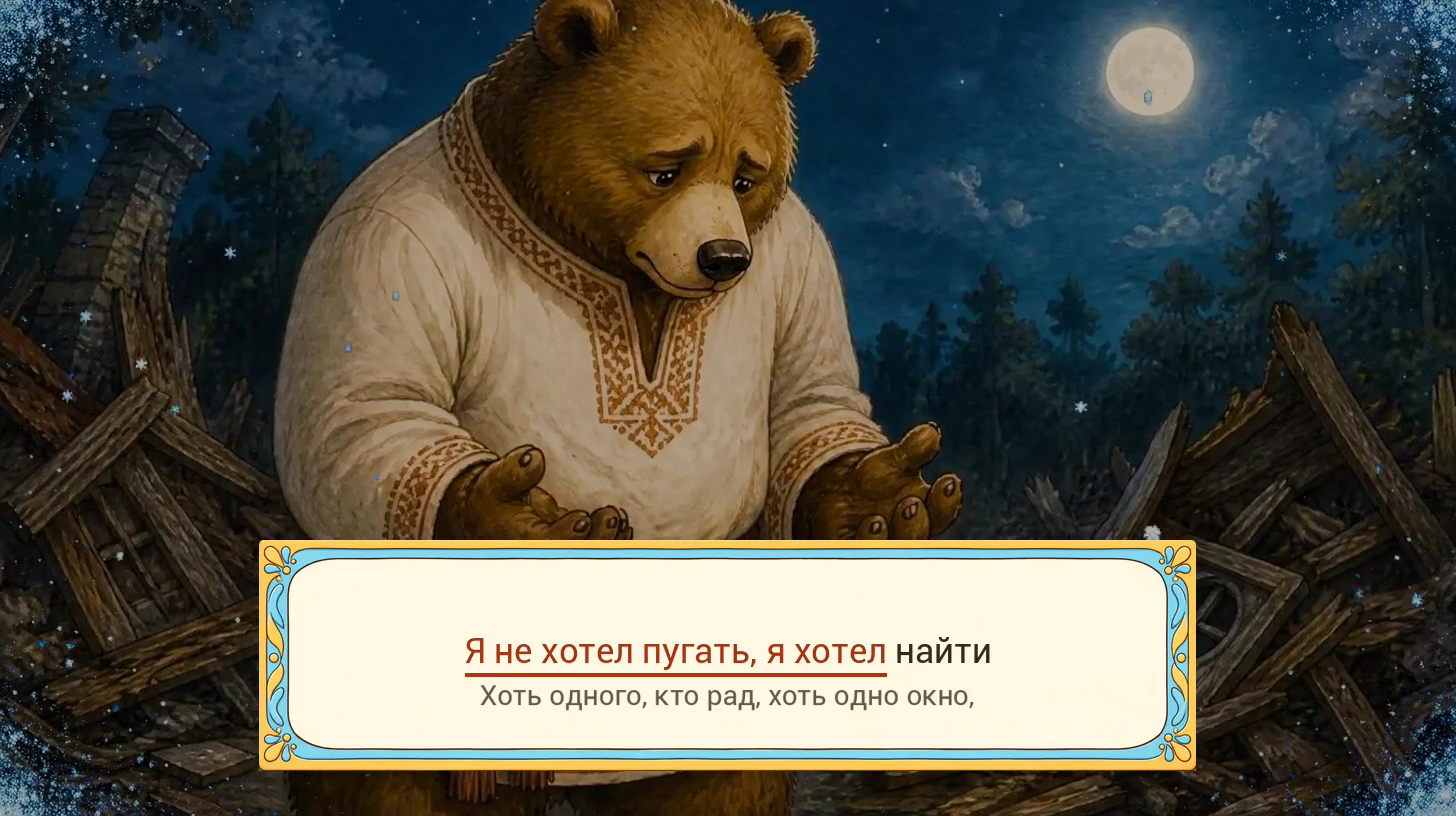
Songly now generates karaoke from a song or an existing video. The example is “The Little House — I Just Wanted In”: an illustrated Russian music video with highlighted lyrics and full vocals. 🎤
The result involves several tasks: extracting an instrumental version from a mixed recording, matching lyrics to the singing, and letting people choose how much vocal guidance they need. Here is how the team at 3 Krolika LLP approached these tasks.
A detail that helps people sing
The current line shows what to sing now, the next helps singers prepare, and a countdown appears before the vocal entry. Highlighting preserves letter weight: colour and underlining change, so the text does not “jump”. We check contrast over the actual video, in both bright and dark scenes.
Karaoke in different languages, including Kazakh
Karaoke can be generated in different languages, including Kazakh. The system identifies the song’s language, recognises the lyrics and highlights them during the performance. Kazakh characters are supported in the text design.
An instrumental version without studio stems
We separate songs using the open model Demucs, specifically Hybrid Transformer Demucs (htdemucs). It works with both the audio waveform and a spectrogram, a representation of frequencies over time. Exchanging information between them helps distinguish sound sources.
For karaoke, we obtain vocals and accompaniment without them. A finished song is enough; users do not need separate studio tracks. Separation is still a model estimate, however, so the instrumental version may contain residual vocals and audio artefacts.
Description and open code: Demucs.
Three audio tracks in one video
The downloadable MP4 contains three audio options:
- Full vocals, to listen and learn the melody.
- Quiet vocals, approximately 25%, to sing with a guide.
- An instrumental version, to sing independently.
Singers can gradually reduce the guidance by switching tracks in the same file. This requires a player that supports audio-track selection. The attached YouTube example plays with full vocals.
В Сонгли появилась генерация караоке из песни или готового видео. В примере — «Теремок — я хотел войти»: рисованный клип с подсветкой слов и полным голосом исполнителя. 🎤
За этим результатом стоят несколько задач: получить минусовку из сведённой записи, совместить слова с пением и дать человеку выбрать, насколько сильно ему нужна вокальная подсказка. Расскажем, как команда ТОО «3 Krolika» решила эти задачи.
Деталь, которая помогает петь
Текущая строка показывает, что петь сейчас, следующая помогает подготовиться, а перед вступлением появляется отсчёт. При подсветке мы сохраняем толщину букв: меняются цвет и подчёркивание, поэтому текст не «прыгает». Контраст проверяем поверх самого клипа — на светлых и тёмных сценах.
Караоке на разных языках, включая казахский
Караоке можно генерировать на разных языках, в том числе на казахском. Система определяет язык песни, распознаёт слова и подсвечивает их во время исполнения. Казахские буквы поддерживаются в оформлении текста.
Минусовка без студийных исходников
Для разделения песни используем открытую модель Demucs — Hybrid Transformer Demucs (htdemucs). Она работает одновременно со звуковой волной и спектрограммой — представлением частот во времени. Обмен информацией между ними помогает выделять источники звука.
Для караоке получаем вокал и сопровождение без него. Пользователю достаточно готовой песни: отдельные студийные дорожки не нужны. Но разделение остаётся оценкой модели, поэтому в минусовке возможны остатки голоса и звуковые артефакты.
Описание и открытый код: Demucs.
Три аудиодорожки в одном видео
В скачиваемом MP4 сохраняются три варианта звука:
- Полный голос — послушать песню и выучить мелодию.
- Тихий голос, примерно 25% — петь с подсказкой.
- Минусовка — исполнить песню самостоятельно.
Можно постепенно уменьшать помощь исполнителя, переключая дорожки в одном файле. Для этого нужен проигрыватель с выбором аудиодорожки. В приложенном YouTube-примере звучит полный голос.
 Share