

The post has been translated automatically. Original language: Russian




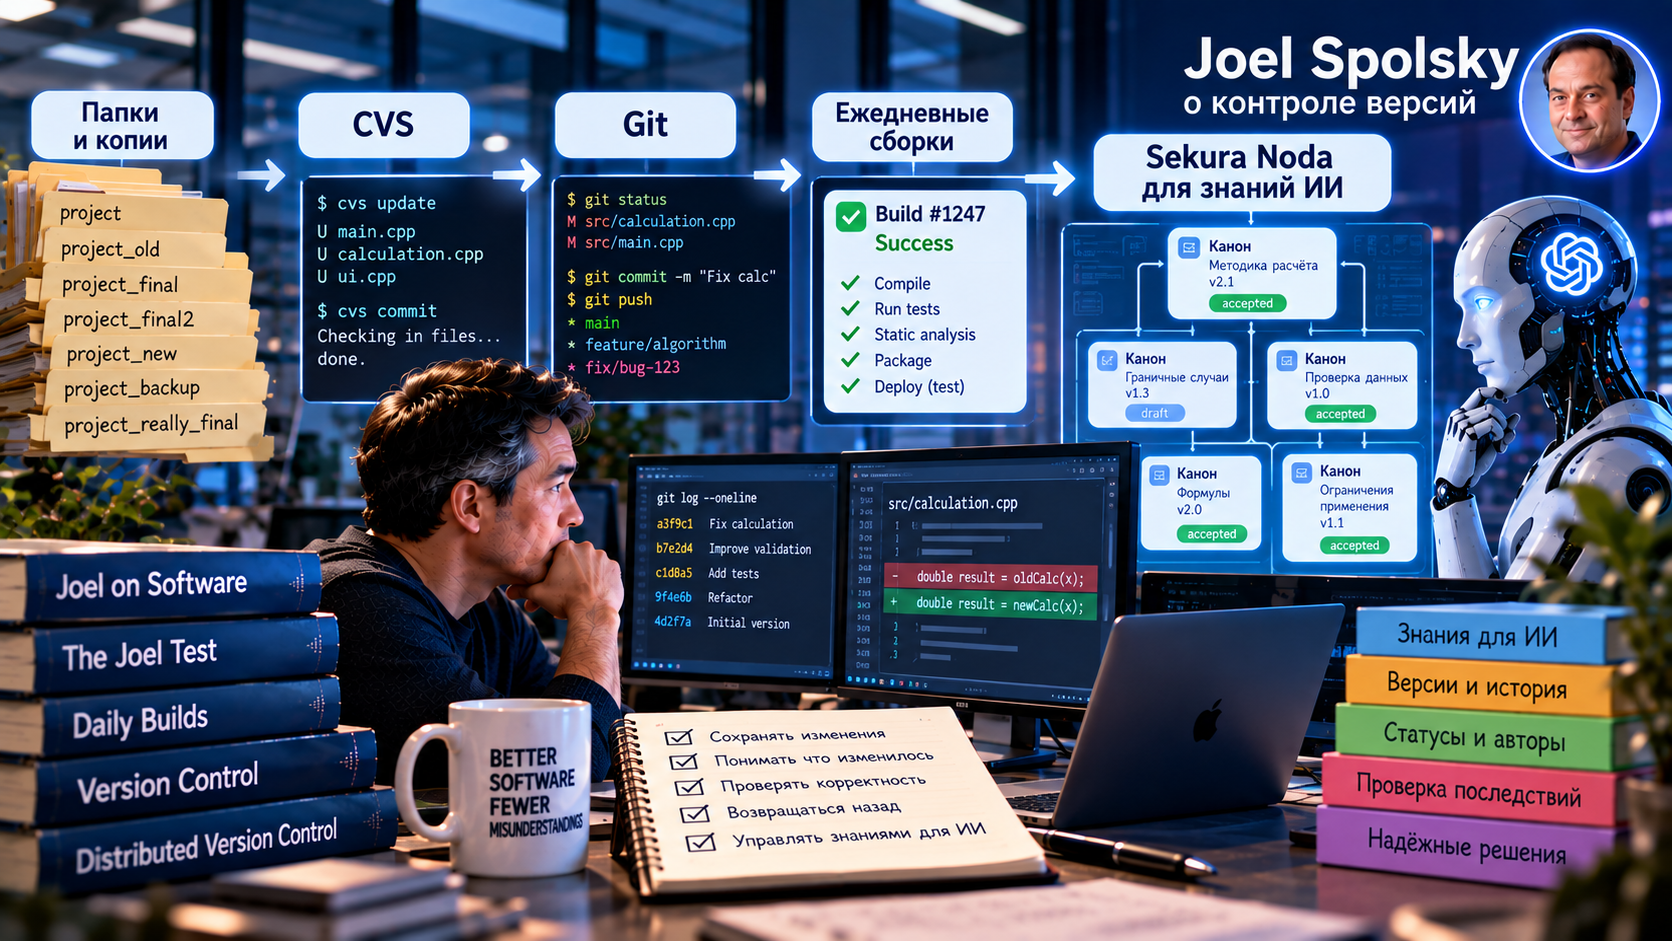
When I read Joel on Software in the early 2000s, many of Joel Spolsky's thoughts looked almost like simple rules of professional hygiene. Today, some of them seem obvious, but then they were not the norm in every small team.
In August 2000, Joel published the famous The Joel Test: 12 Steps to Better Code. The first three questions there were very revealing: do you use a version control system, is it possible to build a product in one step, and do you do daily builds.
For Joel, these were not pleasant additions to a good development. This was the basis of normal engineering work.
These three points strongly influenced me.
Before version control, there were folders
Before that, like many programmers, I had my own version control system.
It was called "folders".
Before making a major change, you copy the working directory. Then there is another copy, the next version, the archive, the backup directory. After a while, there are several almost identical versions of the program on the disk, and it's not always clear which one is really needed.
As long as nothing breaks, this scheme seems to be quite working. The real disappointment came when I forgot to make a copy.
The program is working. You decide to improve something, change several parts of the system, launch it, and realize that it's gotten worse. But the old working version is no longer there, because for some reason you didn't copy the folder this time.
I've had these situations before, and it felt very unpleasant: the working condition existed a few hours ago, and now it has to be restored manually.
Joel put version control first.
In The Joel Test, source code control is generally the first issue. This shows well how basic Joel considered this practice to be.
When I started using CVS, the approach to change really changed. The working version no longer depended on whether I remembered to make a copy of the catalog yesterday.
You can change the code, see the result, and if the idea turned out to be bad, go back. For the developer, this gives important freedom: the experiment ceases to be an irreversible action.
Then Git appeared, and this principle became even more convenient. Branches, individual changes, consolidation of work and the normal history of the project have gradually become so familiar that today it is difficult to imagine serious development without them.
From a copy of the program to the revision history
In 2010 Joel wrote Distributed Version Control is here to stay, baby and honestly admitted that he initially underestimated distributed version control systems.
It was important for him to switch from thinking in versions of individual files to thinking in sets of changes. This is really much closer to how we work with the program: not "the file has version 27", but "here we fixed the bug", "here we added a function", "here we tried a different architecture".
Git is gradually turning the project's history into a sequence of meaningful decisions.
If something went wrong, you can see exactly what kind of change it caused. If the idea doesn't work, you can remove it. If the experiment is too risky, you can do it separately from the main branch.
Compared to my folders, it was a completely different level of work.
But saving the code is not enough.
The following point turned out to be equally important to me The Joel Test — daily builds.
Version control answers the question: What has changed?
The assembly responds to another: can we get a working program out of this state again?
The difference is fundamental. You can perfectly save the history of a project and at the same time capture a state that is not going to happen at all.
The classic case is that the developer added a new file, everything works locally, but forgot to add the file to the version control system. He calmly goes home, and the rest of the project is no longer going on.
Regular assembly quickly makes such errors visible.
It became one system for me.
Over time, version control and automatic build stopped being two separate practices.
First, we capture the change. Then we check that it is really possible to get a working result from the fixed state again.
And then the repository becomes something more than a backup copy of the source code. It turns into a reproducible project history.
You can take a specific point in time, see the code, understand what changes have been made there, and get the appropriate version of the program.
For a long-lived system, this is a huge difference compared to a directory like project_final_2_really_final.
And then the AI appeared.
In 2026, the importance of this discipline has only grown.
Now, not only a programmer can create a large amount of changes very quickly. AI can change dozens of files in a few minutes, refactor, write tests, or rebuild an entire module.
The faster the code appears, the more important it is to understand exactly what has changed.
Git works almost perfectly here. You can see the difference, check the result, assemble the system, run the tests, and only then accept the change.
If the result is bad, you can just go back.
AI has dramatically reduced the cost of creating changes. This means that the tools to control these changes are becoming even more important.
But the AI has another problem.
Working with AI, I gradually saw another analogy with the time when we kept code in folders.
Today, the knowledge that AI uses very often lives in much the same way.
Something is written in the system instructions.
There's something left in the long dialogue.
Something is in the documents.
The man once explained something to the model.
After a while, it becomes difficult to understand why the AI made a certain decision at all. What rule did he use? Who formulated it? Is it still valid? Didn't another rule appear later that contradicts it?
It's starting to resemble old source catalogs: the current state seems to be there, but there's no normal history of how we got to it.
Hence the idea of Sekura Noda
That's why at Sekura Noda we try to separate knowledge from the model itself.
The idea for me here is very similar to what once happened with the source code.
Knowledge must exist as a separate, manageable entity. It is necessary to understand who formulated it, whether it has been accepted or is still being discussed, where it is applicable, what other knowledge is associated with, and how it has changed over time.
Then the AI gets more than just another big text that needs to be interpreted somehow. He receives a fixed knowledge system, the state of which can be controlled.
This does not mean that Noda is literally "Git for AI". Code and knowledge work in different ways.
But the engineering need itself is very similar.
The code needed a story. AI knowledge too
Once we realized that it's not enough to keep only the current copy of the source code.
We needed a history of changes.
Then it wasn't enough to just keep the history. Automatic builds and tests were needed to confirm that the new state is still functional.
Now a similar question arises for AI.
It is not enough to know only the current response of the model. It is increasingly important to understand on the basis of what knowledge this answer appeared and what state of this knowledge was used.
If the rule has changed, I would like to see a change. If it is no longer valid, be aware of it. If two pieces of knowledge contradict each other, discover the conflict, rather than hoping that the model will sort itself out somehow.
For me, this is a natural extension of the idea of version control.
From Git to AI Engineering Memory
Git does not make the program correct automatically.
It just creates a foundation, without which it is very difficult to seriously control the development.
With Noda, I look at knowledge in much the same way. The mere fact of fixing knowledge does not mean that it is true. But it becomes possible to manage it, check its status and understand the origin of decisions.
This is especially important., if the AI becomes a participant in real engineering or business work.
The more decisions we trust him with, the less we want to have a situation.:
"Why did he decide that way?"
"I don't know. There must have been something in the promptness."
This is acceptable for a toy assistant. Not so much for a working system anymore.
Daily builds for the AI world
Here I especially like the parallel with the third point of The Joel Test.
For the code, we have learned not only to save changes, but also to constantly check the new state with builds and tests.
For AI, I think we will gradually have to do the same with knowledge.
The rule has changed — you need to understand which decisions it will affect.
New knowledge has been added to check if it contradicts what has already been accepted.
The context has changed to understand which previous conclusions are now outdated.
That is, "knowledge version control" alone will not be enough either. You will need to check the effects of the changes.
It seems to me that this is where AI systems engineering will gradually move.
What's Left of The Joel Test
When I think back to my old folders with copies of programs, they seem almost ridiculous today. But it was once a completely natural way of working.
Then I read Joel, started using CVS, later Git, added regular builds, and the attitude towards development changed fundamentally.
We stopped trusting our own memory and started trusting the reproducible process.
Today, AI sets a similar task for us at the next level. We have learned how to save, compare, check, and return the code. Now we need to learn how to take the knowledge that our models use just as seriously.
And therefore the first points A quarter of a century later, I read The Joel Test a little more widely.:
record changes, keep a history, check the new state, and always understand where the current result came from.
It once changed software development.
Now, perhaps, the same principle will have to be applied to the development of AI systems.
Когда я в начале 2000-х читал Joel on Software, многие мысли Джоэла Спольски выглядели почти как простые правила профессиональной гигиены. Сегодня часть из них кажется очевидной, но тогда далеко не в каждой небольшой команде они были нормой.
В августе 2000 года Джоэл опубликовал знаменитый The Joel Test: 12 Steps to Better Code. Первые три вопроса там были очень показательными: используете ли вы систему контроля версий, можно ли собрать продукт одним действием и делаете ли вы ежедневные сборки.
Для Джоэла это были не приятные дополнения к хорошей разработке. Это была основа нормальной инженерной работы.
На меня эти три пункта сильно повлияли.
До контроля версий были папки
До этого у меня, как и у многих программистов, была собственная система контроля версий.
Она называлась «папки».
Перед серьёзным изменением копируешь рабочий каталог. Потом появляется ещё одна копия, следующая версия, архив, резервный каталог. Через некоторое время на диске лежат несколько почти одинаковых вариантов программы, и уже не всегда понятно, какой из них действительно нужен.
Пока ничего не ломается, такая схема кажется вполне рабочей. Настоящее разочарование наступало тогда, когда я забывал сделать копию.
Программа работает. Ты решаешь что-нибудь улучшить, меняешь несколько частей системы, запускаешь — ипонимаешь, что стало хуже. А старого рабочего варианта уже нет, потому что именно в этот раз ты почему-то не скопировал папку.
У меня такие ситуации случались, и чувство было очень неприятное: рабочее состояние существовало ещё несколько часов назад, а теперь его приходится восстанавливать вручную.
Джоэл поставил контроль версий первым пунктом
В The Joel Test контроль исходного кода стоит вообще первым вопросом. Это хорошо показывает, насколько базовой Джоэл считал эту практику.
Когда я начал использовать CVS, подход к изменениям действительно поменялся. Рабочая версия больше не зависела от того, вспомнил ли я вчера сделать копию каталога.
Можно изменить код, посмотреть результат и, если идея оказалась плохой, вернуться назад. Для разработчика это даёт важную свободу: эксперимент перестаёт быть необратимым действием.
Потом появился Git, и этот принцип стал ещё удобнее. Ветки, отдельные изменения, объединение работы и нормальная история проекта постепенно стали настолько привычными, что сегодня трудно представить серьёзную разработку без них.
От копии программы к истории изменений
В 2010 году Джоэл написал Distributed Version Control is here to stay, baby и честно признался, что первоначально недооценивал распределённые системы контроля версий.
Для него важным оказался переход от мышления версиями отдельных файлов к мышлению наборами изменений. Это действительно гораздо ближе к тому, как мы работаем с программой: не «у файла появилась версия 27», а «здесь мы исправили ошибку», «здесь добавили функцию», «здесь попробовали другую архитектуру».
Git постепенно превращает историю проекта в последовательность осмысленных решений.
Если что-то пошло не так, можно увидеть, какое именно изменение это вызвало. Если идея не сработала, её можно убрать. Если эксперимент слишком рискованный, можно сделать его отдельно от основной ветки.
По сравнению с моими папками это был совершенно другой уровень работы.
Но сохранить код недостаточно
Для меня не менее важным оказался следующий пункт The Joel Test — ежедневные сборки.
Контроль версий отвечает на вопрос: что изменилось?
Сборка отвечает на другой: можем ли мы из этого состояния снова получить рабочую программу?
Разница принципиальная. Можно прекрасно сохранить историю проекта и при этом зафиксировать состояние, которое вообще не собирается.
Классический случай: разработчик добавил новый файл, у него локально всё работает, а в систему контроля версий файл добавить забыл. Он спокойно уходит домой, а у остальных проект больше не собирается.
Регулярная сборка быстро делает такие ошибки видимыми.
Для меня это стало одной системой
Со временем контроль версий и автоматическая сборка перестали быть двумя отдельными практиками.
Сначала мы фиксируем изменение. Затем проверяем, что из зафиксированного состояния действительно можно снова получить рабочий результат.
И тогда репозиторий становится чем-то большим, чем резервная копия исходного кода. Он превращается в воспроизводимую историю проекта.
Можно взять определённую точку во времени, увидеть код, понять, какие изменения туда вошли, и получитьсоответствующую версию программы.
Для долгоживущей системы это огромная разница по сравнению с каталогом вроде project_final_2_really_final.
А потом появился ИИ
В 2026 году значение этой дисциплины только выросло.
Теперь большой объём изменений может очень быстро создать не только программист. ИИ способен за несколько минут изменить десятки файлов, провести рефакторинг, написать тесты или перестроить целый модуль.
Чем быстрее появляется код, тем важнее понимать, что именно изменилось.
Git здесь работает почти идеально. Можно посмотреть разницу, проверить результат, собрать систему, прогнатьтесты и только после этого принять изменение.
Если результат плохой, можно просто вернуться назад.
ИИ резко снизил стоимость создания изменений. Значит, инструменты контроля этих изменений становятся ещё важнее.
Но у ИИ появилась другая проблема
Работая с ИИ, я постепенно увидел ещё одну аналогию с тем временем, когда мы хранили код в папках.
Сегодня знания, которыми пользуется ИИ, очень часто живут примерно так же.
Что-то написано в системной инструкции.
Что-то осталось в длинном диалоге.
Что-то находится в документах.
Что-то человек когда-то объяснил модели.
Через некоторое время становится трудно понять, почему ИИ вообще принял определённое решение. Какое правило он использовал? Кто его сформулировал? Оно всё ещё действительно? Не появилось ли потом другое правило, которое ему противоречит?
Это начинает напоминать старые каталоги с исходниками: текущее состояние вроде есть, но нормальной истории того, как мы к нему пришли, нет.
Отсюда появилась идея Sekura Noda
Именно поэтому в Sekura Noda мы пытаемся отделить знания от самой модели.
Идея для меня здесь очень похожа на то, что когда-то произошло с исходным кодом.
Знание должно существовать как отдельная управляемая сущность. Нужно понимать, кто его сформулировал, принято оно или ещё обсуждается, где оно применимо, с какими другими знаниями связано и как оно менялось со временем.
Тогда ИИ получает не просто очередной большой текст, который нужно как-то интерпретировать. Он получает зафиксированную систему знаний, состояние которой можно контролировать.
Это не означает, что Noda — буквально «Git для ИИ». Код и знания устроены по-разному.
Но сама инженерная потребность очень похожа.
Коду понадобилась история. Знаниям ИИ тоже
Когда-то мы поняли, что хранить только текущую копию исходного кода недостаточно.
Нам понадобилась история изменений.
Потом оказалось недостаточно и просто хранить историю. Понадобились автоматические сборки и тесты, которые подтверждают, что новое состояние всё ещё работоспособно.
Теперь похожий вопрос возникает для ИИ.
Недостаточно знать только текущий ответ модели. Всё важнее понимать, на основании каких знаний этот ответ появился и какое состояние этих знаний использовалось.
Если правило изменилось, хотелось бы видеть изменение. Если оно больше не действует — знать об этом. Если два знания противоречат друг другу — обнаружить конфликт, а не надеяться, что модель сама как-нибудь разберётся.
Для меня это естественное продолжение идеи контроля версий.
От Git к инженерной памяти ИИ
Git не делает программу правильной автоматически.
Он просто создаёт фундамент, без которого серьёзно контролировать разработку очень трудно.
С Noda я смотрю на знания примерно так же. Сам факт фиксации знания ещё не означает, что оно истинно. Но появляется возможность управлять им, проверять его статус и понимать происхождение решений.
Это особенно важно, если ИИ становится участником реальной инженерной или деловой работы.
Чем больше решений мы ему доверяем, тем меньше хочется иметь ситуацию:
«Почему он решил именно так?»
«Не знаю. Наверное, что-то было в промпте».
Для игрушечного помощника это допустимо. Для рабочей системы — уже не очень.
Ежедневные сборки для мира ИИ
Здесь мне особенно нравится параллель с третьим пунктом The Joel Test.
Для кода мы научились не только сохранять изменения, но и постоянно проверять новое состояние сборкой и тестами.
Для ИИ, думаю, постепенно придётся сделать то же самое со знаниями.
Изменилось правило — надо понимать, какие решения оно затронет.
Добавилось новое знание — проверить, не противоречит ли оно уже принятому.
Изменился контекст — понять, какие прежние выводы теперь устарели.
То есть одного «контроля версий знаний» тоже будет недостаточно. Понадобится проверка последствий изменений.
Мне кажется, именно туда постепенно будет двигаться инженерия систем с ИИ.
Что осталось от The Joel Test
Когда я вспоминаю свои старые папки с копиями программ, они сегодня кажутся почти смешными. Но когда-то это был совершенно естественный способ работы.
Потом я прочитал Джоэла, начал использовать CVS, позже Git, добавил регулярные сборки — и отношение к разработке изменилось фундаментально.
Мы перестали доверять собственной памяти и начали доверять воспроизводимому процессу.
Сегодня ИИ ставит перед нами похожую задачу уже на следующем уровне. Код научились сохранять, сравнивать, проверять и возвращать назад. Теперь нужно научиться так же серьёзно относиться к знаниям, которыми пользуются наши модели.
И поэтому первые пункты The Joel Test спустя четверть века я читаю уже немного шире:
фиксируй изменения, сохраняй историю, проверяй новое состояние и всегда понимай, откуда появился текущий результат.
Когда-то это изменило разработку программ.
Теперь, возможно, тот же принцип придётся применить к разработке систем с ИИ.

 Share








