
The post has been translated automatically. Original language: Russian



In a microservice architecture, a single user request is rarely handled by a single service. An application request can go through an API gateway, authentication service, scoring service, payment service, and notification service - and when a user complains that "everything is stuck for 8 seconds," the logs of each service individually do not answer the main question: where exactly did the time go out of this chain.
The problem is that the logs of different services live separately, and without a common connecting element, matching a specific user request with specific lines in the logs of five different services is an almost impossible task, especially under load, when thousands of similar requests are processed simultaneously.
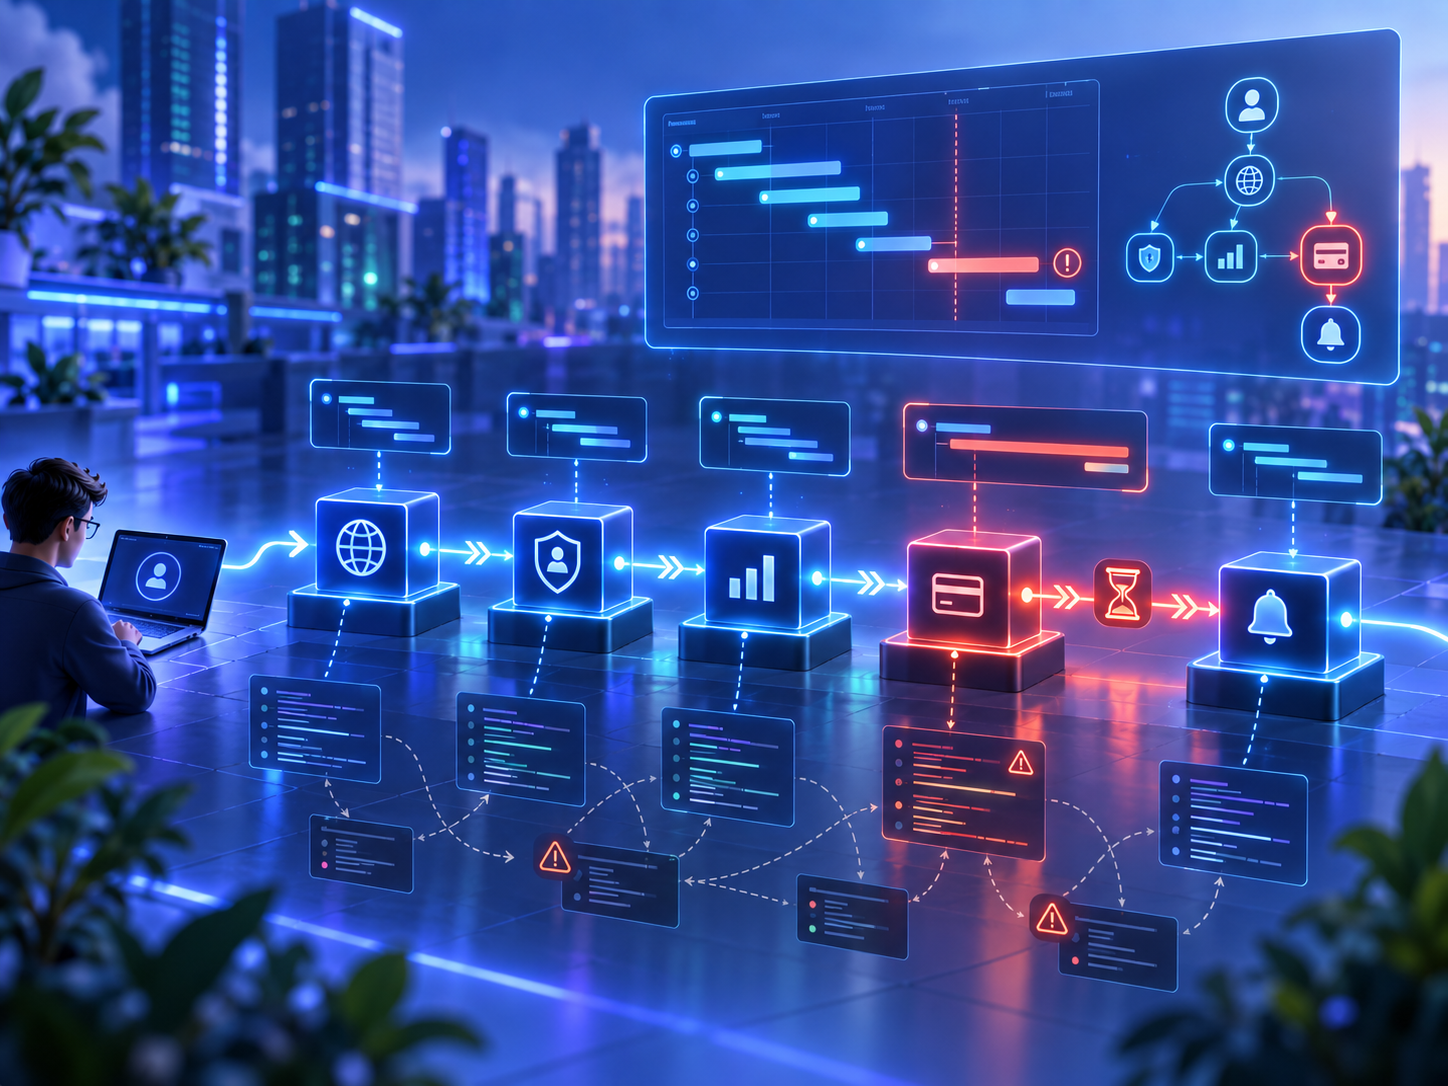
The solution is distributed tracing. The idea is simple: when a request is logged into the system, a unique trace ID is generated, and this identifier is transmitted along with the request through all the services that process it, usually via an HTTP header. Each service, processing a request, creates its own "span" (span) — a record of how long exactly its part of the work took — and binds this span to a common trace ID. As a result, using one identifier, you can get a complete picture: how long it took for each step of the chain, and which service turned out to be the bottleneck.
The practical value here is not only in finding performance issues after the fact. Tracing immediately shows the structure of the real dependencies between the services — that is, the fact that the notification service is synchronously called from the payment service and blocks the user's response, although logically this should not affect the payment speed in any way, it often becomes obvious from the tracing schedule, and not from the documentation, which becomes outdated faster than the code.
The implementation of tracing requires discipline at the level of the entire team: if at least one service in the chain does not forward the trace ID further when calling the next service, the chain ends at this point, and the rest of the request becomes "invisible" — formally, the trace seems to be there, but it does not give a real picture. That is why it makes sense to embed the tracing context at the level of a shared library or middleware, rather than relying on each developer to remember to add the necessary header manually in each new integration call.
В микросервисной архитектуре один пользовательский запрос редко обрабатывается одним сервисом. Запрос на оформление заявки может пройти через API-шлюз, сервис аутентификации, сервис скоринга, платёжный сервис и сервис уведомлений — и когда пользователь жалуется, что «всё зависло на 8 секунд», логи каждого сервиса по отдельности не отвечают на главный вопрос: а где именно из этой цепочки ушло время.
Проблема в том, что логи разных сервисов живут разрозненно, и без общего связующего элемента сопоставить конкретный запрос пользователя с конкретными строчками в логах пяти разных сервисов — практически невозможная задача, особенно под нагрузкой, когда одновременно обрабатываются тысячи похожих запросов.
Решение — распределённая трассировка (distributed tracing). Идея простая: при входе запроса в систему генерируется уникальный идентификатор трассировки (trace ID), и этот идентификатор передаётся дальше вместе с запросом через все сервисы, которые его обрабатывают — обычно через HTTP-заголовок. Каждый сервис, обрабатывая запрос, создаёт свой «спан» (span) — запись о том, сколько времени заняла именно его часть работы, — и привязывает этот спан к общему trace ID. В итоге по одному идентификатору можно собрать полную картину: сколько времени ушло на каждый шаг цепочки, и какой именно сервис оказался узким местом.
Практическая ценность здесь не только в поиске проблем производительности постфактум. Трассировка сразу показывает структуру реальных зависимостей между сервисами — то есть тот факт, что сервис уведомлений синхронно вызывается из платёжного сервиса и задерживает ответ пользователю, хотя логически это никак не должно влиять на скорость оплаты, часто становится очевиден именно из графика трассировки, а не из документации, которая устаревает быстрее, чем код.
Внедрение трассировки требует дисциплины на уровне всей команды: если хотя бы один сервис в цепочке не пробрасывает trace ID дальше при вызове следующего сервиса, цепочка обрывается в этом месте, и дальнейшая часть запроса становится «невидимой» — формально трассировка вроде бы есть, но реальной картины она не даёт. Именно поэтому пробрасывание контекста трассировки имеет смысл встраивать на уровне общей библиотеки или middleware, а не полагаться на то, что каждый разработчик не забудет добавить нужный заголовок вручную в каждом новом интеграционном вызове.
 Share