
The post has been translated automatically. Original language: Russian




Chinese data center under water: how the infrastructure works for the era of artificial intelligence
An underwater data processing center is already operating in Shanghai, which uses seawater for natural cooling, and receives electricity from an offshore wind farm located nearby.
The project is located about 10 km from the coast. The modules with servers are located underwater at a depth of about 35 meters. The total capacity of the project is 24 MW, with investments of about 1.6 billion yuan ($226 million).
The main idea is to combine computing power, cooling and renewable energy in one infrastructure.
Due to natural cooling by seawater, the project, according to the Chinese side, reduces energy consumption by 22.8% compared to land-based solutions of a similar scale and does not use fresh water for cooling.
The center is designed, among other things, for tasks related to big data and artificial intelligence. In May 2026, the facility switched to full-fledged commercial operation.
Underwater data centers are still a specialized solution, but this project shows how the approach to creating computing infrastructure is changing.: energy, cooling, and computing are beginning to be designed as a single system.
Sources: Shanghai Lingang, Shanghai Municipal Government, Data Center Dynamics.
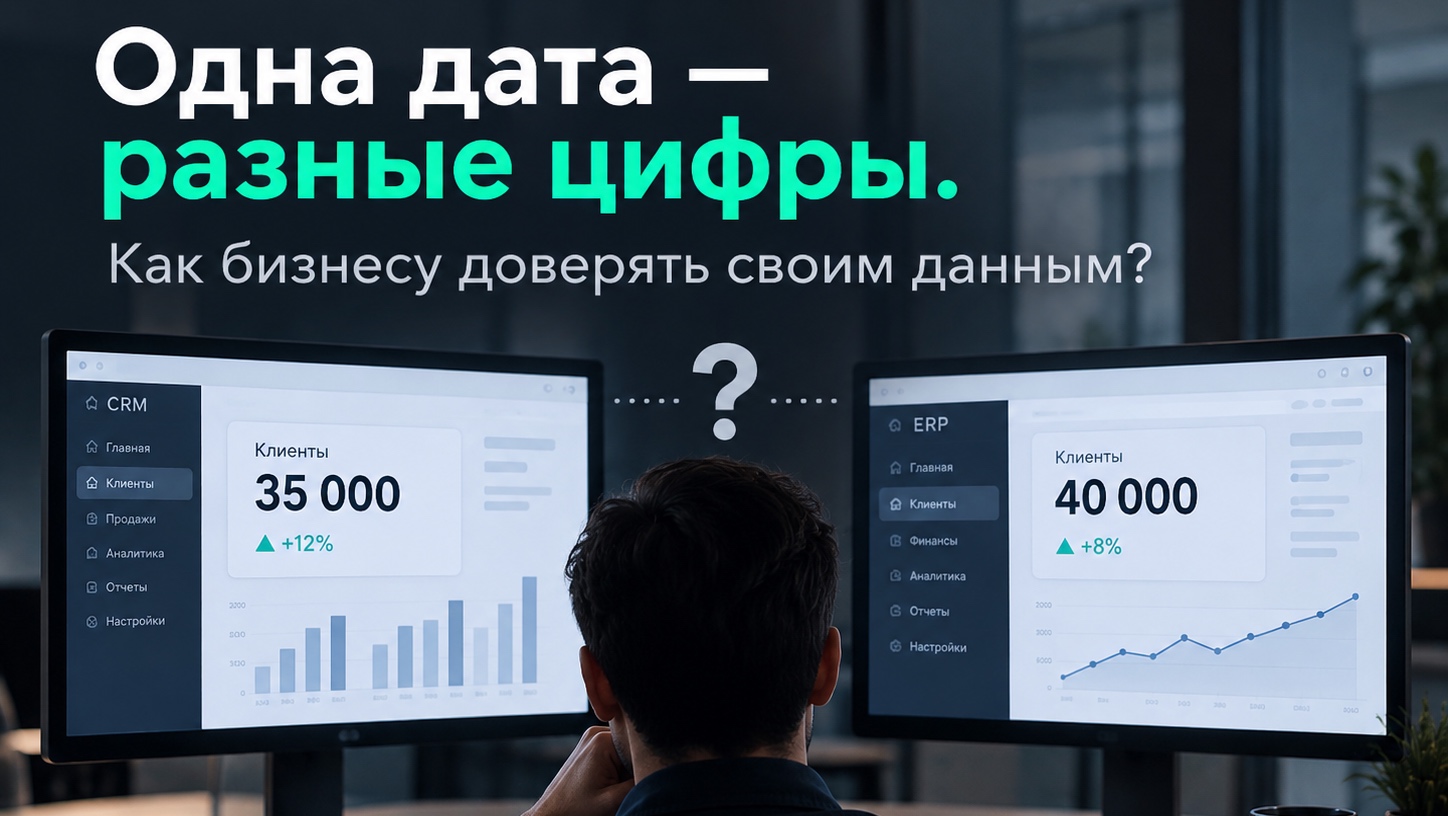
Одна дата — разные цифры: как доверять своим данным?
Сегодня компании используют множество информационных систем: CRM, ERP, аналитические платформы и хранилища данных. Информация из разных источников объединяется и используется для подготовки отчётности и принятия решений.
Но что делать, если одна и та же метрика в разных системах имеет разные значения?
Например, одна система показывает 35 тысяч клиентов, а другая — 40 тысяч. Какая цифра верная?
Откуда берутся расхождения?
Чаще всего проблема возникает на этапе сбора, интеграции и обработки данных. Разные системы и подразделения могут использовать разные правила расчёта и классификации.
Причинами могут быть:
- неполные данные;
- разные правила расчёта показателей;
- различия в бизнес-логике;
- ошибки при передаче и трансформации данных;
- разная классификация одних и тех же объектов.
Практический пример
При анализе клиентской базы банка для МСБ обнаружилось расхождение: финансовый блок учитывал 35 тысяч клиентов, а бизнес-блок — 40 тысяч.
Анализ показал, что часть клиентов по-разному относилась к сегменту МСБ, а подразделения использовали разные критерии классификации.
Таким образом, проблема оказалась не в самих цифрах, а в разных правилах работы с данными.
Как решить проблему?
Один из подходов — внедрять контроль качества данных непосредственно в процессы их обработки — ETL/ELT.
Проверки позволяют контролировать:
- полноту и корректность данных;
- наличие аномалий и противоречий;
- соответствие данных исходным системам;
- соблюдение бизнес-правил.
Это помогает обнаруживать ошибки ещё до того, как данные попадут в отчёты и аналитические модели.
Качественная аналитика начинается с качественных данных. Если разные подразделения работают с разными версиями одной метрики, доверие к аналитике снижается. Поэтому контроль качества данных становится важной частью современной IT-архитектуры.
 Share