
The post has been translated automatically. Original language: Russian


When we first started, everyone asked: why such a narrow niche? Build a platform, scale up!
But we chose a different path. Here's why.
Context: where it all began
About a year ago, we faced the classic dilemma of a tech startup founder.
On one hand — an ambitious vision: a predictive analytics platform for industry, an intelligent layer on top of existing monitoring systems, a scalable solution across dozens of verticals.
On the other — the harsh reality: we had neither labeled data, nor market trust, nor proof that our methodology actually worked.
We could have taken the first path. Start with bold statements, pitch decks for investors, attempts to sell a “vision” to corporations. Many do exactly that.
But we chose a different approach: find a sharp, measurable problem in a narrow niche and prove our method on it.
That problem was fuel drain detection in the agricultural sector and commercial transport.
Why not a "more ambitious" direction?
Let’s be honest: as a DeepTech startup founder, there’s always a temptation to go big right away.
“We’re building a platform for all of industry!” “Our AI will predict everything!” “We’ll scale across 10 verticals!”
Sounds impressive. But there are three problems:
Problem 1: No evidence base
When you approach a corporation or an investor saying “we’re building a predictive analytics platform,” the first question will be: “Where’s the proof your methodology works?”
If your answer is: “We have a deck and a vision” — the conversation ends.
If your answer is: “We have a working product running in real conditions, with 90% accuracy on real data, here’s a year of statistics” — the conversation begins.
Problem 2: Data collection complexity
Any machine learning system, especially in Industrial AI, requires labeled data. A lot of it.
If you try to cover 10 industries at once, you need to collect and label data from all of them. That’s years of work and millions in funding.
If you focus on one niche, you can dive deep into the context, understand the physics of the processes, and build a high-quality dataset.
Problem 3: Market trust
Industry is a conservative environment. They don’t believe in words. They believe in results.
When you come with “a platform for everything,” you look like yet another startup with a pitch deck.
When you come with “a solution to a specific problem already running at 26 companies,” you look like a practitioner.
Our strategy: prove the methodology on a sharp use case
We formulated a simple principle for ourselves: choose a task where the pain is acute, the result is measurable, and the context is clear.
Fuel drain detection fit these criteria perfectly.
Acute pain: every drain is a direct loss. In agriculture, where margins are thin, losing even 10 liters of fuel on a single vehicle is noticeable. When there are dozens of such cases per month, it becomes serious money.
Measurable result: either there was a drain, or there wasn’t. Either the system got it right, or it got it wrong. No room for interpretation. This is an ideal task for training and validation.
Clear context: vehicle telemetry, fuel level sensor data, GPS coordinates, speed, operating mode. All of this is structured data already collected by monitoring systems.
But most importantly — we understood that fuel drain detection was not the end goal, but a proving ground for the methodology.
What we built
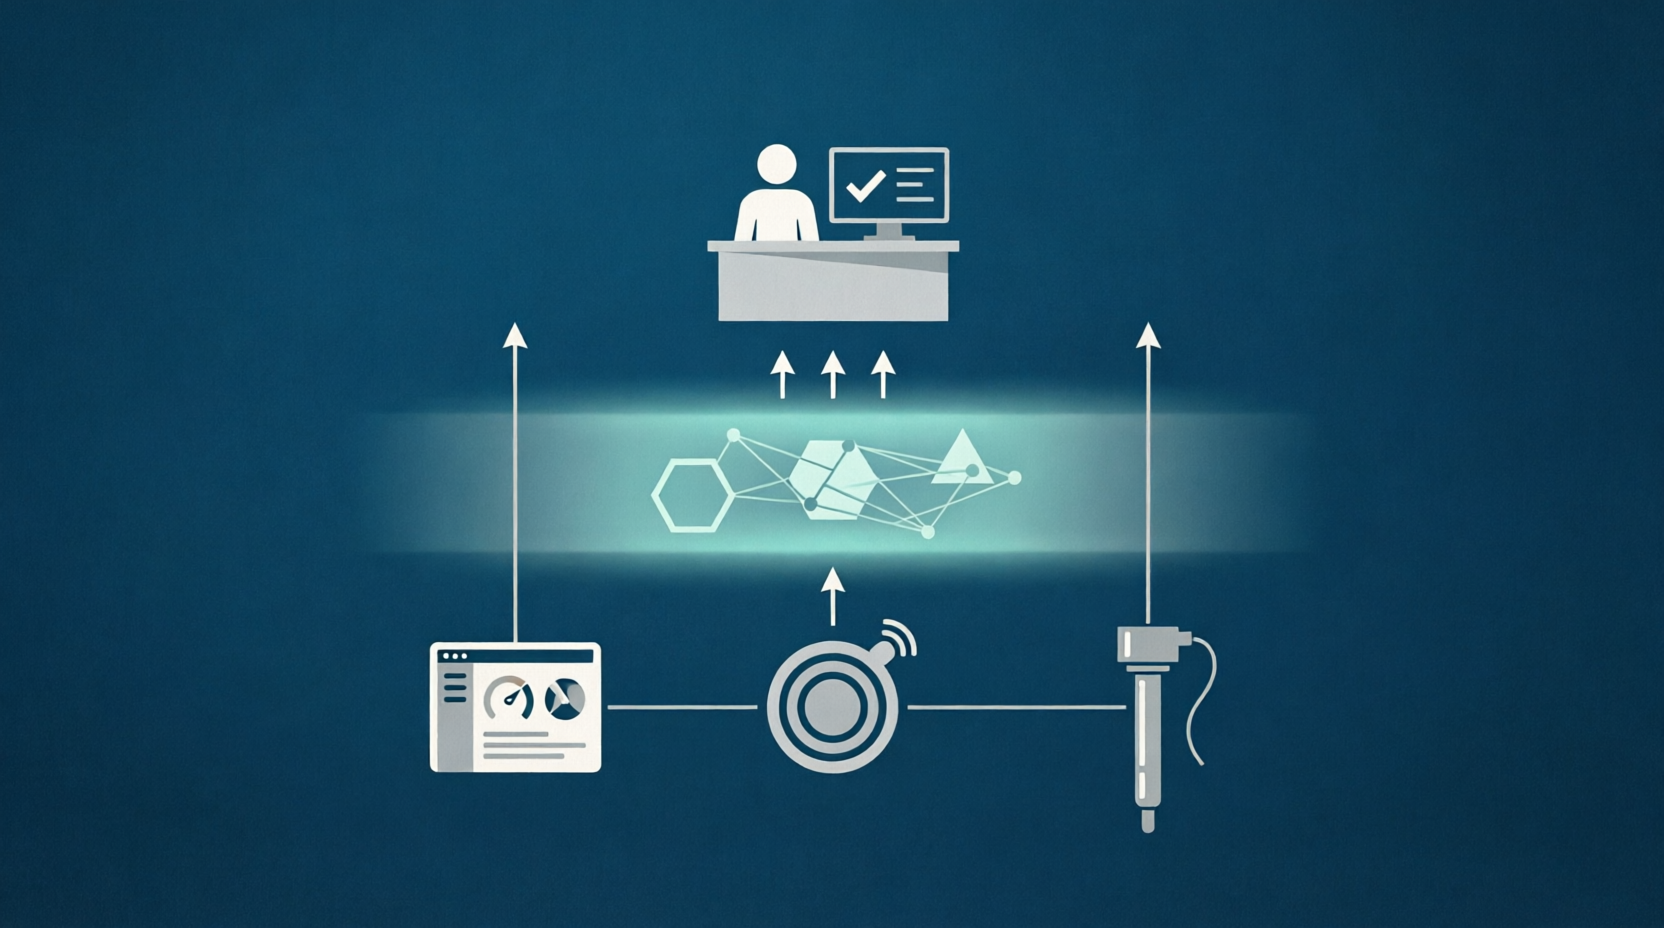
Over 10 months, we created a system that works as an intelligent layer on top of existing monitoring platforms (Fort-Monitor, Wialon, and others).
The essence is simple: monitoring systems generate fuel level change events. But they cannot distinguish a real drain from a false trigger. The system analyzes each event and delivers a reasoned verdict.
How it works:
● Ensemble of algorithms: We use an ensemble of machine learning algorithms. This is not a single model, but a combination of approaches: anomaly detection, classification, and heuristic rules. Each component contributes to the final verdict.
● Contextual analysis: The system analyzes context: a telemetry window of 24 hours before the event and 3 hours after. It looks at the vehicle’s operating mode, speed, environmental conditions, and anomalies in connectivity and positioning.
● Explainable AI: Every decision is accompanied by a textual explanation. When the system says “this is a drain,” it explains why. This is critical for trust from dispatchers and security teams.
● Human-in-the-loop: User decisions (confirming or rejecting a verdict) are used to retrain the models. The system gets smarter with every user.
● On-demand operation: We don’t do continuous monitoring. The system analyzes events on request, when they occur. This reduces load and allows focus on truly important incidents.
● Multi-platform: The architecture allows connecting different monitoring systems through a unified interface. We are not tied to a single platform.
Results we achieved
Today, six months later, we have:
A working product in real conditions:
● 26 companies under monitoring
● Around 1,800 tracked vehicles
● About 80,000 events analyzed (August 2025 — August 2026)
● Verification accuracy: around 90% on real data, and it grows with every user
All data is based on the system's internal operational statistics for the period August 2025 — August 2026.
Strategic partnership: We are collaborating with integrators in the agricultural sector to validate our methodology. They are not just a client — they participate in data labeling for model retraining. This partnership gave us access to real data and domain expertise.
Ready to scale : We are exploring integration opportunities with various monitoring platforms. This will open access to thousands of potential users.
A proven methodology: We have proven that our approach works. Ensemble algorithms, explainable AI, human-in-the-loop, contextual analysis — all of this is not theory, but working practice.
Lessons we learned
Lesson 1: A narrow niche is not a limitation — it’s focus
When you focus on one problem, you can solve it really well. You deeply understand the context, the physics of the processes, the users’ pain points.
This gives you the right to say: “I’m an expert in this area.” And then, when you expand, you bring that expertise with you.
Lesson 2: Evidence base matters more than vision
Investors, corporations, partners — they all want to see results. Not slides with a vision, but real metrics, cases, testimonials.
A narrow niche allows you to build this evidence base quickly. You can show: “Here are 26 companies, here are 80,000 events, here’s 90% accuracy.”
Lesson 3: data without expertise is just numbers
We spent about 200 hours manually labeling the first dataset. It was painful, slow, and expensive.
But without that labeling, the ensemble of algorithms wouldn’t have worked. Experts label data differently than “regular” users. They see patterns that aren’t obvious.
We learned to value domain expertise. Now we don’t just collect data — we collect knowledge.
Lesson 4: The human must stay in the loop
Initially, we were tempted to build a fully automated system. “The AI will decide everything on its own, no human intervention needed.”
But we quickly realized: in industry, this doesn’t work. Dispatchers, security teams, operators — they need to understand why the system made a particular decision. They need to be able to challenge a verdict.
Human-in-the-loop is not a limitation — it’s an advantage. Operators make the system smarter, and the system helps operators make decisions faster.
Lesson 5: Data quality matters more than fleet size
Out of 26 companies, three generate about 60% of all events. This is the Pareto distribution in action.
But there’s another insight: companies with well-configured monitoring produce fewer events, but these events are higher quality. Companies with poorly configured monitoring generate a lot of “noise.”
We learned to work with both types of clients. But most importantly — we realized that the problem is not in the sensors, but in the interpretation of data.
The strategic horizon
Fuel drain detection is just the beginning.
The methodology we refined on this task scales to other industries. The principles of explainable AI, human-in-the-loop, contextual analysis, and on-premise deployment — all of this is universal.
We are moving from incident detection to predictive analytics. From “record the fact” to “predict the event.”
But more on that in future posts. For now, the important point was this: we are not just talking about methodology — we have proven it on real data.
______________________________________________________________________________
Colleagues, share your experience: how did you choose your first niche? Did you go big right away, or start with a narrow task?
What was harder: finding a sharp problem, or proving that your solution works?
I’d be glad to exchange experiences in the comments
#BuildingInPublic, #DeepTech, #IndustrialAI, #StartupJourney, #AstanaHub
Когда мы только начинали, все говорили: зачем вам эта узкая ниша? Делайте платформу, масштабируйтесь!
Но мы выбрали другой путь. И вот почему.
Контекст: с чего всё начиналось
Около года назад мы стояли перед классическим выбором фаундера технологического стартапа.
С одной стороны — амбициозное видение: платформа предиктивной аналитики для промышленности, интеллектуальный слой поверх существующих систем мониторинга, масштабируемое решение для десятков отраслей.
С другой — суровая реальность: у нас не было ни размеченных данных, ни доверия рынка, ни доказательств того, что наша методология вообще работает.
Мы могли бы пойти первым путём. Начать с громких заявлений, презентаций для инвесторов, попыток продать «видение» корпорациям. Так делают многие.
Но мы выбрали иной путь: найти острую, измеримую проблему в узкой нише и доказать на ней, что наш подход работает.
Этой проблемой стала детекция сливов топлива в агросекторе и коммерческом транспорте.
Почему не «более амбициозное» направление?
Давайте честно: когда ты фаундер DeepTech-стартапа, всегда есть соблазн сразу замахнуться на большое.
«Мы делаем платформу для всей промышленности!» «Наш ИИ будет предсказывать всё!» «Мы масштабируемся на 10 отраслей!»
Звучит круто. Но есть три проблемы:
Проблема 1: отсутствие доказательной базы
Когда вы приходите к корпорации или инвестору с заявлением «мы делаем платформу предиктивной аналитики», первый вопрос будет: «А где доказательства, что ваша методология работает?»
Если вы отвечаете: «У нас есть презентация и видение», — разговор заканчивается.
Если вы отвечаете: «У нас есть работающий продукт, который эксплуатируется в реальных условиях, с точностью 90% на реальных данных, вот статистика за год», — разговор начинается.
Проблема 2: сложность сбора данных
Любая система машинного обучения, особенно в industrial AI, требует размеченных данных. Много размеченных данных.
Если вы пытаетесь сразу охватить 10 отраслей, вам нужно собрать и разметить данные из всех этих отраслей. Это годы работы и миллионы тенге/рублей/долларов (нужное подчеркнуть).
Если вы фокусируетесь на одной нише, вы можете глубоко погрузиться в контекст, понять физику процессов, собрать качественный датасет.
Проблема 3: доверие рынка
Промышленность — консервативная среда. Здесь не верят словам. Здесь верят результатам.
Когда вы приходите с «платформой для всего», вы выглядите как ещё один стартап с презентацией.
Когда вы приходите с «решением конкретной проблемы, которое уже работает у 26 компаний», вы выглядите как практик.
Наша стратегия: доказать методологию на остром кейсе
Мы сформулировали для себя простой принцип: выбрать задачу, где боль острая, результат измеримый, а контекст понятный.
Детекция сливов топлива идеально подходила под эти критерии.
Острая боль: каждый слив — это прямые убытки. В агросекторе, где маржа тонкая, потеря даже 10 литров топлива на технике — это ощутимо. А когда таких случаев десятки в месяц, это уже серьёзные деньги.
Измеримый результат: либо слив был, либо не был. Либо система определила правильно, либо ошиблась. Нет пространства для интерпретаций. Это идеальная задача для обучения и валидации.
Понятный контекст: телеметрия транспорта, данные с датчиков уровня топлива, GPS-координаты, скорость, режим работы. Всё это структурированные данные, которые уже собираются системами мониторинга.
Но главное — мы понимали, что детекция сливов это не конечная цель, а полигон для отработки методологии.
Что мы построили
За 10 месяцев мы создали систему, которая работает как интеллектуальная надстройка над существующими системами мониторинга (Форт-Монитор, Wialon).
Суть проста: системы мониторинга генерируют события по сливам топлива. Но они не отличают реальный слив от ложного срабатывания. Система анализирует каждое событие.
Как это работает:
В подходе используется ансамбль алгоритмов. Это не одна модель, а комбинация подходов: обнаружение аномалий, классификация, эвристические правила. Каждый компонент вносит свой вклад в итоговый вердикт.
Система анализирует контекст: окно телеметрии за 24 часа до события и 3 часа после. Она смотрит на режим работы техники, скорость, условия окружающей среды, аномалии связи и позиционирования.
Каждое решение сопровождается текстовым обоснованием. Когда система говорит «это слив», она объясняет почему. Это критично для доверия со стороны диспетчеров и служб безопасности.
Human-in-the-loop: решения пользователей (подтверждение или опровержение вердикта) используются для дообучения моделей. Система становится умнее с каждым пользователем.
Работа по запросу: мы не делаем непрерывный мониторинг. Система анализирует события по запросу, когда они возникают. Это снижает нагрузку и позволяет фокусироваться на действительно важных инцидентах.
Мультиплатформенность: архитектура позволяет подключать разные системы мониторинга через единый интерфейс. Мы не привязаны к одной платформе.
Результаты, которые мы получили
Сегодня, спустя полгода, у нас есть:
Работающий продукт в реальных условиях:
● 26 компаний на мониторинге
● Около 1800 объектов техники
● Около 80 000 событий проанализировано (август 2025 — август 2026).
● Точность верификации: около 90% на реальных данных, и она растёт с каждым пользователем
Все данные основаны на внутренней статистике эксплуатации системы за период август 2025 — август 2026.
Стратегическое партнёрство: Мы сотрудничаем с интеграторами агросектора для валидации методологии. Они не просто клиенты — они участвуют в разметке данных для дообучения моделей. Это партнёрство дало нам доступ к реальным данным и экспертизе предметной области.
Готовность к масштабированию: Мы исследуем возможности интеграции с различными платформами мониторинга. Это откроет доступ к тысячам потенциальных пользователей.
Доказанная методология: Мы доказали, что наш подход работает. Ансамбль алгоритмов, объяснимый ИИ, human-in-the-loop, контекстный анализ — всё это не теория, а работающая практика.
Уроки, которые мы извлекли
Урок 1: узкая ниша — это не ограничение, это фокус
Когда ты фокусируешься на одной проблеме, ты можешь решить её действительно хорошо. Ты глубоко понимаешь контекст, физику процессов, боли пользователей.
Это даёт тебе право говорить: «Я эксперт в этой области». А потом, когда ты расширяешься, ты приносишь эту экспертизу с собой.
Урок 2: доказательная база важнее видения
Инвесторы, корпорации, партнёры — все они хотят видеть результаты. Не слайды с видением, а реальные метрики, кейсы, отзывы.
Узкая ниша позволяет быстро собрать эту доказательную базу. Ты можешь показать: «Вот 26 компаний, вот 80 000 событий, вот точность 90%».
Урок 3: данные без экспертизы — просто цифры
Мы потратили около 200 часов на ручную разметку первого датасета. Это было болезненно, долго, дорого.
Но без этой разметки ансамбль алгоритмов не работал бы. Эксперты размечают данные иначе, чем «обычные» пользователи. Они видят паттерны, которые не очевидны.
Мы научились ценить экспертизу предметной области. Теперь мы не просто собираем данные — мы собираем знания.
Урок 4: человек должен оставаться в контуре
Изначально у нас был соблазн сделать полностью автоматизированную систему. «ИИ сам всё решит, человеку не нужно вмешиваться».
Но мы быстро поняли: в промышленности это не работает. Диспетчеры, службы безопасности, операторы — они должны понимать, почему система приняла то или иное решение. Они должны иметь возможность оспорить вердикт.
Human-in-the-loop — это не ограничение, это преимущество. Операторы делают систему умнее, а система помогает операторам принимать решения быстрее.
Урок 5: качество данных важнее размера парка
Из 26 компаний три генерируют около 60% всех событий. Это распределение Парето в действии.
Но есть и другой инсайт: компании с отлично настроенным мониторингом дают меньше событий, но эти события более качественные. Компании с плохо настроенным мониторингом генерируют много «шума».
Мы научились работать с обоими типами клиентов. Но главное — мы поняли, что проблема не в датчиках, а в интерпретации данных.
Стратегический горизонт
Детекция сливов топлива — это только начало.
Методология, которую мы отработали на этой задаче, масштабируется на другие отрасли промышленности. Принципы объяснимого ИИ, human-in-the-loop, контекстного анализа, локального развёртывания — всё это универсально.
Мы движемся от детекции инцидентов к предиктивной аналитике. От «зафиксировать факт» к «предсказать событие».
Но об этом — в следующих публикациях. Сейчас важно было показать: мы не просто говорим о методологии, мы её доказали на реальных данных.
______________________________________________________________________________
Коллеги, поделитесь опытом: как вы выбирали свою первую нишу? Сразу замахивались на большое или начинали с узкой задачи?
Что было сложнее: найти острую проблему или доказать, что ваше решение работает?
Буду рад обменяться опытом в комментариях.
#BuildingInPublic, #DeepTech, #IndustrialAI, #StartupJourney, #AstanaHub
 Share