
The post has been translated automatically. Original language: Russian



From the side, the exam preparation apps look very similar. There is a list of tasks, a timer, an answer field, a voice recording and a final result. Therefore, it seems logical to assemble one universal constructor, replace the exam name and upload a new set of questions.
In practice, this is where most silent mistakes start. The interface continues to work, the buttons are pressed, the answers are saved — but the learning scenario no longer corresponds to the exam that the person is preparing for.
At SmartPrep Labs, we develop separate mobile applications for different language and immigration exams. The general technical framework is really worth reusing. But the rules of a particular exam should remain an independent product contract.
The same screens don't mean the same mechanics.
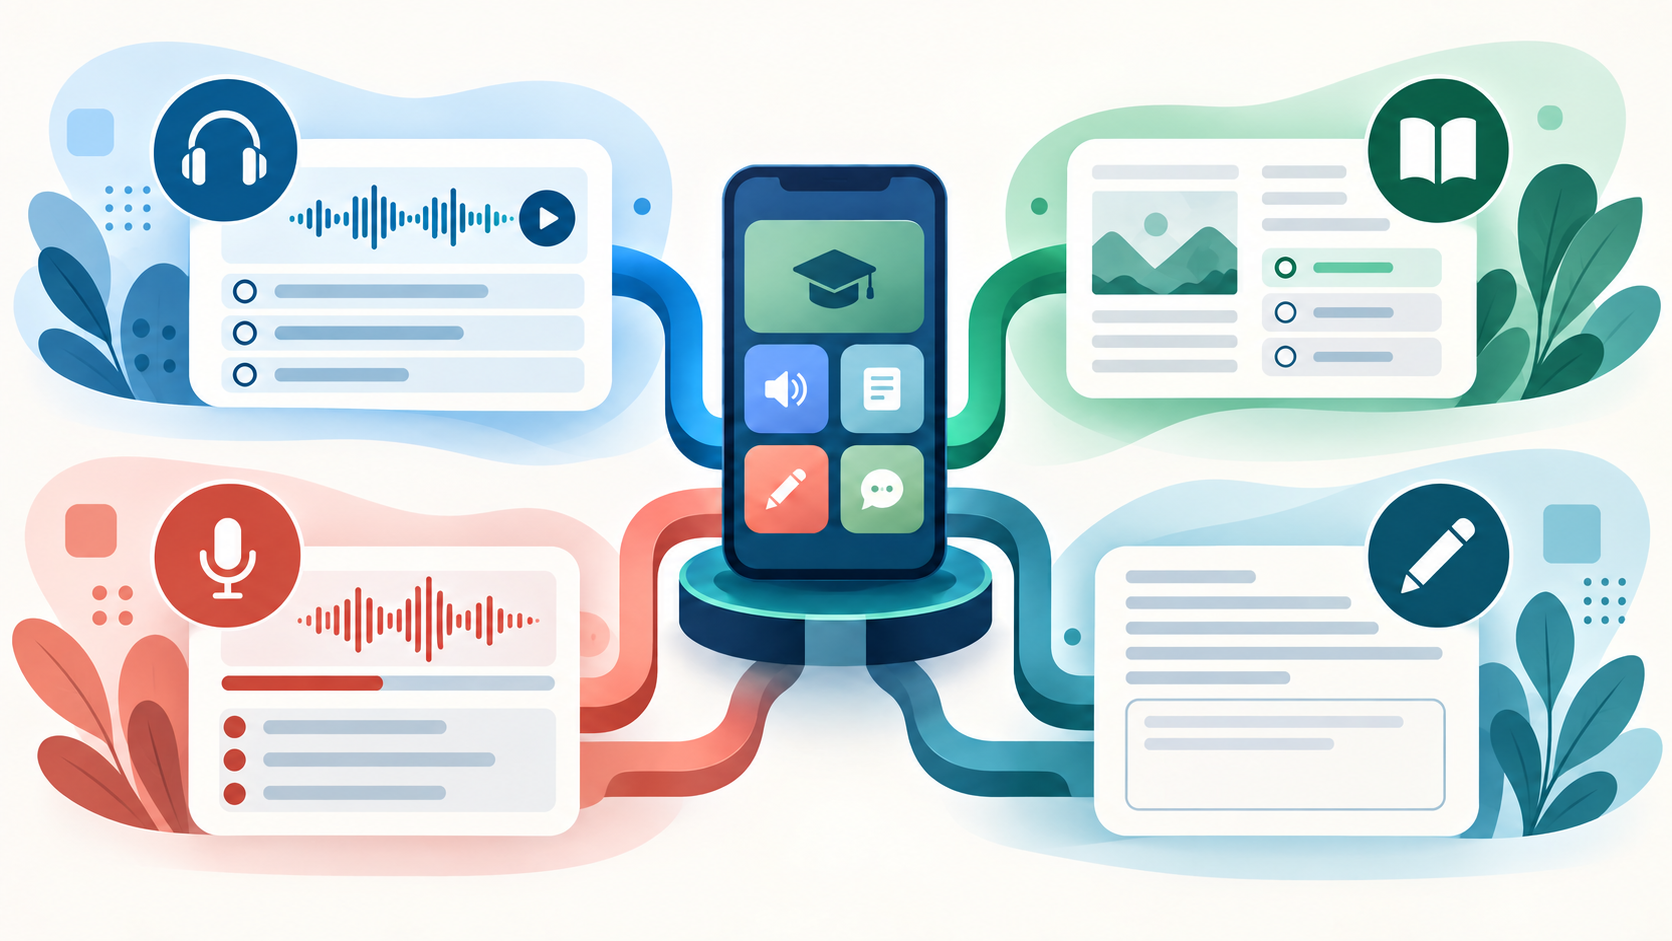
The two exams may include reading, writing, listening, and the oral part, but the coincidence of the section names says little about the actual user path.
They may differ:
- the order of the parts;
- number of tasks per session;
- a way to switch between questions;
- the ability to return to the previous answer;
- rules for starting and replaying recordings;
- preparatory time before the oral answer;
- restrictions on the length of the text;
- the method of calculating and displaying the result.
If you store all this in one set of conditional switches, a fragile system appears over time: a change for one exam unexpectedly changes the behavior of another. Moreover, the error may remain unnoticed by the developer — the application did not crash, the user simply trained according to the wrong rules.
The exam format is not an interface setting.
We refer the format to data that must be explicitly described and verified. Each exam needs a separate profile: which sections exist, how they follow each other, how long the stage lasts, what the user is allowed to do, and when the attempt is considered completed.
It is useful to store such a profile not as a long text for a command, but in a form that the program can check. Then a change in the timer or the order of sections will immediately appear in the tests, and not after the user's complaint.
This is especially important when updating the official format. It's not enough for the team to remember that "nothing serious seems to have changed." You need to record the date of the source verification, the new version of the rules, and specific differences from the previous version.
Related tasks cannot be broken
Another common problem occurs with assignments that use a common source: one text, one audio recording, an image, or a situation.
If the application receives the questions in a simple list and shows them one at a time, the related items easily end up in different places. The user sees the question, but does not understand which text or fragment of the record it refers to. Sometimes the recording is played again for each question, although according to the script it should be played once for the whole group.
Therefore, the main unit of training should not be a single question, but a completed training block. The general source, the order of questions, and the navigation rules are stored inside it. Later, this block can be used in practice, a trial exam, or error analysis.
This approach looks less universal at the database level, but it is much more honest for the user.
The timer is part of the state, not a decorative counter.
The timer is often perceived as an element of the screen: you opened the task, started the countdown, closed the screen, and started over. This is not enough for real exam training.
You need to decide in advance what happens if a person has minimized the application, received a call, lost the Internet, or opened an attempt again. Is time running out? Is the response saved? Is it possible to continue the same session? When is the attempt deducted from the available limit?
The answers to these questions may vary for different exams and modes. But in any case, the behavior should be predictable. The user does not have to figure out which part of the state lived only on the screen, and which has already been saved on the server.
The oral and written parts require different evidence
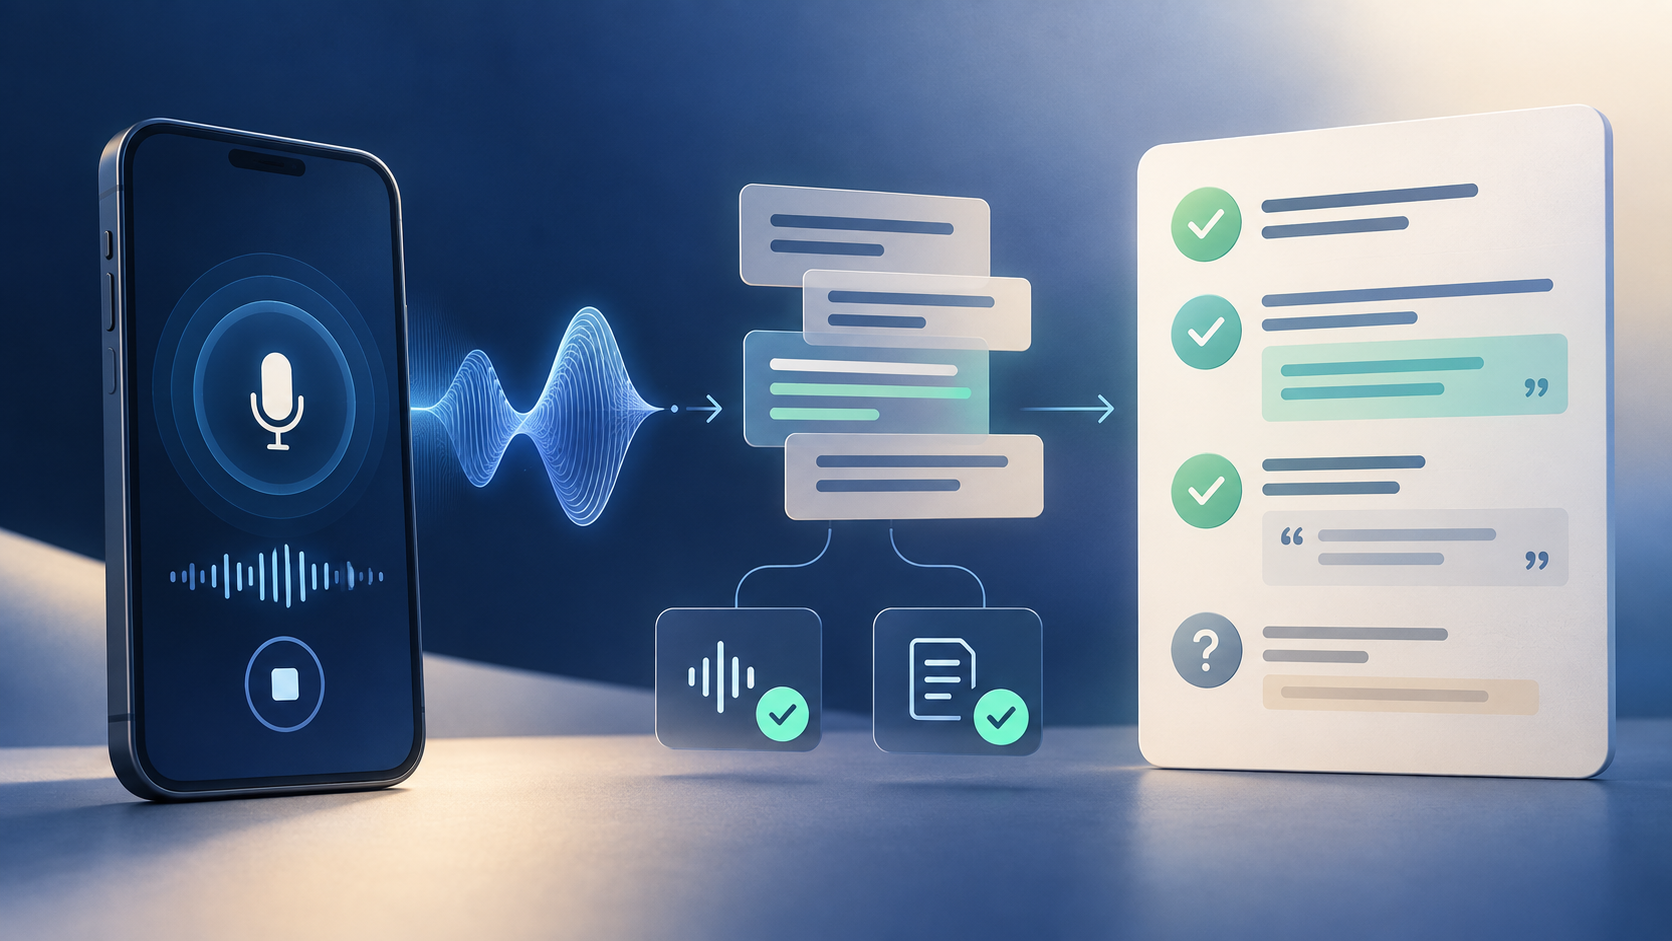
Versatility is especially dangerous in feedback. For a written response, the source material is the user's text. For oral communication, first recording, then decoding, and only after that analyzing the language.
If you use the same report template, the system starts hiding important borders. For example, a remark to an oral response may be the result of a recognition error, and the pronunciation score may be a number that was not calculated based on sound at all.
Therefore, the report should show what each conclusion is based on. For an oral attempt, the recording and the original transcript are saved separately. For written — original text. The corrected version does not replace the user's material, but exists next to it.
What can still be reused?
Abandoning universal exam logic does not mean that every application needs to be built from scratch.
Common ones can be:
- secure storage of attempts;
- authorization and recovery of status;
- subscription verification;
- media download;
- history of results;
- processing repeated requests;
- analysis of technical errors;
- basic interface components.
This is the platform layer. It is responsible for the reliability and equally understandable behavior of applications.
The examination layer is located above it.: the structure of sections, types of tasks, timers, rules for transitions and calculation of the result. And above that, there is verified content that applies only to a specific exam and a specific version of its format.
This separation provides a useful compromise: the team does not duplicate the infrastructure, but also does not force different exams to live according to the same artificial scenario.
A small checklist
Before adding a new exam to an existing platform, it is useful to answer a few questions:
1. Is there a separate description of the current official format?
2. Are the order of sections, timers, and navigation rules fixed?
3. Are the questions grouped with a common text or notation into whole blocks?
4. Is the format checked by automatic tests?
5. Is exam logic separated from common screens and services?
6. Does the attempt persist when minimizing and reopening the application?
7. Is it clear to the user what data was used for feedback?
8. Is it possible to update one exam without changing the behavior of the others?
A universal interface can be convenient. Universal exam rules are almost always a risk. A good platform reuses the infrastructure, but leaves each exam with its own testable logic. It is this boundary that helps to scale the product without imperceptible loss of accuracy.
Со стороны приложения для подготовки к экзаменам выглядят очень похоже. Есть список заданий, таймер, поле для ответа, запись голоса и итоговый результат. Поэтому кажется логичным собрать один универсальный конструктор, заменить название экзамена и загрузить новый набор вопросов.
На практике именно здесь начинается большинство тихих ошибок. Интерфейс продолжает работать, кнопки нажимаются, ответы сохраняются — но учебный сценарий уже не соответствует тому экзамену, к которому готовится человек.
В SmartPrep Labs мы развиваем отдельные мобильные приложения для разных языковых и иммиграционных экзаменов. Общую техническую основу действительно стоит переиспользовать. Но правила конкретного экзамена должны оставаться самостоятельным продуктовым контрактом.
Одинаковые экраны ещё не означают одинаковую механику
Два экзамена могут включать чтение, письмо, аудирование и устную часть, но совпадение названий секций мало что говорит о реальном пользовательском пути.
Отличаться могут:
- порядок частей;
- количество заданий в одной сессии;
- способ перехода между вопросами;
- возможность вернуться к предыдущему ответу;
- правила запуска и повторного воспроизведения записи;
- подготовительное время перед устным ответом;
- ограничения по длине текста;
- способ расчёта и отображения результата.
Если хранить всё это в одном наборе условных переключателей, со временем появляется хрупкая система: изменение для одного экзамена неожиданно меняет поведение другого. Причём ошибка может остаться незаметной разработчику — приложение не упало, просто пользователь тренировался не по тем правилам.
Формат экзамена — это не настройка интерфейса
Мы относим формат к данным, которые должны быть явно описаны и проверены. Для каждого экзамена нужен отдельный профиль: какие секции существуют, как они идут друг за другом, сколько длится этап, что разрешено пользователю и когда попытка считается завершённой.
Такой профиль полезно хранить не в виде длинного текста для команды, а в форме, которую может проверить программа. Тогда изменение таймера или порядка секций сразу проявится в тестах, а не после жалобы пользователя.
Это особенно важно при обновлении официального формата. Команде недостаточно помнить, что «вроде бы ничего серьёзного не поменялось». Нужно зафиксировать дату проверки источника, новую версию правил и конкретные отличия от предыдущей версии.
Связанные задания нельзя разрывать
Ещё одна распространённая проблема возникает с заданиями, которые используют общий источник: один текст, одну аудиозапись, изображение или ситуацию.
Если приложение получает вопросы простым списком и показывает их по одному, связанные элементы легко оказываются в разных местах. Пользователь видит вопрос, но не понимает, к какому тексту или фрагменту записи он относится. Иногда запись запускается повторно для каждого вопроса, хотя по сценарию она должна прозвучать один раз для всей группы.
Поэтому основной единицей тренировки должен быть не отдельный вопрос, а законченный учебный блок. Внутри него сохраняются общий источник, порядок вопросов и правила навигации. Уже потом этот блок можно использовать в практике, пробном экзамене или разборе ошибок.
Такой подход выглядит менее универсальным на уровне базы данных, зато гораздо честнее для пользователя.
Таймер — это часть состояния, а не декоративный счётчик
Таймер часто воспринимают как элемент экрана: открыли задание, запустили обратный отсчёт, закрыли экран — начали заново. Для реальной экзаменационной тренировки этого недостаточно.
Нужно заранее решить, что происходит, если человек свернул приложение, получил звонок, потерял интернет или открыл попытку снова. Время продолжается? Ответ сохранён? Можно ли продолжить ту же сессию? Когда попытка списывается из доступного лимита?
У разных экзаменов и режимов ответы на эти вопросы могут отличаться. Но в любом случае поведение должно быть предсказуемым. Пользователь не обязан разбираться, какая часть состояния жила только на экране, а какая уже сохранилась на сервере.
Устная и письменная части требуют разных доказательств
Универсальность особенно опасна в обратной связи. Для письменного ответа исходным материалом является текст пользователя. Для устного — сначала запись, затем расшифровка, и только после этого анализ языка.
Если использовать один и тот же шаблон отчёта, система начинает скрывать важные границы. Например, замечание к устному ответу может оказаться следствием ошибки распознавания, а оценка произношения — числом, которое вообще не было рассчитано по звуку.
Поэтому отчёт должен показывать, на чём основан каждый вывод. Для устной попытки отдельно сохраняются запись и исходная расшифровка. Для письменной — оригинальный текст. Исправленный вариант не заменяет материал пользователя, а существует рядом с ним.
Что всё-таки можно переиспользовать
Отказ от универсальной экзаменационной логики не означает, что каждое приложение нужно строить с нуля.
Общими могут быть:
- безопасное хранение попыток;
- авторизация и восстановление состояния;
- проверка подписки;
- загрузка медиа;
- история результатов;
- обработка повторных запросов;
- аналитика технических ошибок;
- базовые компоненты интерфейса.
Это платформенный слой. Он отвечает за надёжность и одинаково понятное поведение приложений.
Над ним располагается экзаменационный слой: структура секций, типы заданий, таймеры, правила переходов и расчёта результата. А ещё выше — проверенный контент, который относится только к конкретному экзамену и конкретной версии его формата.
Такое разделение даёт полезный компромисс: команда не дублирует инфраструктуру, но и не заставляет разные экзамены жить по одному искусственному сценарию.
Небольшой проверочный список
Перед добавлением нового экзамена в существующую платформу полезно ответить на несколько вопросов:
1. Есть ли отдельное описание актуального официального формата?
2. Зафиксированы ли порядок секций, таймеры и правила навигации?
3. Сгруппированы ли вопросы с общим текстом или записью в цельные блоки?
4. Проверяется ли формат автоматическими тестами?
5. Отделена ли экзаменационная логика от общих экранов и сервисов?
6. Сохраняется ли попытка при сворачивании и повторном открытии приложения?
7. Понятно ли пользователю, какие данные использовались для обратной связи?
8. Можно ли обновить один экзамен, не меняя поведение остальных?
Универсальный интерфейс может быть удобным. Универсальные правила экзамена — почти всегда риск. Хорошая платформа переиспользует инфраструктуру, но оставляет каждому экзамену собственную проверяемую логику. Именно эта граница помогает масштабировать продукт без незаметной потери точности.
 Share