

The post has been translated automatically. Original language: Russian




When there are multiple processors and shared fast memory in one chip, the most obvious scheme seems simple: give each processor direct access to the entire memory. Logically, this is convenient because any processor can access any bank and the software almost does not have to think about the physical location of the data.
On FPGAs, such a scheme quickly collides with another reality. The more processors and memory banks are connected to each other, the more wires, switches and long routes inside the crystal become, rather than calculations. In Memora8, it was the physical implementation of memory that led us first to a cube, and then to a cube with additional diagonal connections.
Why not connect everything with everything
We tested a variant in which four processors had direct access to all ten memory banks. This scheme really worked on the Artix-7 with a frequency of 125 MHz, and the processor read memory in one clock cycle.
But with the transition to eight processors, the picture has changed dramatically. The experiment with eight processors and sixteen globally accessible banks no longer fit into the required time: long paths from choosing a bank to entering block memory became critical.
The reason is quite obvious. If each processor must see each bank, the number of possible paths increases with both the number of processors and the number of banks.:
processors × banksWith eight processors and dozens of banks, we already have a large switching network. In the logical scheme, these are several blocks, and after being placed on a chip, there are many physical connections that have to cross a significant part of the FPGA.
Therefore, we decided to limit the direct access distance rather than the amount of memory.
Eight processors as the vertices of a cube
The cube has eight vertices. This naturally coincided with the size of the Memora8 cluster — eight processors.
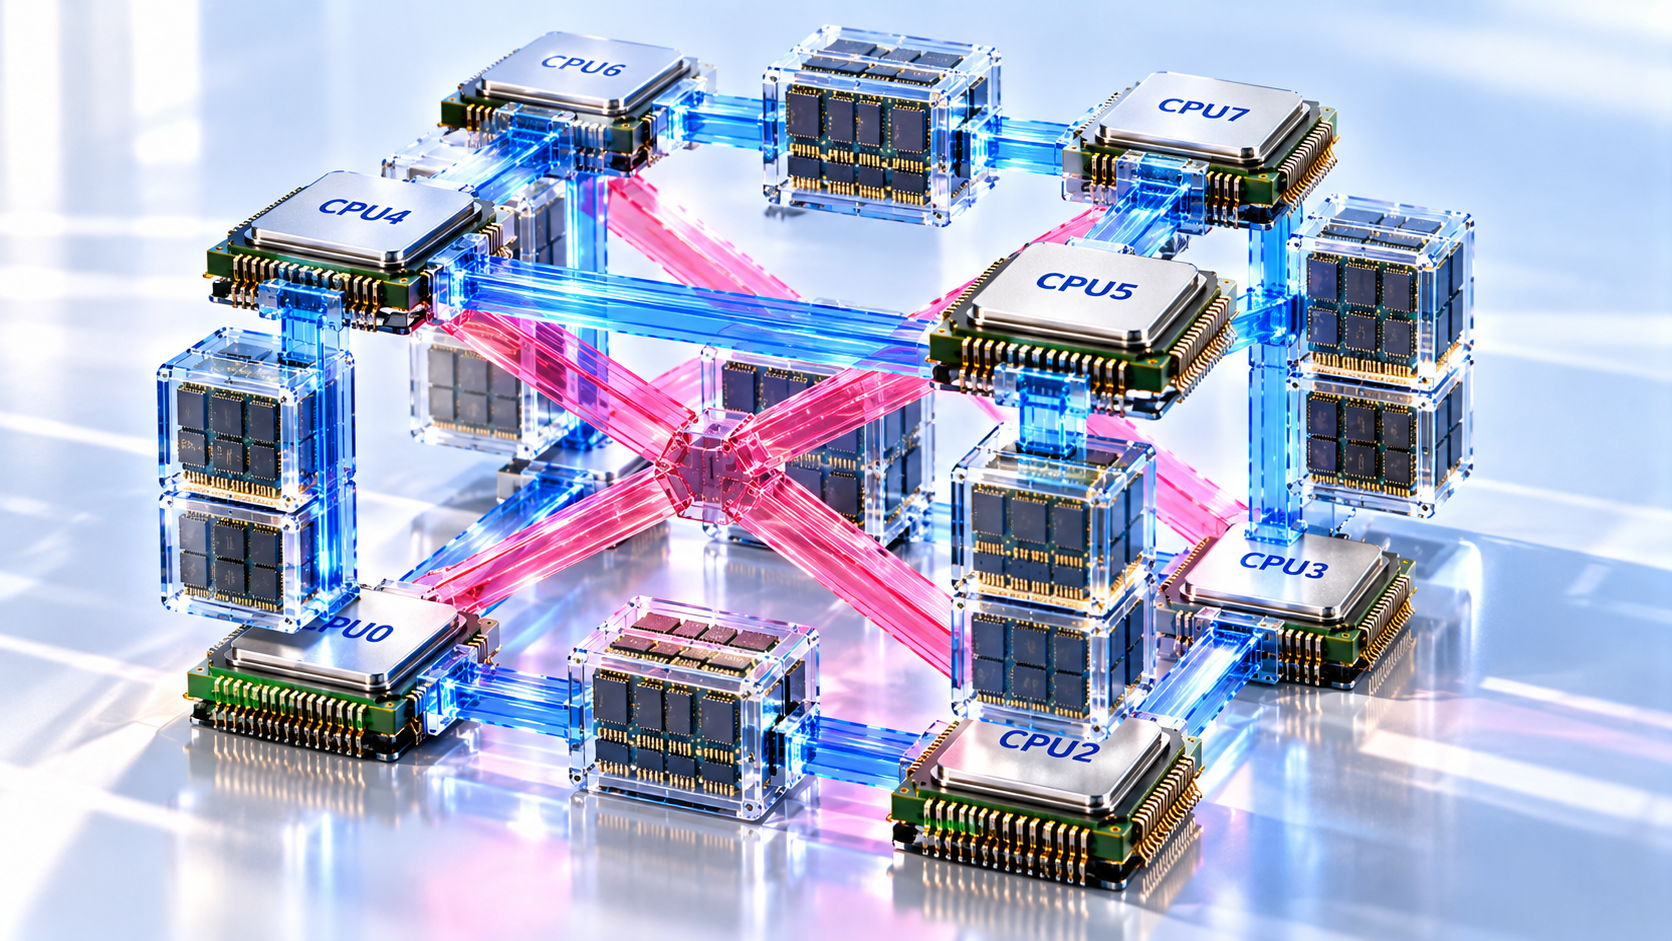
If you put one processor in each vertex, each of them gets three immediate neighbors.:
        CPU0──────CPU1
       / │       / │
    CPU3──────CPU2 │
      │  │      │  │
      │ CPU7────│─CPU6
      │ /       │ /
CPU4──────CPU5Each processor no longer has seven other processors, but only three immediate communication directions. This drastically limits the number of connections that must converge at a single point.
The memory can be placed directly on the edges of such a cube. The bank between the two vertices is accessible to both processors, so it simultaneously serves as both memory and a fast data transfer channel between neighbors.
What did the first cube give
In the experimental version of Memora8, two common banks were placed on each of the twelve edges of the cube. Additionally, each processor had its own bank.
It worked:
12 edges × 2 banks = 24 total banks
8 processors × 1 = 8 proprietary banks

total = 32 banksWith four pages of 8 KiB in each bank, this gave 1 MiB of internal SRAM.
At the same time, a particular processor saw only seven banks directly: six on three adjacent edges and one of its own. It turned out to be 224 KiB of memory with direct access instead of trying to give each processor the entire 1 MiB.
The main result turned out to be more important than the volume itself. The complete eight-processor cube was carried out through the placement and tracing of Artix-7 at 125 MHz with a processor reading in one clock cycle.
But a regular cube has a limitation.
The top of the cube has only three neighbors. This means that the immediate memory area of each processor is determined by three communication directions.
With further experiments, the question arose: is it possible to add another direction without returning to the full "everyone with everyone" scheme?
The cube has a natural candidate — the opposite vertex.
For example, if you designate the vertices with three binary coordinates, then the opposite coordinates will be:
000 ↔ 111
001 ↔ 110
010 ↔ 101
011 ↔ 100These pairs are not connected by the usual edges of the cube. Geometrically, the connection runs along its inner diagonal.
If you add such four connections, the degree of each vertex increases from three to four.
The cube plus the diagonals turns into K4,4
Interestingly, the resulting structure is well known in graph theory. The vertices of a cube can be divided into two groups by the parity of their binary number.:
one group:
000 011 101 110

another group:
001 010 100 111In a regular cube, each vertex is already connected to three vertices of the opposite group. The only thing missing is the opposite vertex on the diagonal.
After adding four diagonals, each vertex of the first group is connected to all four vertices of the second group. The result is a complete bipartite graph K4,4.
The name here is not as important as the physical meaning. Instead of seven connections from each processor to all the others, there are four predefined directions.
Why are four connections better than three
The additional diagonal increases local memory availability, but does not turn the network back into a full switchboard.
Now each processor participates in four common connections:
3 cube edges
+
1 diagonal
=
4 directionsFor eight processors, sixteen connections are obtained. In the current experimental version, each such connection corresponds to one physical memory bank.
It turns out to be a very symmetrical structure.:
16 common banks
, 8 pages per bank
8 KiB per page

16 × 8 × 8 KiB = 1 MiBThat is, the same megabyte of internal memory can be organized not as 32 smaller banks, but as 16 larger banks, each of which naturally belongs to a pair of processors.
Why is it convenient for the memory itself?
For a bank, it is important not only how many bits are in it, but also how many processors simultaneously require access to it. The more potential request sources there are, the more difficult it is to select an address and route control signals.
In K4,4, a specific common bank connects only two processors. They are known in advance even when building the circuit, so instead of a large global switch, you can create many small local connections.
This is one of the key ideas of the new Memora8 topology.: Instead of choosing one path out of a huge number of possible paths in each cycle, you should limit the physically acceptable paths in advance.
The memory remains shared at the cluster level, but direct access becomes local.
What happens to data that is far away
Limited connectivity does not mean that the processor is permanently tied to only a few banks. In Memora8, the natural unit of movement is an 8 KiB page.
If the desired page is located in another part of the cluster, the operating system can move it to a bank directly accessible by the desired processor. The page movement hardware is designed for this purpose.
Thus, the global nature of memory is transferred to another level.:
Not every LOAD/STORE has to go anywhere.

but

the page is placed
in advance where the processor can work with it directly.This significantly changes the task for the equipment. Instead of a global route that must fit into one clock cycle for each read operation, long-distance page movement can be performed separately and take longer.
After the page is placed, the usual work takes place again via a shortcut.
Why is it especially suitable for Memora8
In Memora8, memory pages have explicit ownership. The processor does not need to support the classical model, in which several cores access a single line of shared cache memory at any moment and hardware-coordinate its state.
Therefore, the page layout can be part of the system management. If the task is going to run on a specific processor, its active pages can be placed in banks directly accessible to it.
In this case, the memory topology and the operating system model begin to work together. The hardware provides a short and predictable path, and the system performs a more infrequent page placement operation.
Checking on a real FPGA
A variant with sixteen common banks and the K4.4 topology was tested on the Artix-7 XC7A200T. The implementation used 1 MiB of SRAM, i.e. 256 blocks of RAMB36.
After placing and tracing, the diagram showed:
23 205 LUT
7 999 FF
256 RAMB36

Frequency 125 MHz
WNS +0.025 ns
WHS +0.075 ns
trace errors 0class="paragraph"> At the same time, direct reading of commands and data by the processor was preserved in one clock cycle. For us, this is a fundamental result: the geometry of memory appeared not only from reasoning on paper, but from a series of physical experiments with a real crystal.
Geometry becomes a part of architecture
A programmer usually represents memory as a sequence of addresses.:
0
1
2
3
...Physically, the memory of a modern computer is designed quite differently. The banks are located in different places of the crystal, and the cost of access is determined not only by the logical address, but also by the distance, the number of switches and the length of the conductors.
With a small number of computing units, this physics can be hidden behind a common connection system. As it scales, it begins to define the architecture.
In Memora8, we decided not to fight this to the last level of switches, but to make the spatial structure explicit.
The cube gave each processor three local directions. The additional diagonal gave a fourth and turned the structure into a symmetrical K4,4. At the same time, we saved 1 MiB of internal memory and read in one clock cycle at 125 MHz.
Therefore, a cube with diagonals for Memora8 is not a geometric beauty in itself. This is a way to replace a huge "everything with everyone" network with a small number of short, pre-known paths and bring the logical architecture of the processor closer to the physical structure of the crystal.
Когда в одном кристалле находятся несколько процессоров и общая быстрая память, самая очевидная схема кажется простой: дать каждому процессору прямой доступ ко всей памяти. Логически это удобно, потому что любой процессор может обратиться к любому банку и программному обеспечению почти не приходится думать о физическом расположении данных.
На ПЛИС такая схема быстро сталкивается с другой реальностью. Чем больше процессоров и банков памяти соединяются друг с другом, тем больше становится не вычислений, а проводников, переключателей и длинных маршрутов внутри кристалла. В Memora8 именно физическая реализация памяти привела нас сначала к кубу, а затем к кубу с дополнительными диагональными связями.
Почему не соединить всё со всем
Мы проверяли вариант, в котором четыре процессора имели прямой доступ ко всем десяти банкам памяти. Такая схема действительно заработала на Artix-7 с частотой 125 МГц, причём чтение памяти процессором сохранялось за один такт.
Но при переходе к восьми процессорам картина резко изменилась. Эксперимент с восемью процессорами и шестнадцатью глобально доступными банками уже не укладывался в требуемое время: критическими становились длинные пути от выбора банка до входа блочной памяти.
Причина достаточно наглядна. Если каждый процессор должен видеть каждый банк, количество возможных путей растёт вместе и с числом процессоров, и с числом банков:
процессоры × банкиПри восьми процессорах и десятках банков получается уже большая сеть переключений. На логической схеме это несколько блоков, а после размещения на кристалле — множество физических соединений, которым приходится пересекать значительную часть ПЛИС.
Поэтому мы решили ограничить не объём памяти, а расстояние прямого доступа.
Восемь процессоров как вершины куба
У куба восемь вершин. Это естественно совпало с размером кластера Memora8 — восемью процессорами.
Если поместить по одному процессору в каждую вершину, каждый из них получает трёх непосредственных соседей:
        CPU0──────CPU1
       / │       / │
    CPU3──────CPU2 │
      │  │      │  │
      │ CPU7────│─CPU6
      │ /       │ /
CPU4──────CPU5У каждого процессора теперь не семь других процессоров, а только три ближайших направления связи. Это резко ограничивает количество соединений, которые должны сходиться в одной точке.
Память можно размещать непосредственно на рёбрах такого куба. Банк между двумя вершинами доступен обоим процессорам, поэтому он одновременно служит и памятью, и быстрым каналом передачи данных между соседями.
Что дал первый куб
В экспериментальном варианте Memora8 на каждом из двенадцати рёбер куба размещалось по два общих банка. Дополнительно каждый процессор имел собственный банк.
Получалось:
12 рёбер × 2 банка = 24 общих банка
8 процессоров × 1  =  8 собственных банков

всего = 32 банкаПри четырёх страницах по 8 КиБ в каждом банке это давало 1 МиБ внутренней SRAM.
При этом конкретный процессор видел непосредственно только семь банков: шесть на трёх прилегающих рёбрах и один собственный. Получалось 224 КиБ памяти с прямым доступом вместо попытки дать каждому процессору весь 1 МиБ.
Главный результат оказался важнее самого объёма. Полный восьмипроцессорный куб удалось провести через размещение и трассировку Artix-7 на 125 МГц с чтением процессором за один такт.
Но у обычного куба есть ограничение
У вершины куба только три соседа. Это означает, что непосредственная область памяти каждого процессора определяется тремя направлениями связи.
При дальнейших экспериментах возник вопрос: можно ли добавить ещё одно направление, не возвращаясь к полной схеме «каждый с каждым»?
У куба есть естественный кандидат — противоположная вершина.
Например, если обозначить вершины тремя двоичными координатами, то противоположными будут:
000 ↔ 111
001 ↔ 110
010 ↔ 101
011 ↔ 100Эти пары не соединены обычными рёбрами куба. Геометрически связь проходит по его внутренней диагонали.
Если добавить такие четыре соединения, степень каждой вершины увеличивается с трёх до четырёх.
Куб плюс диагонали превращается в K4,4
Интересно, что получившаяся структура хорошо известна в теории графов. Вершины куба можно разделить на две группы по чётности их двоичного номера:
одна группа:
000 011 101 110

другая группа:
001 010 100 111В обычном кубе каждая вершина уже соединена с тремя вершинами противоположной группы. Не хватает только одной — той самой противоположной вершины по диагонали.
После добавления четырёх диагоналей каждая вершина первой группы оказывается связана со всеми четырьмя вершинами второй группы. Получается полный двудольный граф K4,4.
Название здесь не столь важно, как физический смысл. Вместо семи связей от каждого процессора ко всем остальным остаются четыре заранее определённых направления.
Почему четыре связи лучше трёх
Дополнительная диагональ увеличивает локальную доступность памяти, но не превращает сеть обратно в полный коммутатор.
Теперь каждый процессор участвует в четырёх общих соединениях:
3 ребра куба
+
1 диагональ
=
4 направленияДля восьми процессоров получается шестнадцать соединений. В текущем экспериментальном варианте каждому такому соединению соответствует один физический банк памяти.
Получается очень симметричная структура:
16 общих банков
8 страниц на банк
8 КиБ на страницу

16 × 8 × 8 КиБ = 1 МиБТо есть тот же мегабайт внутренней памяти можно организовать уже не как 32 меньших банка, а как 16 более крупных банков, каждый из которых естественно принадлежит паре процессоров.
Почему это удобно для самой памяти
Для банка важно не только сколько в нём бит, но и сколько процессоров одновременно требуют к нему доступ. Чем больше потенциальных источников запроса, тем сложнее выбор адреса и маршрутизация управляющих сигналов.
В K4,4 конкретный общий банк связывает только два процессора. Они известны заранее ещё при построении схемы, поэтому вместо большого глобального переключателя можно создавать множество небольших локальных соединений.
Это одна из ключевых идей новой топологии Memora8: не выбирать в каждом такте один путь из огромного количества возможных, а заранее ограничить физически допустимые пути.
Память при этом остаётся общей на уровне кластера, но прямой доступ становится локальным.
Что происходит с данными, которые находятся далеко
Ограниченная связность не означает, что процессор навсегда привязан только к нескольким банкам. В Memora8 естественной единицей перемещения является страница размером 8 КиБ.
Если нужная страница находится в другой части кластера, операционная система может переместить её в банк, непосредственно доступный нужному процессору. Для этого предназначены аппаратные средства перемещения страниц.
Таким образом, глобальность памяти переносится на другой уровень:
не каждый LOAD/STORE должен идти куда угодно

а

страница заранее помещается туда,
где процессор сможет работать с ней напрямуюЭто существенно меняет задачу для аппаратуры. Вместо глобального маршрута, который должен укладываться в один такт для каждой операции чтения, дальнее перемещение страницы может выполняться отдельно и занимать больше времени.
После размещения страницы обычная работа снова происходит по короткому пути.
Почему это особенно подходит Memora8
В Memora8 страницы памяти имеют явное владение. Процессору не требуется поддерживать классическую модель, в которой несколько ядер в произвольный момент обращаются к одной строке общей кэш-памяти и аппаратно согласуют её состояние.
Поэтому расположение страницы может быть частью управления системой. Если задаче предстоит работать на конкретном процессоре, её активные страницы можно размещать в непосредственно доступных ему банках.
Топология памяти и модель операционной системы в таком случае начинают работать совместно. Аппаратура обеспечивает короткий и предсказуемый путь, а система занимается более редкой операцией размещения страниц.
Проверка на реальной ПЛИС
Вариант с шестнадцатью общими банками и топологией K4,4 был проверен на Artix-7 XC7A200T. В реализации использовался 1 МиБ SRAM, то есть 256 блоков RAMB36.
После размещения и трассировки схема показала:
23 205 LUT
7 999 FF
256 RAMB36

частота       125 МГц
WNS           +0,025 нс
WHS           +0,075 нс
ошибки трассировки 0При этом прямое чтение команд и данных процессором сохранилось за один такт. Для нас это принципиальный результат: геометрия памяти появилась не только из рассуждений на бумаге, а из серии физических экспериментов с реальным кристаллом.
Геометрия становится частью архитектуры
Обычно программист представляет память как последовательность адресов:
0
1
2
3
...Физически память современного вычислителя устроена совсем не так. Банки находятся в разных местах кристалла, а стоимость доступа определяется не только логическим адресом, но и расстоянием, количеством переключателей и длиной проводников.
При небольшом числе вычислительных блоков эту физику можно спрятать за общей системой соединений. При масштабировании она начинает определять архитектуру.
В Memora8 мы решили не бороться с этим до последнего уровня переключателей, а сделать пространственную структуру явной.
Куб дал каждому процессору три локальных направления. Дополнительная диагональ дала четвёртое и превратила структуру в симметричный K4,4. При этом мы сохранили 1 МиБ внутренней памяти и чтение за один такт на 125 МГц.
Поэтому куб с диагоналями для Memora8 — не геометрическая красота сама по себе. Это способ заменить огромную сеть «все со всеми» небольшим числом коротких, заранее известных путей и приблизить логическую архитектуру процессора к физической структуре кристалла.

 Share








