
The post has been translated automatically. Original language: Russian



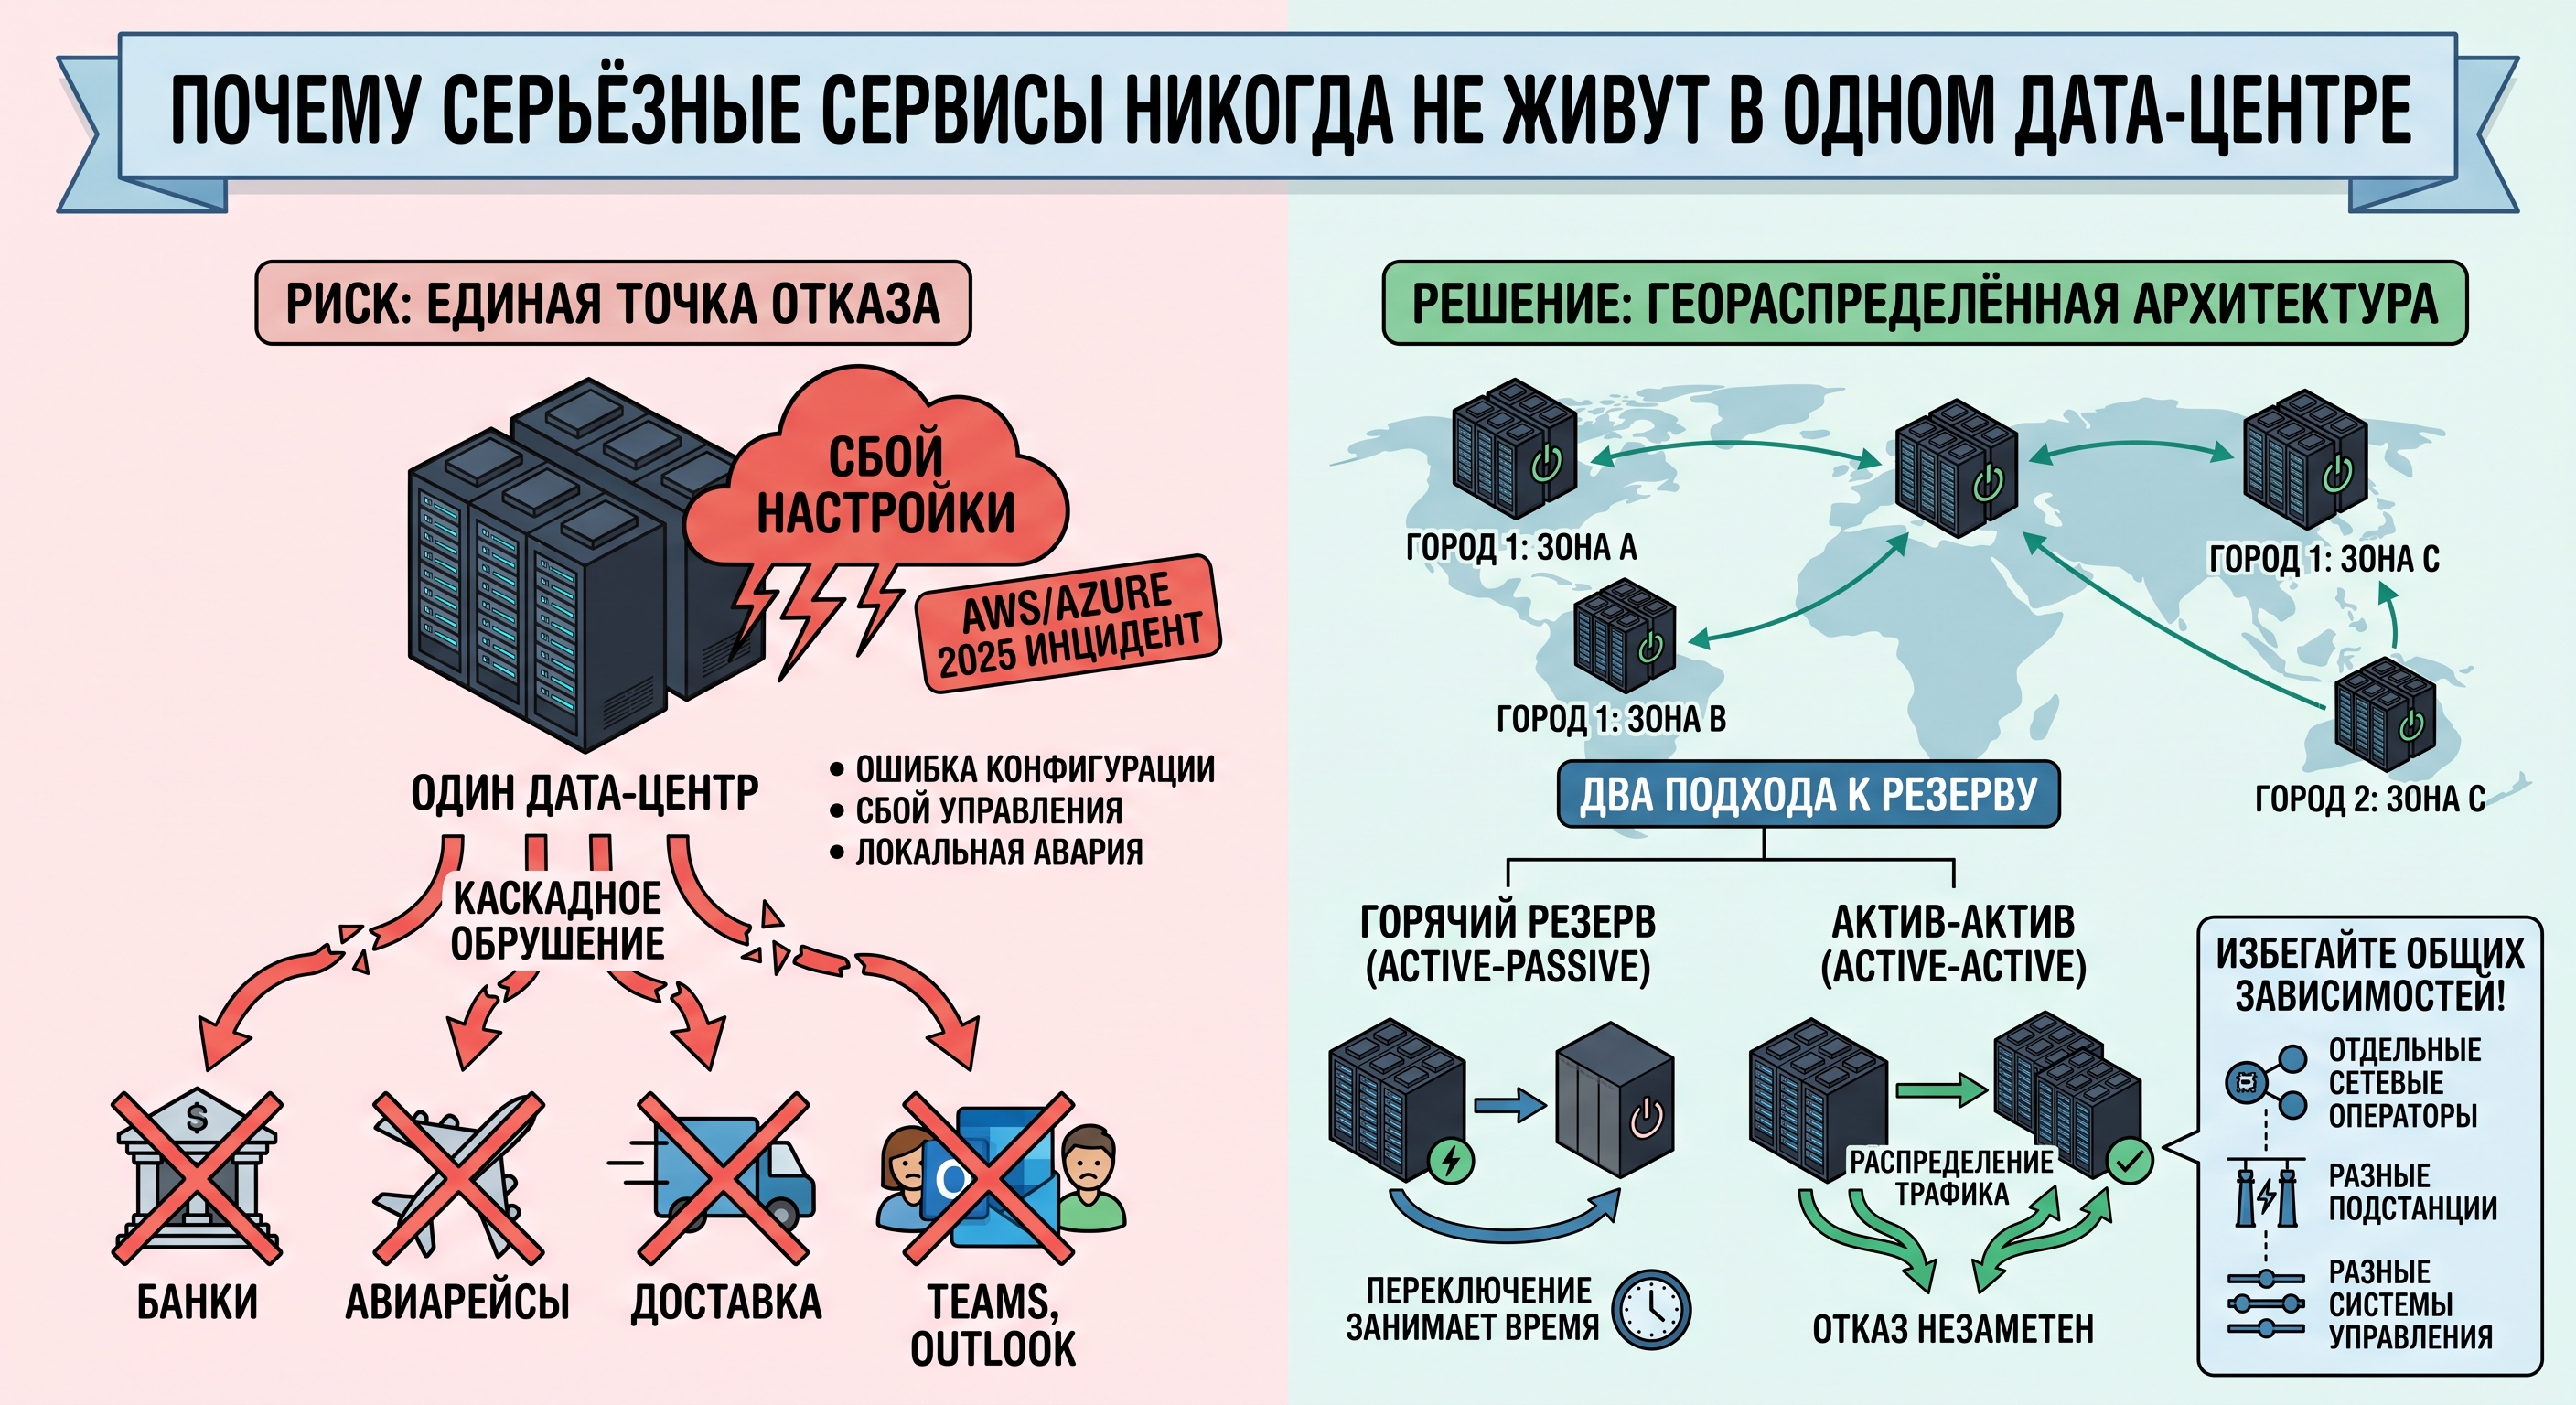
Last fall, the Internet reminded us twice in ten days that the "cloud" is actually an ordinary building with servers. First, on October 20, 2025, one AWS region in Northern Virginia failed, and more than a hundred services around the world began to fail at once: delivery, banking, and flight check—in. Less than nine days later, the same thing happened at Microsoft Azure: Teams, Outlook, Xbox, and check-in desks of entire airlines stopped working. The reason in both cases was not hackers or a fire, but one erroneous setup that cascaded everything else down.
The conclusion from this is simple. A single data center is always a single point of failure, even if it is top—notch equipped with backup power and cooling. No uninterruptible power supply can protect you from a configuration error or a malfunction that covers the entire region. Engineers can build exceptionally reliable facilities, but absolute reliability does not exist, and sooner or later it makes itself felt.
Therefore, serious projects do not rely on one site, but distribute the load across several data centers at once. They start by duplicating the equipment within the same hall, then they distribute it to different buildings in the city — these are called accessibility zones — and at the most responsible level they distribute it to different cities and countries so that no local accident can affect both sites at the same time.
The next question is how to link these platforms. The first approach: the main one is working, and the second one is in hot standby and picks up the load if the first one fails. It's cheaper, but switching takes time, and it needs to be worked out regularly. A reserve that has never been tested under load is not a reserve, but just a hope. The second approach: both sites work simultaneously and share traffic, so that the fall of one passes almost unnoticeably. More reliable, but also noticeably more expensive.
And there is another non-obvious point that is usually reached through experience. A reserve that shares a common relationship with the main site is no longer a reserve. This is exactly what many people faced last fall: the servers were located in different regions, but they relied on the same provider's management system — once it failed, geography did not help. It can be simpler: two platforms from one substation or two channels from one operator. On paper, it's a reserve, but in fact it's a common weak point that pulls both together.
In general, geo—distribution is not about reinsurance and not about the number of sites for the sake of solidity, but about a sound calculation: understand how much an hour of downtime costs, and invest in independence exactly as much as it is justified. True fault tolerance is based on two simple things: the sites should not have a common point of failure, and switching between them should be checked in advance, in a calm environment, and not in the midst of an accident.
The good news is that all this is not so much a matter of budget as of thoughtful architecture. And it is quite possible to build it, if you think about it in advance.
And how has this issue been resolved with you — do you keep the project on one site or are you already looking at a backup one?
Прошлой осенью интернет дважды за десять дней напомнил, что «облако» — это на самом деле обычные здания с серверами. Сначала, 20 октября 2025 года, отказал один регион AWS в Северной Вирджинии — и разом посыпались больше сотни сервисов по всему миру: доставка, банки, регистрация на авиарейсы. Не прошло и девяти дней, как то же самое повторилось у Microsoft Azure: встали Teams, Outlook, Xbox и стойки регистрации целых авиакомпаний. Причиной в обоих случаях стали не хакеры и не пожар, а одна ошибочная настройка, которая каскадом обрушила всё остальное.
Вывод отсюда простой. Один дата-центр — это всегда единая точка отказа, даже если он оснащён по высшему разряду, с резервным питанием и охлаждением. От ошибки в конфигурации или сбоя, накрывшего весь регион, не защитит ни один источник бесперебойного питания. Инженеры умеют строить исключительно надёжные объекты, но абсолютной надёжности не существует, и рано или поздно это даёт о себе знать.
Поэтому серьёзные проекты не полагаются на одну площадку, а распределяют нагрузку сразу по нескольким дата-центрам. Начинают с дублирования оборудования в пределах одного зала, затем разносят его по разным зданиям в городе — это называют зонами доступности, — а на самом ответственном уровне разводят по разным городам и странам, чтобы никакая локальная авария не могла задеть обе площадки одновременно.
Следующий вопрос — как эти площадки связать. Первый подход: основная работает, а вторая находится в горячем резерве и подхватывает нагрузку, если первая вышла из строя. Это дешевле, но переключение занимает время, и его необходимо регулярно отрабатывать. Резерв, который ни разу не проверяли под нагрузкой, — это не резерв, а всего лишь надежда. Второй подход: обе площадки работают одновременно и делят трафик, так что падение одной проходит почти незаметно. Надёжнее, но и заметно дороже.
И есть ещё один неочевидный момент, до которого обычно доходят на опыте. Резерв, у которого с основной площадкой есть общая зависимость, на самом деле уже не резерв. Именно с этим столкнулись многие прошлой осенью: серверы стояли в разных регионах, но опирались на одну и ту же систему управления провайдера — стоило ей отказать, и география не выручила. Бывает и проще: две площадки от одной подстанции или два канала от одного оператора. На бумаге — резерв, а по факту общая слабая точка, которая тянет за собой обе.
В сухом остатке геораспределение — это не про перестраховку и не про количество площадок ради солидности, а про здравый расчёт: понять, во сколько обходится час простоя, и вложиться в независимость ровно настолько, насколько это оправдано. Настоящая отказоустойчивость держится на двух простых вещах: у площадок не должно быть общей точки отказа, а переключение между ними стоит проверить заранее, в спокойной обстановке, а не в разгар аварии.
Хорошая новость в том, что всё это — вопрос не столько бюджета, сколько продуманной архитектуры. И выстроить её вполне по силам, если подумать об этом заранее.
А как этот вопрос решён у вас — держите проект на одной площадке или уже присматриваетесь к резервной?
 Share