



The post has been translated automatically. Original language: Russian




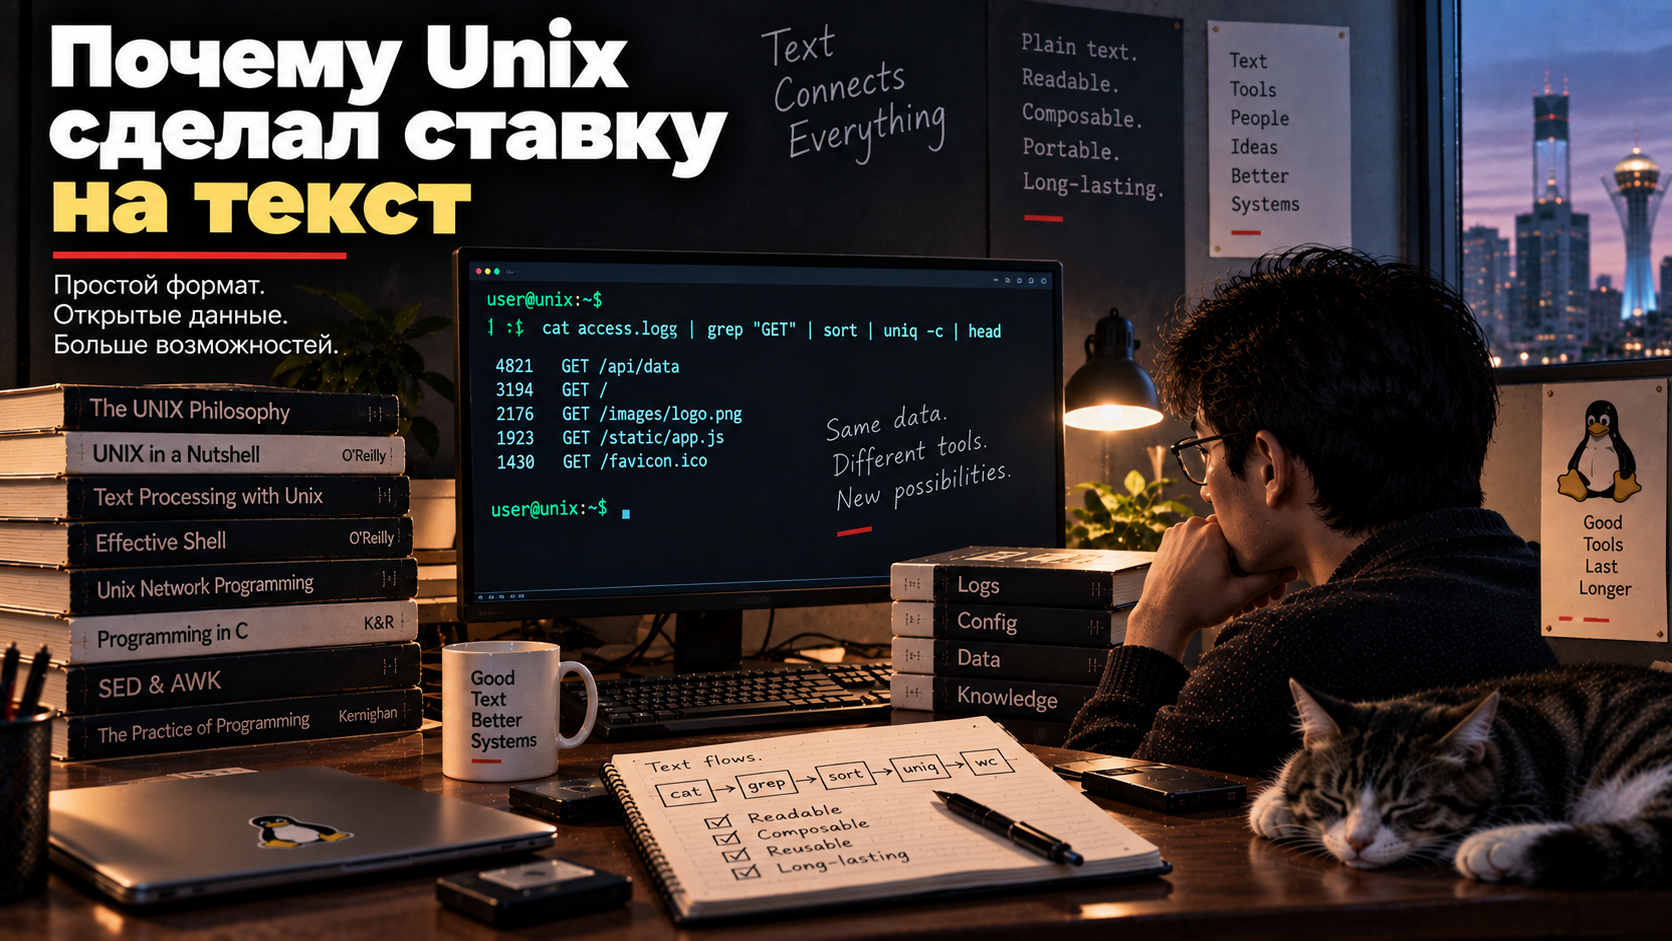
One of the most characteristic features of Unix is its love of plain text. Configuration files, job logs, command results, process lists, program source codes — a lot of things in Unix can be read with your eyes without a special program.
At first glance, it seems natural. But it's a pretty strong architectural decision. It is much more convenient for a computer to store data in a compact binary format, and for a program to work with a structure specially designed for its internal needs.
Unix often chooses a different path: let the data be simple enough for both a human and another program to understand.
The text does not belong to a single program
Let's imagine that the program saves its data in its own private format. As long as she's the only one working, it's convenient. The developer can organize the file in the way that best suits the internal structure of the program.
The problem starts when this data needs to be used somewhere else. Then another program has to know the internal structure of the format or use a special library. If the format changes, all the dependent tools change.
The situation is simpler with plain text. You can open it with an editor, display it on the screen, transfer it to another program, process it with a command, or save it to a new file.
The text does not belong to the application that created it.
A person can look inside
The human-readable format has a simple but very important advantage: you can look into it.
If the program keeps a log in plain text, you don't need a special viewer to understand what happened. If the settings are stored in a text file, they can be read and changed using a standard editor.
This greatly simplifies the study of the system. Instead of a closed internal structure, a surface appears that can be observed.
On Unix, this fits well with the general idea of transparency. The system should allow a person to understand what it is doing.
The text is easy to pass on
But the most important advantage of text is not in human reading, but in connecting programs.
If one program outputs regular strings, the other can filter them. The third is to sort. The fourth is to count. The fifth is to transform.
This does not require a special agreement between each pair of programs. A common data language is enough for them.
In classic Unix, text very often becomes such a language.
This is why software pipelines work so naturally. The result of one command can be immediately used as the input of the next.
The simplicity of the format creates freedom
The more complex the data format, the more knowledge is required from the program that wants to work with it.
Plain text lowers this threshold. Even if the format is not perfect, you can usually explore it manually, find the necessary fields and write a small converter.
This creates an important effect: data becomes more independent of a particular tool.
There is only one program today. It was replaced by another one tomorrow. If the data is in a clear form, the transition is usually easier.
A good format outlives the program that created it.
Why binary formats are needed anyway
This does not mean that everything in the world needs to be stored in text form.
Images, sound, video, large arrays of numbers, and many internal structures are much more reasonable to store in binary formats. Sometimes speed is important, sometimes size, sometimes accuracy of presentation.
The Unix approach is not to ban binary data.
The point is rather different: if the data serves as a boundary between independent parts of the system and can be intelligently presented in a clear format, simplicity is often more useful than maximum efficiency.
Especially if this data has to live for a long time.
The text turned out to be surprisingly durable
Program formats quickly become obsolete. The application may disappear after ten years, the library may no longer be supported, and a specific version of the file may become unreadable.
This happens much less often with plain text.
A text file created decades ago can often be opened with a modern editor without any transformations. Even if the program that created it doesn't exist for a long time, the content remains accessible.
This is one of the reasons why software source codes survive tool changes so well. Languages change, editors change, version control systems change, but the text itself remains.
Configuration as data
This is especially evident in the settings.
There are two approaches. The first is to store the settings inside the program or in a closed database. The second option is to put them in a separate, understandable file.
In the second case, the behavior of the program becomes more explicit. You can see what is configured, compare the two versions, save the changes in the version control system, and transfer the settings to another machine.
The configuration turns into independent data.
This is a very important idea because it separates the behavior of the system from the code.
The text works well with the version control system
When Git and other version control systems appeared, the old Unix solution proved to be particularly successful.
It is convenient to compare the text line by line. You can see exactly what has changed, who made the change, and when. You can combine different versions and store the entire history.
With binary files, this is usually much more difficult.
Therefore, modern developers benefit daily from an idea that appeared long before Git.
The source code, settings, documentation, and infrastructure descriptions often exist as text.
Markdown and JSON continue the same line
Modern formats look different, but the principle remains familiar.
Markdown is plain text that can be read even without a display program. JSON is a structured text suitable for both humans and machines.
Of course, each of these formats has its own limitations. But their success shows that plain text is still a convenient way to connect different systems.
Even in very modern architectures, we constantly come back to the idea that data should be simple enough to be transferred to another tool without complicated dependencies.
Artificial intelligence has made text central again
The advent of large language models has unexpectedly enhanced the value of the text.
A modern artificial intelligence system works perfectly with source code, documentation, logs, configuration, task descriptions, and ordinary human language.
It turns out a curious historical connection. What was chosen in Unix as a simple universal way of interacting between programs and humans has become the main material for interacting with artificial intelligence today.
If the system stores knowledge and settings in clear text form, artificial intelligence can also read, analyze and modify them.
Closed internal formats are much less convenient for this.
The text makes the system observable
There is another important effect. When clear data is transmitted between the parts of the system, it is easier to see exactly what is happening.
You can view the entrance. View the exit. Save the intermediate result. Compare two launches.
This is especially useful when searching for errors.
If an opaque internal state is passed between components, you have to use special debugging tools. If there is a clear data flow between them, a significant part of the system can be explored with conventional tools.
Transparency is again a consequence of simplicity.
It's not the format that matters, but the principle.
It is not necessary to turn Unix's love of text into a dogma.
The main idea is not that each file must consist of strings. The main thing is that the boundaries between the parts of the system are open, understandable and durable.
Sometimes text is best suited for this. Sometimes it's a well—described binary format. Sometimes it's a structured message.
The question should be asked differently: is it possible to make it text-based?
It is more useful to ask: will this data be able to live independently of the program that created it?
Data must survive tools
Programs change much faster than information.
Today we use one editor, tomorrow another. One server is being replaced by another. The library is being rewritten. The operating system is being updated.
Well the designed data should not disappear with these changes.
That's why Unix's love of text has proved so enduring. It wasn't just about the convenience of the command line.
The text gave the system independence.
A person could read it. The programs could process it. The tools could be replaced. The data continued to live.
Perhaps that's why, half a century later, in the era of artificial intelligence, we are once again discovering how powerful a simple idea can be: if information is intended for many tools and should live for a long time, it's good when you can just read it.
Одна из самых характерных особенностей Unix — любовь к обычному тексту. Конфигурационные файлы, журналы работы, результаты команд, списки процессов, исходные тексты программ — очень многое в Unix можно прочитать глазами без специальной программы.
На первый взгляд это кажется естественным. Но это довольно сильное архитектурное решение. Компьютеру гораздо удобнее хранить данные в компактном двоичном виде, а программе — работать со структурой, специально созданной под её внутренние нужды.
Unix часто выбирает другой путь: пусть данные будут достаточно простыми, чтобы их мог понять и человек, и другая программа.
Текст не принадлежит одной программе
Представим, что программа сохраняет свои данные в собственном закрытом формате. Пока работает только она сама, это удобно. Разработчик может организовать файл так, как лучше всего подходит внутреннему устройству программы.
Проблема начинается, когда эти данные нужно использовать где-то ещё. Тогда другой программе приходится знать внутреннее устройство формата или использовать специальную библиотеку. Если формат меняется, меняются и все зависимые инструменты.
С обычным текстом ситуация проще. Его можно открыть редактором, вывести на экран, передать другой программе, обработать командой или сохранить в новый файл.
Текст не принадлежит тому приложению, которое его создало.
Человек может посмотреть внутрь
У человекочитаемого формата есть простое, но очень важное преимущество: в него можно заглянуть.
Если программа ведёт журнал работы обычным текстом, не нужен специальный просмотрщик, чтобы понять, что произошло. Если настройки хранятся в текстовом файле, их можно прочитать и изменить стандартным редактором.
Это сильно упрощает исследование системы. Вместо закрытой внутренней структуры появляется поверхность, которую можно наблюдать.
В Unix это хорошо сочетается с общей идеей прозрачности. Система должна позволять человеку понять, что она делает.
Текст легко передавать дальше
Но самое важное преимущество текста проявляется не в чтении человеком, а в соединении программ.
Если одна программа выдаёт обычные строки, другая может их фильтровать. Третья — сортировать. Четвёртая — считать. Пятая — преобразовывать.
Для этого не нужен специальный договор между каждой парой программ. Им достаточно общего языка данных.
В классическом Unix таким языком очень часто становится текст.
Именно поэтому программные конвейеры работают настолько естественно. Результат одной команды можно сразу использовать как вход следующей.
Простота формата создаёт свободу
Чем сложнее формат данных, тем больше знаний требуется от программы, которая хочет с ним работать.
Простой текст снижает этот порог. Даже если формат не идеален, его обычно можно исследовать вручную, найти нужные поля и написать небольшой преобразователь.
Это создаёт важный эффект: данные становятся более независимыми от конкретного инструмента.
Сегодня программа одна. Завтра её заменили другой. Если данные лежат в понятной форме, переход обычно проще.
Хороший формат переживает программу, которая его создала.
Почему двоичные форматы всё равно нужны
Из этого не следует, что всё на свете нужно хранить в текстовом виде.
Изображения, звук, видео, большие массивы чисел и многие внутренние структуры гораздо разумнее хранить в двоичных форматах. Иногда важна скорость, иногда размер, иногда точность представления.
Unix-подход не состоит в запрете двоичных данных.
Смысл скорее в другом: если данные служат границей между независимыми частями системы и могут быть разумно представлены в понятном формате, простота часто полезнее максимальной эффективности.
Особенно если эти данные должны жить долго.
Текст оказался удивительно долговечным
Форматы программ быстро устаревают. Приложение может исчезнуть через десять лет, библиотека перестать поддерживаться, а конкретная версия файла стать нечитаемой.
С обычным текстом такое происходит гораздо реже.
Текстовый файл, созданный десятилетия назад, часто можно открыть современным редактором без каких-либо преобразований. Даже если программа, которая его создала, давно не существует, содержание остаётся доступным.
Это одна из причин, почему исходные тексты программ так хорошо переживают смену инструментов. Языки меняются, редакторы меняются, системы управления версиями меняются, а сам текст остаётся.
Конфигурация как данные
Особенно хорошо это видно на настройках.
Есть два подхода. Первый — хранить настройки внутри программы или в закрытой базе. Второй — вынести их в отдельный понятный файл.
Во втором случае поведение программы становится более явным. Можно посмотреть, что настроено, сравнить две версии, сохранить изменения в системе управления версиями, передать настройки на другую машину.
Конфигурация превращается в самостоятельные данные.
Это очень важная идея, потому что она отделяет поведение системы от кода.
Текст хорошо работает с системой управления версиями
Когда появился Git и другие системы управления версиями, старое решение Unix оказалось особенно удачным.
Текст удобно сравнивать построчно. Можно увидеть, что именно изменилось, кто внёс изменение и когда. Можно объединять разные версии и хранить всю историю.
С двоичными файлами это обычно намного сложнее.
Поэтому современные разработчики ежедневно получают преимущества от идеи, которая появилась задолго до Git.
Исходный код, настройки, документация и описания инфраструктуры часто существуют именно как текст.
Markdown и JSON продолжают ту же линию
Современные форматы выглядят иначе, но принцип остаётся знакомым.
Markdown — обычный текст, который можно читать даже без программы отображения. JSON — структурированный текст, пригодный и для человека, и для машины.
Конечно, у каждого из этих форматов есть свои ограничения. Но их успех показывает, что простой текст по-прежнему остаётся удобным способом соединять разные системы.
Даже в очень современных архитектурах мы постоянно возвращаемся к идее: данные должны быть достаточно простыми, чтобы их можно было передать другому инструменту без сложной зависимости.
Искусственный интеллект снова сделал текст центральным
Появление больших языковых моделей неожиданно усилило ценность текста.
Современная система искусственного интеллекта прекрасно работает с исходным кодом, документацией, журналами, конфигурацией, описаниями задач и обычным человеческим языком.
Получается любопытная историческая связь. То, что в Unix было выбрано как простой универсальный способ взаимодействия между программами и человеком, сегодня стало основным материалом для взаимодействия с искусственным интеллектом.
Если система хранит знания и настройки в понятном текстовом виде, искусственный интеллект тоже может их читать, анализировать и изменять.
Закрытые внутренние форматы для этого намного менее удобны.
Текст делает систему наблюдаемой
Есть ещё один важный эффект. Когда между частями системы передаются понятные данные, проще увидеть, что именно происходит.
Можно посмотреть вход. Посмотреть выход. Сохранить промежуточный результат. Сравнить два запуска.
Это особенно полезно при поиске ошибок.
Если между компонентами передаётся непрозрачное внутреннее состояние, приходится использовать специальные средства отладки. Если же между ними проходит понятный поток данных, значительную часть системы можно исследовать обычными инструментами.
Прозрачность снова оказывается следствием простоты.
Не формат важен, а принцип
Не стоит превращать любовь Unix к тексту в догму.
Главная идея не в том, что каждый файл обязан состоять из строк. Главное — чтобы границы между частями системы были открытыми, понятными и долговечными.
Иногда для этого лучше всего подходит текст. Иногда — хорошо описанный двоичный формат. Иногда — структурированное сообщение.
Вопрос стоит задавать не так: можно ли сделать это текстовым?
Полезнее спросить: смогут ли эти данные жить независимо от программы, которая их создала?
Данные должны переживать инструменты
Программы меняются намного быстрее, чем информация.
Сегодня мы используем один редактор, завтра другой. Один сервер заменяется другим. Библиотека переписывается. Операционная система обновляется.
Хорошо спроектированные данные не должны исчезать вместе с этими изменениями.
Именно поэтому любовь Unix к тексту оказалась настолько долговечной. Речь была не просто об удобстве командной строки.
Текст давал системе независимость.
Человек мог его читать. Программы могли его обрабатывать. Инструменты можно было заменять. Данные продолжали жить.
Возможно, поэтому спустя полвека, уже в эпоху искусственного интеллекта, мы снова обнаруживаем, насколько сильной может быть простая идея: если информация предназначена для многих инструментов и должна жить долго, хорошо, когда её можно просто прочитать.

 Share








