

The post has been translated automatically. Original language: Russian




Artificial intelligence already knows how to write programs, correct errors, create tests, propose application architectures, and generate descriptions of digital circuits. As such systems develop, the cost of creating software code decreases, and the speed of development increases.
But with this comes a new question.: if code is increasingly being created automatically, how will we make sure that it really does what it's supposed to?
The ability to quickly receive a thousand lines of program does not mean the ability to trust these lines. On the contrary, the faster new implementations are created, the more important it becomes to have an independent way of verifying their properties.
It becomes easier to write code, but it's not necessary to check it.
Traditionally, creating a program has been an expensive part of development. The man designed the algorithm, wrote the code, corrected errors, and gradually brought the system to a working state.
AI is noticeably changing this ratio. Now the developer can describe the task in words and get a ready implementation in a short time.
Conventionally, the process used to look like this:
requirement
↓
long development
↓
program
↓
testingNow more and more often it turns out differently:
Requirement
↓
AND
↓
multiple program options
↓
?It is the question mark that becomes the main thing.
If creating a new variant is very cheap, the main cost is gradually shifted from code production to determining which variant can be trusted.
Tests can also be generated.
It can be argued that AI is capable of writing not only a program, but also tests for it.
It's really useful. Automatic test generation allows you to cover common and edge cases faster, find bugs, and improve the quality of development.
But there is a fundamental problem: the program and the tests can be created by the same system and share the same erroneous assumptions.
If the AI misunderstood the requirement, it can write the wrong program and at the same time prepare tests that confirm this particular misunderstanding.
A closed circuit is obtained:
The AI understands the task in a certain way
↓
creates a program
↓
creates tests
↓
tests confirm the programAll tests can be successful, even though the original requirement was misunderstood.
It is not the author who needs to be checked, but the properties of the result.
When a program is written by a person, trust is often partially related to the developer: his experience, qualifications, the review process, and the history of the project.
With automatically generated code, this model becomes weaker. The same AI is capable of offering dozens of different implementations in a short time, and the origin of the code itself says little about its correctness.
Therefore, the issue is gradually changing.
Instead of:
who wrote this program?It becomes more important:
what properties of this program can be checked?For example:
can it go beyond the boundaries of memory?

can one module access
the data of another?

can the system go
into a forbidden state?

can the management team
be executed without the necessary permissions?The answers to such questions should depend not on the author's confidence, but on the implementation itself.
The formal specification separates the intent from the implementation
To test a program, regardless of who wrote it, it is necessary to describe the expected behavior separately.
For example, to control the equipment, you can define:
If an accident is detected,
the engine must be stopped.

If the system is
in an emergency state,
startup is prohibited.After that, the AI can create an implementation at least multiple times.
Each new version is checked against the same specification.:
formal specification

,── realization of a person

,── AI option #1

,── AI option #2

,── AI option #3This separates the criterion of correctness from the method of obtaining the program.
This is especially important in the future, where the code may be constantly being rebuilt, optimized, or even created for a specific task immediately before execution.
AI is well suited not only for generating
There is another interesting side.
AI can be used not only to write programs, but also to help formulate properties, analyze counterexamples, and explain verification results.
A person can formulate a requirement:
This function should never
increase the speed above the allowed limit.AI can help translate it into a more precise specification, suggest missing limitations, and explain the found violation.
But the final verification of a property does not necessarily have to be based on trust in the AI itself.
You can split the roles:
AI
↓
offers an implementation
and a formal specification

formal verification mechanism
↓
mathematically verifies complianceThat is, AI helps to create, and the evidence system acts as an independent control.
This is especially important for industrial software.
An error in a user application often leads to inconvenience, malfunction, or data loss.
An error in the control system of industrial equipment can have a completely different scale of consequences.
If the program manages:
- energy equipment;
- production line;
- movement of the mechanism;
- resource allocation;
- protection system;
- transport infrastructure,
the "we've run a lot of tests and everything seems to be working" approach may not be sufficient.
Especially if the program was created or significantly modified automatically.
The closer the AI gets to the physical world, the more important it becomes to be able to prove at least the basic limitations of its result.
One proven module still does not solve the problem
Even if the program is formally verified, it does not run on its own.
There is a whole chain between the source text and the physical action:
program
↓
compiler
↓
machine code
, operating system

↓
processor
↓
deviceAn error at any level can violate the original property.
Therefore, in the age of AI, the idea of a testable computing stack is becoming particularly interesting. If programs start to be created much faster, it makes sense to build the lower levels of the system so that their behavior is easier to analyze and prove.
This is exactly the question we are exploring in conjunction with Sekura JS, SJV, Reganta OS and Memora8.
Why do we need a small processor here?
A modern processor is extremely complex. It contains a large number of internal states, acceleration, caching, prediction, and parallel execution mechanisms.
This complexity is justified for a wide range of tasks, but it increases the volume of the system, which must be understood with strict verification.
Memora8 explores another compromise.
The instruction set is relatively small, architectural transitions are made explicit, memory is organized into pages with explicit ownership rules, and interaction with devices is separated from normal memory access.
The goal here is not to keep the PROCESSOR minimal for the sake of minimalism.
The goal is to get a computing system whose state can be described quite fully.
Visibility may become a new feature of architecture
Previously, processor architecture was usually evaluated primarily by performance, power consumption, chip area, and compatibility.
In the age of AI, there may be another important criterion.:
to what extent is the computing system available for automatic analysis?
Is it possible to determine:
- the status of each processor;
- who owns the memory page;
- which memory areas are available;
- which team changed the state?;
- why did the exception occur?;
- which module initiated the system action?
If these answers can be obtained from a sufficiently compact model, AI will not only be able to write programs for the system, but also help analyze their behavior.
Memora8 explores the hypothesis that such visibility may be an independent advantage of architecture.
AI doesn't have to give itself a guarantee.
It is important to draw a line here.
If the AI generated the program and then wrote the conclusion itself:
the code looks correctthis is not a formal guarantee.
Even a very strong model can make a mistake, miss a rare condition, or make an incorrect logical conclusion.
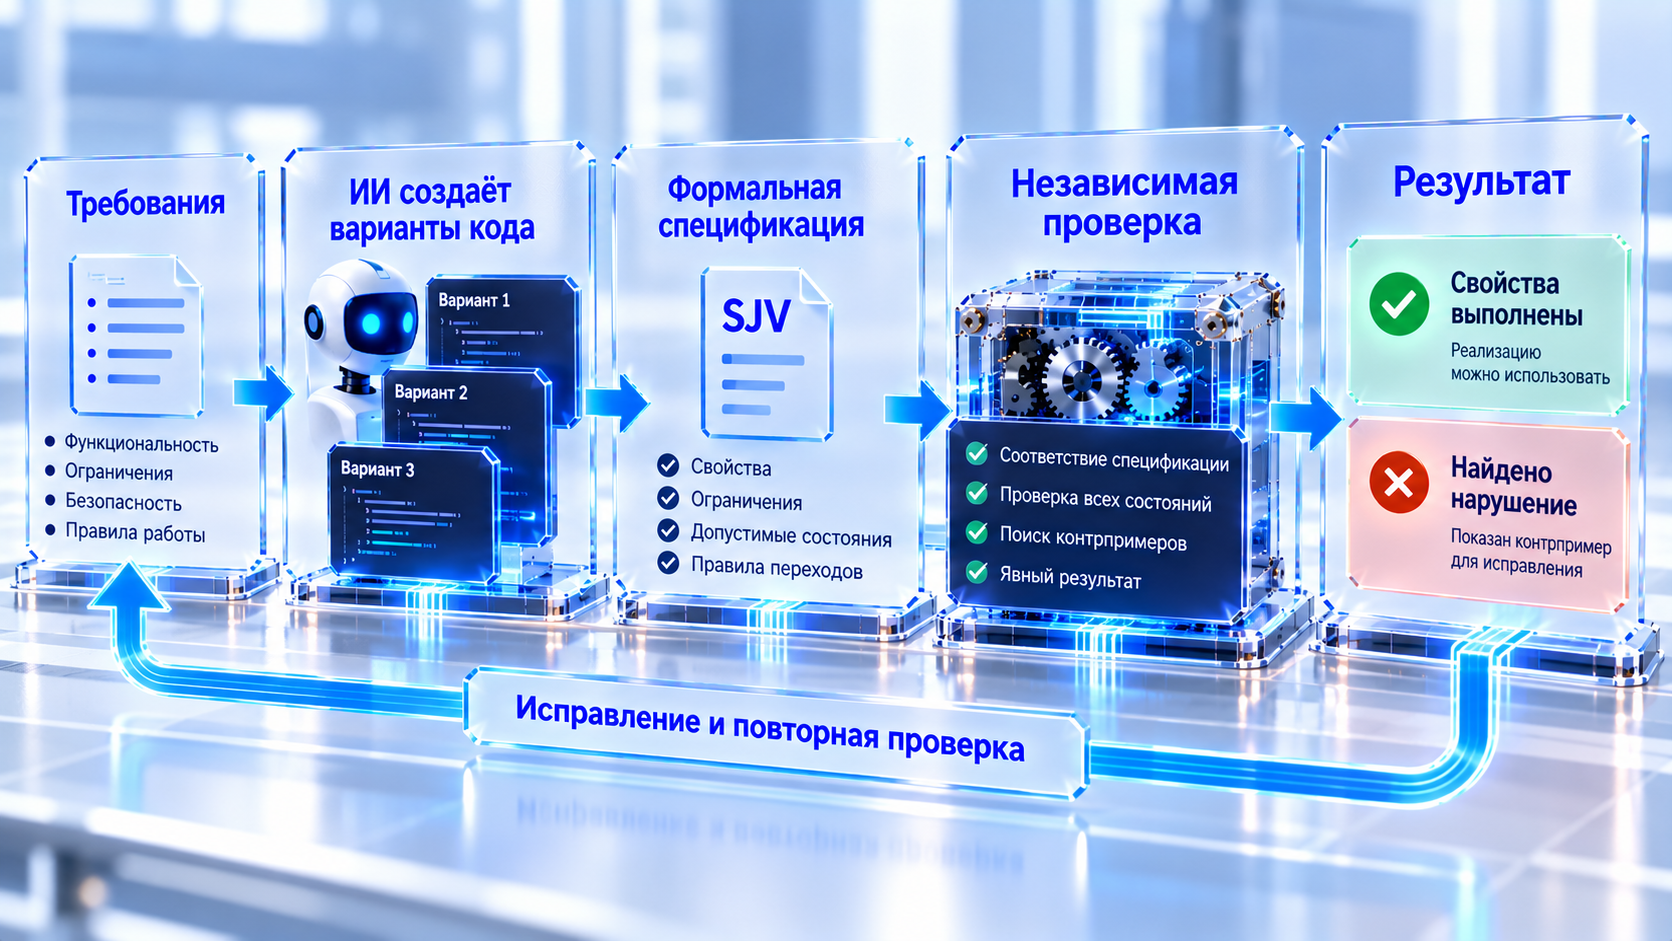
Therefore, the promising scheme looks different.:
the person sets the requirements
↓
AI helps to create a system
↓
formal specification
↓
independent verification
↓
proof or counterexampleAI can participate in almost all stages, but the final statement about the properties of the system should be based on reproducible verification.
A counterexample is especially valuable.
Formal verification is useful not only when everything is fine.
If the proof fails, the system can find a specific case of violation.
For example:
Initial state:
A

Entrance:
B

after execution:
C

property violated:
DFor a human, such a counterexample is already useful in itself.
For AI, it is even more valuable. After receiving an accurate description of the error, the model can change the program and propose the following implementation.
A cycle occurs:
AI creates a program
↓
formal verification
↓
counterexample
↓
AI fixes the program
↓
re - checkUnlike regular code generation, this loop has an external stopping criterion: the implementation must satisfy the specified properties.
The generation rate then stops being a problem.
If independent verification is built into the process, the AI's ability to quickly create multiple options turns from a risk to an advantage.
Let the system generate one hundred possible solutions.
You don't have to trust the one that looks the most convincing. You can automatically discard implementations that violate mandatory properties, and compare the remaining ones based on performance, size, or other characteristics.
That is:
there are many options
↓
formal constraints
↓
only acceptable implementations
↓
choosing the best one based on other criteriaThis is very different from today's model, where a person often evaluates the generated code visually.
Formal verification also has limits
At the same time, formal verification should not be turned into a new magical guarantee.
Any proof relates to a specific model and specific properties.
If an important requirement is not included in the specification, the verification system will not prove it.
If the hardware model is incorrect, the mathematically perfect proof will relate to the incorrect model.
If a part of the system is outside the circuit being checked, it still has to be trusted.
Therefore, the result should not sound like this:
The system is provenand something like this:
for this realization
, under these conditions
, these properties are provedIn the age of AI, such precision of wording only becomes more important.
Verifiability should be considered in the design process.
You can try to take any existing huge system and formally verify it after the fact.
Most of the time, this is an extremely difficult task.
Another approach is to initially design the system with future validation in mind.:
a small number of states

explicit transitions

Simple memory rules

limited set of hardware mechanisms

the exact semantics of the commands

separation of ordinary and privileged actionsThen formal verification becomes a property of the architecture rather than an external add-on.
That is why the work on verifiability affects both the Memora8 instruction set, memory, Reganta OS, and the Sekura JS language.
Perhaps this is one of the major shifts of the AI era.
Before the advent of generative AI, writing an implementation accounted for a significant portion of the cost of software.
Now this cost is gradually decreasing.
But the need to understand the requirements, control behavior and be responsible for the result does not disappear anywhere.
Therefore, the value may shift.:
earlier:
It's expensive to write a program

In the future:
it's cheap to create a program
, it's expensive to prove that you can trust itIf this shift does occur, formal verification will cease to be solely a tool for a small area of particularly critical systems.
It can become one of the main ways to control automatically generated software.
Don't trust AI, but check the result
For us, this is the main meaning of formal verification in the era of artificial intelligence.
The goal is not to prove that AI is never wrong. Such an assumption would be dangerous.
A more practical approach is to allow AI to quickly create solutions, but to build a computing environment so that important properties of the result can be verified independently of its author.
A human, another AI, or a program generator can suggest an implementation. A formal system should answer a more rigorous question: does this particular implementation meet the specified constraints?
That is why we consider verifiability as one of the key properties of the future computing stack.
In the age of AI, we may need not a computer that executes automatically written code the fastest, but a computer for which we are able to accurately determine and verify what this code has the right to do.
Искусственный интеллект уже умеет писать программы, исправлять ошибки, создавать тесты, предлагать архитектуру приложений и генерировать описания цифровых схем. По мере развития таких систем стоимость создания программного кода снижается, а скорость разработки растёт.
Но вместе с этим появляется новый вопрос: если код всё чаще создаётся автоматически, каким образом мы будем убеждаться, что он действительно делает то, что должен?
Способность быстро получить тысячу строк программы ещё не означает способность доверять этим строкам. Наоборот, чем быстрее создаются новые реализации, тем важнее становится независимый способ проверки их свойств.
Написать код становится проще, проверить — не обязательно
Традиционно создание программы было дорогой частью разработки. Человек проектировал алгоритм, писал код, исправлял ошибки и постепенно доводил систему до рабочего состояния.
ИИ заметно меняет это соотношение. Теперь разработчик может описать задачу словами и за короткое время получить готовую реализацию.
Условно раньше процесс выглядел так:
требование
↓
долгая разработка
↓
программа
↓
тестированиеТеперь всё чаще получается иначе:
требование
↓
ИИ
↓
несколько вариантов программы
↓
?Именно знак вопроса становится главным.
Если создание нового варианта стоит очень дёшево, основная стоимость постепенно переносится с производства кода на определение того, какому варианту можно доверять.
Тесты тоже можно генерировать
Можно возразить, что ИИ способен написать не только программу, но и тесты для неё.
Это действительно полезно. Автоматическая генерация тестов позволяет быстрее покрывать обычные и граничные случаи, находить ошибки и улучшать качество разработки.
Но существует фундаментальная проблема: программа и тесты могут быть созданы одной и той же системой и разделять одни и те же ошибочные предположения.
Если ИИ неверно понял требование, он может написать неправильную программу и одновременно подготовить тесты, которые подтверждают именно это неправильное понимание.
Получается замкнутая схема:
ИИ понимает задачу определённым образом
↓
создаёт программу
↓
создаёт тесты
↓
тесты подтверждают программуВсе тесты могут пройти успешно, хотя исходное требование было понято неверно.
Проверять нужно не автора, а свойства результата
Когда программу пишет человек, доверие часто частично связано с разработчиком: его опытом, квалификацией, процессом проверки и историей проекта.
С автоматически созданным кодом такая модель становится слабее. Один и тот же ИИ способен за короткое время предложить десятки разных реализаций, и происхождение кода само по себе мало говорит о его корректности.
Поэтому вопрос постепенно меняется.
Вместо:
кто написал эту программу?становится важнее:
какие свойства этой программы можно проверить?Например:
может ли она выйти за границы памяти?

может ли один модуль получить доступ
к данным другого?

может ли система перейти
в запрещённое состояние?

может ли команда управления
быть выполнена без необходимых прав?Ответы на такие вопросы должны зависеть не от уверенности автора, а от самой реализации.
Формальная спецификация отделяет намерение от реализации
Чтобы проверить программу независимо от того, кто её написал, необходимо отдельно описать ожидаемое поведение.
Например, для управления оборудованием можно определить:
если обнаружена авария,
двигатель должен быть остановлен

если система находится
в аварийном состоянии,
запуск запрещёнПосле этого ИИ может создавать реализацию хоть многократно.
Каждый новый вариант проверяется относительно одной и той же спецификации:
формальная спецификация
        │
        ├── реализация человека
        │
        ├── вариант ИИ №1
        │
        ├── вариант ИИ №2
        │
└── вариант ИИ №3Так критерий корректности отделяется от способа получения программы.
Это особенно важно в будущем, где код может постоянно перестраиваться, оптимизироваться или даже создаваться под конкретную задачу непосредственно перед выполнением.
ИИ хорошо подходит не только для генерации
Есть ещё одна интересная сторона.
ИИ может использоваться не только для написания программ, но и для помощи в формулировании свойств, анализе контрпримеров и объяснении результатов проверки.
Человек может сформулировать требование:
эта функция никогда не должна
увеличивать скорость выше допустимойИИ способен помочь перевести его в более точную спецификацию, предложить недостающие ограничения и объяснить найденное нарушение.
Но окончательная проверка свойства не обязательно должна основываться на доверии к самому ИИ.
Можно разделить роли:
ИИ
↓
предлагает реализацию
и формальную спецификацию

формальный проверяющий механизм
↓
математически проверяет соответствиеТо есть ИИ помогает создавать, а доказательная система выступает независимым контролем.
Это особенно важно для промышленного программного обеспечения
Ошибка в пользовательском приложении часто приводит к неудобству, сбою или потере данных.
Ошибка в системе управления промышленным оборудованием может иметь совершенно другой масштаб последствий.
Если программа управляет:
- энергетическим оборудованием;
- производственной линией;
- движением механизма;
- распределением ресурсов;
- системой защиты;
- транспортной инфраструктурой,
то подход «мы запустили много тестов и вроде всё работает» может быть недостаточным.
Особенно если программа была создана или существенно изменена автоматически.
Чем ближе ИИ подходит к физическому миру, тем важнее становится возможность доказать хотя бы основные ограничения его результата.
Один проверенный модуль ещё не решает задачу
Даже если программа формально проверена, она выполняется не сама по себе.
Между исходным текстом и физическим действием существует целая цепочка:
программа
↓
компилятор
↓
машинный код
↓
операционная система
↓
процессор
↓
устройствоОшибка на любом уровне может нарушить первоначальное свойство.
Поэтому в эпоху ИИ становится особенно интересна идея проверяемого вычислительного стека. Если программы начинают создаваться значительно быстрее, имеет смысл строить нижние уровни системы так, чтобы их поведение было проще анализировать и доказывать.
Именно этот вопрос мы исследуем в связке Sekura JS, SJV, Reganta OS и Memora8.
Зачем здесь нужен небольшой процессор
Современный процессор чрезвычайно сложен. Он содержит большое количество внутренних состояний, механизмов ускорения, кэширования, предсказания и параллельного выполнения.
Такая сложность оправдана для широкого круга задач, но она увеличивает объём системы, которую необходимо понимать при строгой проверке.
Memora8 исследует другой компромисс.
Набор команд относительно небольшой, переходы архитектурного состояния стараются делать явными, память организована страницами с явными правилами владения, а взаимодействие с устройствами отделено от обычного доступа к памяти.
Цель здесь не в том, чтобы процессор был минимальным ради минимализма.
Цель — получить вычислительную систему, состояние которой можно достаточно полно описать.
Обозримость может стать новым свойством архитектуры
Раньше архитектуру процессора обычно оценивали прежде всего по производительности, энергопотреблению, площади кристалла и совместимости.
В эпоху ИИ может появиться ещё один важный критерий:
насколько вычислительная система обозрима для автоматического анализа?
Можно ли определить:
- состояние каждого процессора;
- кому принадлежит страница памяти;
- какие области памяти доступны;
- какая команда изменила состояние;
- почему возникло исключение;
- какой модуль инициировал системное действие?
Если эти ответы можно получить из достаточно компактной модели, ИИ сможет не только писать программы для системы, но и помогать анализировать их поведение.
Memora8 исследует гипотезу, что такая обозримость может быть самостоятельным преимуществом архитектуры.
ИИ не должен сам себе выдавать гарантию
Здесь важно провести границу.
Если ИИ сгенерировал программу, а потом сам написал заключение:
код выглядит правильнымэто не формальная гарантия.
Даже очень сильная модель может ошибиться, пропустить редкое состояние или сделать неверный логический вывод.
Поэтому перспективная схема выглядит иначе:
человек задаёт требования
↓
ИИ помогает создавать систему
↓
формальная спецификация
↓
независимая проверка
↓
доказательство или контрпримерИИ может участвовать почти во всех этапах, но итоговое утверждение о свойствах системы должно опираться на воспроизводимую проверку.
Особенно ценен контрпример
Формальная проверка полезна не только тогда, когда всё хорошо.
Если доказательство не проходит, система может найти конкретный случай нарушения.
Например:
начальное состояние:
A

вход:
B

после выполнения:
C

нарушено свойство:
DДля человека такой контрпример уже сам по себе полезен.
Для ИИ он ещё ценнее. Получив точное описание ошибки, модель может изменить программу и предложить следующую реализацию.
Возникает цикл:
ИИ создаёт программу
↓
формальная проверка
↓
контрпример
↓
ИИ исправляет программу
↓
повторная проверкаВ отличие от обычной генерации кода этот цикл имеет внешний критерий остановки: реализация должна удовлетворить заданным свойствам.
Скорость генерации тогда перестаёт быть проблемой
Если независимая проверка встроена в процесс, способность ИИ быстро создавать множество вариантов превращается из риска в преимущество.
Пусть система сгенерировала сто вариантов решения.
Не обязательно доверять тому, который выглядит наиболее убедительно. Можно автоматически отбросить реализации, нарушающие обязательные свойства, а оставшиеся сравнивать уже по производительности, размеру или другим характеристикам.
То есть:
много вариантов
↓
формальные ограничения
↓
только допустимые реализации
↓
выбор лучшей по другим критериямЭто сильно отличается от сегодняшней модели, где человек зачастую оценивает сгенерированный код визуально.
Формальная проверка тоже имеет границы
При этом нельзя превращать формальную верификацию в новую магическую гарантию.
Любое доказательство относится к конкретной модели и конкретным свойствам.
Если важное требование не включено в спецификацию, проверяющая система его не докажет.
Если модель оборудования неверна, математически безупречное доказательство будет относиться к неверной модели.
Если часть системы находится вне проверяемого контура, ей всё равно приходится доверять.
Поэтому итог должен звучать не так:
система доказанаа примерно так:
для этой реализации
при этих предпосылках
доказаны эти свойстваВ эпоху ИИ такая точность формулировки становится только важнее.
Проверяемость должна закладываться при проектировании
Можно попытаться взять любую существующую огромную систему и формально проверить её постфактум.
Чаще всего это чрезвычайно трудная задача.
Другой подход — изначально проектировать систему с учётом будущей проверки:
небольшое число состояний

явные переходы

простые правила памяти

ограниченный набор аппаратных механизмов

точная семантика команд

разделение обычных и привилегированных действийТогда формальная проверка становится свойством архитектуры, а не внешней надстройкой.
Именно поэтому работа над проверяемостью влияет и на набор команд Memora8, и на память, и на Reganta OS, и на язык Sekura JS.
Возможно, это один из главных сдвигов эпохи ИИ
До появления генеративного ИИ значительная часть стоимости программного обеспечения приходилась на написание реализации.
Теперь эта стоимость постепенно снижается.
Но необходимость понимать требования, контролировать поведение и отвечать за результат никуда не исчезает.
Поэтому ценность может смещаться:
раньше:
дорого написать программу

в будущем:
дёшево создать программу
дорого доказать, что ей можно доверятьЕсли этот сдвиг действительно произойдёт, формальная верификация перестанет быть исключительно инструментом для небольшой области особо ответственных систем.
Она может стать одним из основных способов контроля автоматически создаваемого программного обеспечения.
Не доверять ИИ, а проверять результат
Для нас это и есть главный смысл формальной верификации в эпоху искусственного интеллекта.
Задача не состоит в том, чтобы доказать, что ИИ никогда не ошибается. Такое предположение как раз было бы опасным.
Более практичный подход — позволить ИИ быстро создавать решения, но строить вычислительную среду так, чтобы важные свойства результата можно было проверить независимо от его автора.
Человек, другой ИИ или генератор программ могут предложить реализацию. Формальная система должна ответить на более строгий вопрос: соответствует ли эта конкретная реализация заданным ограничениям?
Именно поэтому мы рассматриваем проверяемость как одно из ключевых свойств будущего вычислительного стека.
В эпоху ИИ нам может понадобиться не компьютер, который быстрее всего выполняет автоматически написанный код, а компьютер, для которого мы способны точно определить и проверить, что этот код имеет право делать.

 Share








