



The post has been translated automatically. Original language: Russian




Over the past few days, ChatGPT and I have been discussing the memory architecture for the Memora8 processor quite closely and testing the hypotheses on the FPGA one by one. It was just a normal dialogue with ChatGPT, not working through Codex: I suggested the next options, we discussed what might work in them, what looks too expensive and what makes sense to check next. After each such discussion, another RTL implementation appeared, and the final answer was given by Vivado after synthesis, placement and routing on Artix-7 200T.
After a fairly long series of such iterations, it seems that the memory model has finally taken shape. Moreover, the path to it turned out to be much more interesting than I expected at the beginning.
Why Memora8 at all
The processor name is directly related to the memory. Memoro means "memory" in Esperanto, the ending -a forms an adjective, and the number 8 in Memora8 is not the number of processors or the core number. It means the size of the base memory page is 8 KiB. The processor's short name is Mr8.
The fact that there are currently eight CPUs in one cluster is just a coincidence with the number in the name. The main idea of the Mr8 is different: processors do not work with an abstract single SRAM array, but connect to the memory pages they need. Therefore, the search for a physical memory model turned out to be not an auxiliary task, but one of the central parts of the processor architecture.
The very first idea was quite naive
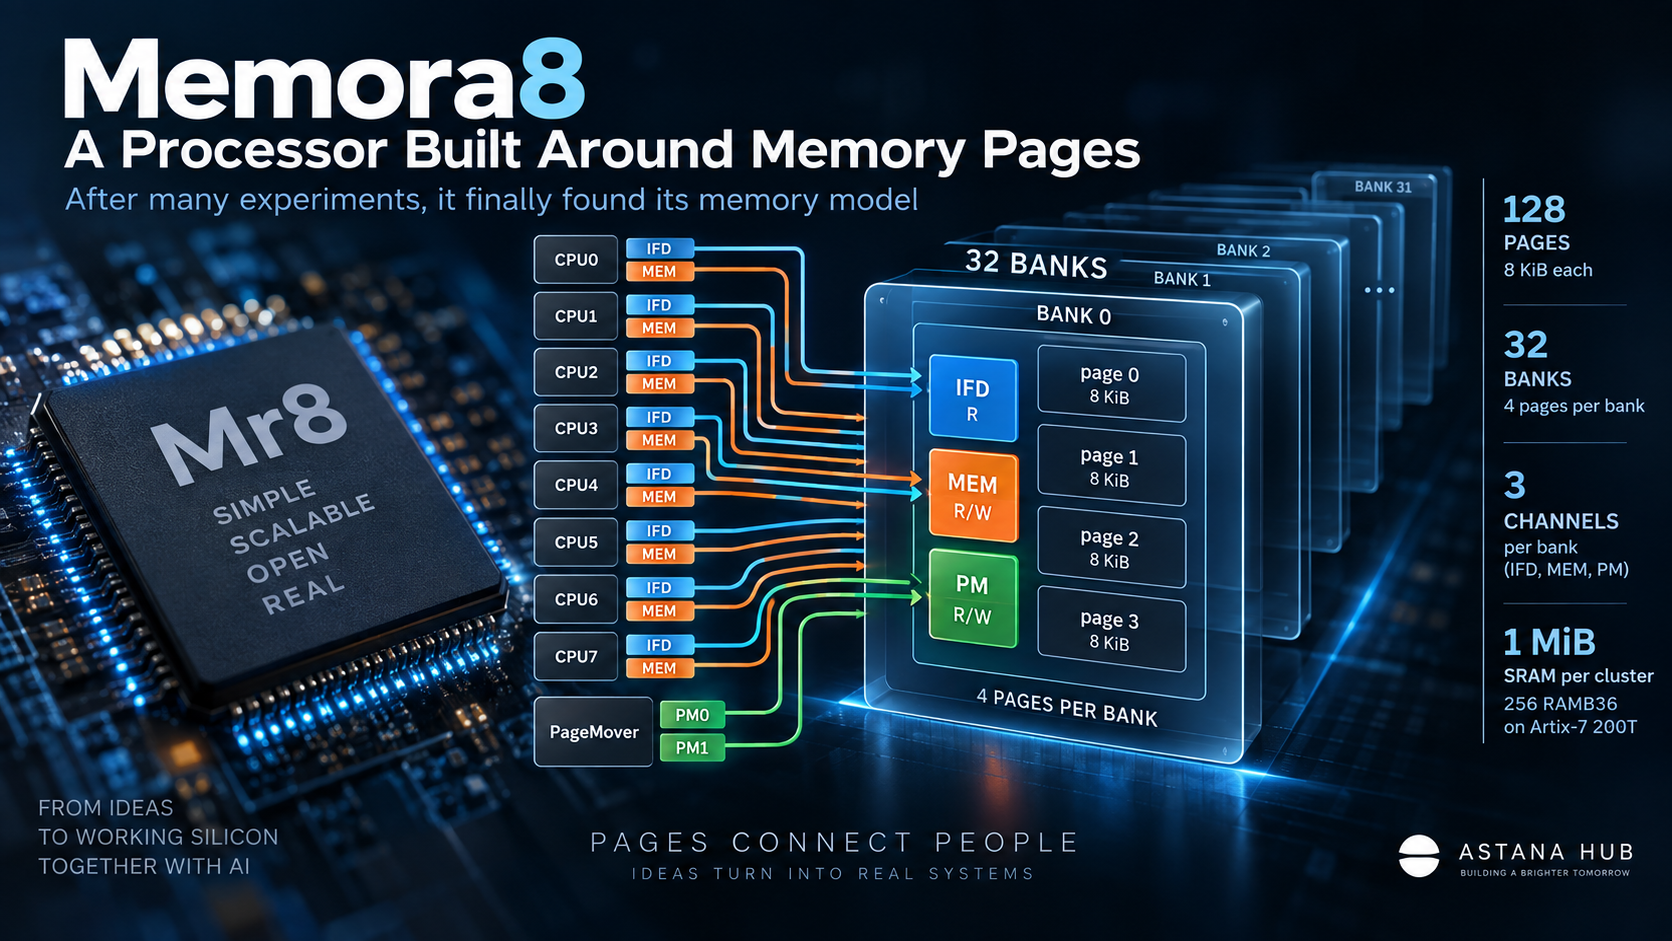
There are 128 physical pages of 8 KiB in one cluster. Eight CPUs have two active memory channels each.: IFD for fetching instructions and MEM for reading and writing data. In addition, PageMover with two channels works with memory, that is, there are potentially eight IFDs, eight MEM and two PM simultaneously — a total of 18 active channels.
The most obvious first idea looked almost perfect: to make a complete crossbar in which any of these 18 channels can connect to any of the 128 pages. Logically, there are almost no restrictions in this scheme — any CPU gets any page, PageMover also has full access, and the placement of code and data can be changed as you like.
On an FPGA, however, such freedom turns out to be very expensive. It quickly became clear that the main problem would not be in the RAMB36 itself, but in the huge amount of logic and routes between 18 sources and 128 independent pages. Therefore, we had to look for a more structured model.
Then private and shared pages appeared.
The next idea was much more traditional. We assumed that each CPU would have eight private pages of its own, and another 32 pages would be shared across the entire cluster. The result was a clear physical structure: most of the accesses remain local to the CPU, and the shared pool is used where memory really needs to be shared.
The eight private pages were primarily intended to be used for IFD. The processor could keep its own code in them and select instructions without competing with other CPUs, which greatly simplified the physical implementation. At this stage, such a scheme looked like a reasonable compromise between the complete freedom of crossbar and the cost of switching.
But then we started looking at the architecture from the operating system side. The OS needs modules, and the module code should not be permanently tied to a specific CPU. The same module may be needed by different processors, so the idea of fixed eight private pages for IFD began to interfere with a more important principle: the processor must connect to the page it needs, rather than the page belonging to a specific processor in advance.
After that, they decided to move away from the rigid division into private and shared memory. It was necessary to preserve the freedom of connecting processors to pages, but to make this freedom physically realizable on the FPGA.
We started looking for the geometry of shared memory
The full amount of memory has already been determined: 128 pages of 8 KiB each, that is, 1 MiB of SRAM per cluster. On the Artix-7 XC7A200T, one such page takes up two RAMB36, so the entire memory uses exactly 256 RAMB36. This volume remained largely unchanged in all further experiments.
The question now sounded different: how to group 128 pages into jars and how many physical channels to give each jar so that processors could still connect to pages freely enough, but switching did not destroy the FPGA.
The first one we checked was the 4×32×10 configuration: four banks, 32 pages each and ten channels per bank. It turned out to be working and even closed 125 MHz. After routing, there were about 49,916 LUTs, 3,800 FF, and 256 RAMB36, and the WNS was about +0.104 ns. Technically, the result was normal, but almost 50 thousand LUTs just around the memory looked like too much of a price.
After that, we increased the number of banks and reduced the number of pages inside each one. The 8×16×10 variant yielded about 48,367 LUTs and 7,280 FF with a WNS of about +0.149 ns. There has not been a strong gain in LUT yet, but we decided to continue the direction.
The next one was 16×8×10. Here, the result has already changed noticeably: about 38,642 LUTs, 14,310 FF, and WNS of approximately +0.187 ns. It seemed that reducing the number of pages within a single bank really simplified local switching, so the next natural step was 32 banks of four pages each.
32×4×10 turned out to be a very useful failure
On paper, 32×4 looked almost perfect. There are many banks, each with only four pages, so different processors can work in parallel, and choosing a specific page inside the bank becomes very easy. We saved ten channels for each bank and tested the 32×4×10 configuration.
This is where the experiment hit a wall. In the full test implementation, the consumption reached about 105 thousand LUTs, and the timing became completely unacceptable. That is, the very idea of many small banks looked good, but ten independent channels for a four-page bank turned out to be too expensive.
This result turned out to be more important than many successful tests. There are only four physical pages in the bank, and ten channels are connected to it, so the FPGA begins to spend huge resources on multiplexers, registers and routing, which physically cannot give proportional gains. It became clear that the problem was no longer in the 32×4 geometry. The problem is the number of channels.
32×4×2 dramatically changed the picture
We left 32 banks and four pages in each, but reduced the number of channels from ten to two. The result was a 32×4×2 variant, and here the result has changed radically.
The memory fabric itself took up about 8,731 LUTs and 5,600 FF after routing, while the memory still used 256 RAMB36. The 125 MHz frequency has already closed with a good margin: WNS turned out to be about +0.885 ns, WHS about +0.103 ns.
At this point, it became clear that we had most likely found the basic physical geometry. Not four large banks or eight or sixteen medium-sized banks, but 32 small banks with four pages each.
But the two universal channels still didn't match the processor itself very well. It was necessary to understand how many channels the Mr8 architecture really needs if we stop trying to make them universal.
The third channel emerged from the processor architecture itself
Each CPU already has two fundamentally different ways to connect to memory. IFD is used to fetch instructions and therefore only reads, while MEM is used for normal data manipulation and must read and write. In addition to the CPU, there is a PageMover, which also needs to read and write pages.
It turned out that the system naturally needed more than ten identical universal channels and not even two identical channels. She needs three specialized paths: IFD, MEM, and PM.
This is how the 32×4×3 scheme appeared. In each bank, the first channel is assigned to IFD and works only for reading, the second is for MEM and works for reading and writing, and the third is dedicated to PageMover and also supports reading and writing. Unlike the original universal schemes, each channel now does only what its query class really needs.
It was this structure that unexpectedly coincided well with the original idea of Memora8.
Each CPU can connect to any of the 32 banks.
There are eight processors in the cluster, and each has one IFD channel and one MEM channel. Both channels can independently select any of the 32 banks. There is no fixed group of banks behind a specific CPU.
For example, CPU0 can receive instructions from BANK0 in one clock cycle and simultaneously work with data in BANK3. At the same time, CPU1 can use BANK2 through both its channels at once, and CPU2 can read instructions from BANK4 and data from BANK5.
It is especially important when the IFD and MEM of the same processor access the same bank. This is allowed because there are different physical channels for them inside the bank. They only have to select different physical pages.
It turns out exactly the model that we gradually moved towards from the first experiments: the processor is not tied to a pre-allocated piece of memory. It connects to the desired page through a suitable channel for the operation.
One bank can simultaneously service IFD, MEM and PageMover
Each bank has four physical pages and three specialized channels. Therefore, in one clock cycle, the IFD can work, for example, with page0, MEM with page1, and PageMover with page2 of the same bank. All three operations are performed in parallel.
The main physical limitation is that one page remains single-port, so two channels should not select the same page at the same time. In addition, a particular bank has only one channel of each type, so two IFDs of different CPUs cannot simultaneously come to the same bank, even if they want different pages. The same rule applies for two MEM requests.
PageMover has two RW channels at the system level, but there is one PM line within a particular bank. Therefore, two PM requests to the same bank at the same time also conflict, whereas a combination of one IFD, one MEM and one PM is completely acceptable for different pages.
It turned out to be a fairly simple rule that fits well with the physics of SRAM and at the same time does not require heavy universal arbitration of everyone with everyone.
PageMover also just connects to the page.
Separately, the PageMover model has developed successfully. For SRAM, it doesn't look like some kind of special or privileged device: PageMover selects the bank, page, and address, and then performs a normal read or write.
The only difference is in the connection method. The CPU has IFD and MEM, and PageMover has its own RW channel. As a result, the entire memory becomes fairly homogeneous: there are pages and several types of devices that can connect to them.
For an architecture built around pages, this looks much more natural than a separate special memory path for each system unit.
What happened on Artix-7 200T
The final model consists of 32 banks, four pages in each bank and three specialized channels per bank. The total volume remains equal to 1 MiB, for which 256 RAMB36 are used.
After full synthesis, placement, and routing in Vivado on XC7A200T-FBG484-2, the implementation took 22,071 LUTs and 8,890 FF. The target frequency of 125 MHz closed with WNS +0.215 ns and WHS +0.061 ns, while TNS and THS remained at zero. There are no Setup and hold violations.
That is, it is no longer just a scheme that looks logical on a diagram. It has completely passed the physical implementation on the target FPGA.
It looks like this is the Mr8 memory.
If you look at the whole path, it turned out to be quite long. We started with the most naive idea.: 128 independent pages and a full crossbar, through which 18 active channels are connected to them. Then they tried to simplify the system with eight private pages per CPU and 32 shared pages per cluster, with private memory primarily intended to be used for IFD.
This model stopped working when it became clear that the operating system needed modules and the code could not be rigidly tied to a single processor. After that, we moved on to the shared page memory and started looking for its physical geometry.: first 4×32×10, then 8×16×10, 16×8×10 and finally 32×4×10.
On 32x4x10, we got about 105 thousand LUTs and very poor timing, but this result showed that 32 banks of four pages each can be the correct basis, and the problem is in ten channels. The transition to 32x4x2 dramatically reduced fabric and confidently closed 125 MHz, and then 32x4x3 added exactly the third channel that the architecture really needs: IFD, MEM and PageMover received their own specialized paths.
After all these experiments, it looks like Memora8 has finally got its memory model. This is not a set of private SRAM around each CPU or a huge universal crossbar, but 128 pages of 8 KiB each, organized as 32 banks of four pages. Processors are dynamically connected to them via IFD and MEM, while PageMover is connected via its own channel.
There is a certain completeness to the original idea. The number 8 in Memora8 from the very beginning meant the size of the memory page, and now the physical architecture of the processor is really built around connecting to these pages.
The search itself turned out to be an interesting experience for me working with AI. We discussed the architecture with ChatGPT, not with Codex: I suggested the next options, we analyzed the consequences, decided what was really worth checking, prepared the next implementation and looked at the Vivado results again. ChatGPT here was not the "processor author" or just a Verilog generator, but a tool for a lengthy engineering dialogue in which each hypothesis was ultimately tested by real synthesis and routing on a specific FPGA.
And after this series of iterations, it seems that the Mr8 has finally got a memory that truly matches its own architecture.
Последние дни мы довольно плотно обсуждали с ChatGPT архитектуру памяти для процессора Memora8 и одну за другой проверяли гипотезы на FPGA. Это был именно обычный диалог с ChatGPT, не работа через Codex: я предлагал очередные варианты, мы обсуждали, что в них может сработать, что выглядит слишком дорого и что имеет смысл проверить следующим. После каждого такого обсуждения появлялась очередная RTL-реализация, а окончательный ответ давал уже Vivado после synthesis, placement и routing на Artix-7 200T.
После довольно продолжительной серии таких итераций, похоже, модель памяти наконец сложилась. Причём путь к ней оказался гораздо интереснее, чем я ожидал в начале.
Почему вообще Memora8
Название процессора напрямую связано с памятью. Memoro на эсперанто означает «память», окончание -a образует прилагательное, а цифра 8 в Memora8 — это не количество процессоров и не номер ядра. Она означает размер базовой страницы памяти — 8 KiB. Короткое название процессора — Mr8.
То, что в одном кластере сейчас восемь CPU, в данном случае просто совпадение с цифрой в названии. Основная идея Mr8 в другом: процессоры работают не с абстрактным единым массивом SRAM, а подключаются к нужным им страницам памяти. Поэтому поиск физической модели памяти оказался не вспомогательной задачей, а одной из центральных частей архитектуры процессора.
Самая первая идея была совсем наивной
В одном кластере 128 физических страниц по 8 KiB. У восьми CPU есть по два активных канала работы с памятью: IFD для выборки инструкций и MEM для чтения и записи данных. Кроме них, с памятью работает PageMover с двумя каналами, то есть потенциально одновременно существуют восемь IFD, восемь MEM и два PM — всего 18 активных каналов.
Самая очевидная первая идея выглядела почти идеально: сделать полный crossbar, в котором любой из этих 18 каналов может подключиться к любой из 128 страниц. Логически в такой схеме почти нет ограничений — любой CPU получает любую страницу, PageMover тоже имеет полный доступ, а размещение кода и данных можно менять как угодно.
На FPGA, однако, такая свобода оказывается очень дорогой. Очень быстро стало понятно, что основная проблема будет не в самих RAMB36, а в огромном количестве логики и маршрутов между 18 источниками и 128 независимыми страницами. Поэтому пришлось искать более структурированную модель.
Потом появились private и shared страницы
Следующая идея была гораздо более традиционной. Мы предполагали, что у каждого CPU будет по восемь собственных private-страниц, а ещё 32 страницы будут shared на весь кластер. Получалась понятная физическая структура: большая часть обращений остаётся локальной для CPU, а общий пул используется там, где память действительно должна разделяться.
Восемь private-страниц прежде всего предполагалось использовать для IFD. Процессор мог держать в них свой код и выбирать инструкции без конкуренции с другими CPU, что сильно упрощало физическую реализацию. На этом этапе такая схема выглядела вполне разумным компромиссом между полной свободой crossbar и стоимостью коммутации.
Но затем мы начали смотреть на архитектуру уже со стороны операционной системы. ОС нужны модули, и код модуля не должен быть навсегда привязан к конкретному CPU. Один и тот же модуль может понадобиться разным процессорам, поэтому идея фиксированных восьми private-страниц под IFD начала мешать более важному принципу: процессор должен подключаться к нужной ему странице, а не страница заранее принадлежать конкретному процессору.
После этого от жёсткого деления на private и shared память решили уходить. Нужно было сохранить свободу подключения процессоров к страницам, но сделать эту свободу физически реализуемой на FPGA.
Начали искать геометрию общей памяти
Полный объём памяти уже был определён: 128 страниц по 8 KiB, то есть 1 MiB SRAM на кластер. На Artix-7 XC7A200T одна такая страница занимает два RAMB36, поэтому вся память использует ровно 256 RAMB36. Этот объём во всех дальнейших экспериментах в основном оставался неизменным.
Вопрос теперь звучал иначе: как сгруппировать 128 страниц в банки и сколько физических каналов дать каждому банку, чтобы процессоры всё ещё могли достаточно свободно подключаться к страницам, но коммутация не уничтожала FPGA.
Первой проверили конфигурацию 4×32×10: четыре банка, по 32 страницы в каждом и десять каналов на банк. Она оказалась рабочей и даже закрыла 125 MHz. После routing было около 49 916 LUT, 3 800 FF и 256 RAMB36, а WNS составлял примерно +0,104 ns. Технически результат был нормальным, но почти 50 тысяч LUT только вокруг памяти выглядели слишком большой ценой.
После этого мы увеличили количество банков и уменьшили количество страниц внутри каждого. Вариант 8×16×10 дал около 48 367 LUT и 7 280 FF при WNS около +0,149 ns. Сильного выигрыша по LUT ещё не произошло, но направление решили продолжить.
Следующим был 16×8×10. Здесь результат уже заметно изменился: около 38 642 LUT, 14 310 FF и WNS примерно +0,187 ns. Стало похоже, что уменьшение числа страниц внутри одного банка действительно упрощает локальную коммутацию, поэтому следующим естественным шагом были 32 банка по четыре страницы.
32×4×10 оказался очень полезным провалом
На бумаге 32×4 выглядело почти идеально. Банков много, в каждом всего четыре страницы, поэтому разные процессоры могут работать параллельно, а выбор конкретной страницы внутри банка становится очень простым. Мы сохранили десять каналов на каждый банк и проверили конфигурацию 32×4×10.
Именно здесь эксперимент упёрся в стену. В полной тестовой реализации расход дошёл примерно до 105 тысяч LUT, а timing стал совершенно неприемлемым. То есть сама идея множества маленьких банков выглядела хорошо, но десять независимых каналов на четырёхстраничный банк оказались слишком дорогими.
Этот результат оказался важнее многих успешных тестов. В банке всего четыре физические страницы, а к нему подводится десять каналов, поэтому FPGA начинает тратить огромные ресурсы на мультиплексоры, регистры и routing, которые физически не могут дать пропорционального выигрыша. Стало понятно, что проблема уже не в геометрии 32×4. Проблема — в количестве каналов.
32×4×2 резко изменил картину
Мы оставили 32 банка и четыре страницы в каждом, но сократили количество каналов с десяти до двух. Получился вариант 32×4×2, и здесь результат изменился радикально.
Сам memory fabric после routing занял около 8 731 LUT и 5 600 FF, при этом память по-прежнему использовала 256 RAMB36. Частота 125 MHz закрылась уже с хорошим запасом: WNS получился около +0,885 ns, WHS около +0,103 ns.
В этот момент стало понятно, что базовую физическую геометрию мы, скорее всего, нашли. Не четыре больших банка и не восемь или шестнадцать средних, а именно 32 небольших банка по четыре страницы.
Но два универсальных канала всё ещё не очень хорошо соответствовали самому процессору. Нужно было понять, сколько каналов реально требуется архитектуре Mr8, если перестать пытаться делать их универсальными.
Третий канал появился из самой архитектуры процессора
У каждого CPU уже есть два принципиально разных способа подключения к памяти. IFD используется для выборки инструкций и поэтому только читает, а MEM используется для обычной работы с данными и должен читать и писать. Кроме CPU, есть PageMover, которому тоже необходимо читать и писать страницы.
Получалось, что системе естественно нужны не десять одинаковых универсальных каналов и даже не два одинаковых канала. Ей нужны три специализированных пути: IFD, MEM и PM.
Так появилась схема 32×4×3. В каждом банке первый канал закреплён за IFD и работает только на чтение, второй предназначен для MEM и работает на чтение и запись, а третий выделен PageMover и также поддерживает чтение и запись. В отличие от исходных универсальных схем, каждый канал теперь делает только то, что действительно требуется его классу запросов.
Именно эта структура неожиданно хорошо совпала с исходной идеей Memora8.
Каждый CPU может подключиться к любому из 32 банков
В кластере восемь процессоров, и у каждого есть один IFD-канал и один MEM-канал. Оба канала могут независимо выбрать любой из 32 банков. Никакой фиксированной группы банков за конкретным CPU нет.
Например, CPU0 в одном такте может получать инструкцию из BANK0 и одновременно работать с данными в BANK3. CPU1 в это же время может использовать BANK2 сразу через оба своих канала, а CPU2 — читать инструкцию из BANK4 и данные из BANK5.
Особенно важен случай, когда IFD и MEM одного процессора обращаются к одному банку. Это разрешено, потому что внутри банка для них существуют разные физические каналы. Они должны только выбрать разные физические страницы.
Получается именно та модель, к которой мы постепенно шли от первых экспериментов: процессор не привязан к заранее выделенному куску памяти. Он подключается к нужной странице через подходящий для операции канал.
Один банк может одновременно обслуживать IFD, MEM и PageMover
В каждом банке четыре физические страницы и три специализированных канала. Поэтому в одном такте IFD может работать, например, с page0, MEM с page1, а PageMover с page2 того же самого банка. Все три операции выполняются параллельно.
Главное физическое ограничение состоит в том, что одна страница остаётся однопортовой, поэтому два канала не должны одновременно выбирать одну и ту же страницу. Кроме того, у конкретного банка есть только один канал каждого типа, поэтому два IFD разных CPU не могут одновременно прийти в один банк, даже если хотят разные страницы. То же правило действует для двух MEM-запросов.
У PageMover на уровне системы два RW-канала, но внутри конкретного банка существует одна PM-линия. Поэтому два PM-запроса к одному банку одновременно также конфликтуют, тогда как комбинация одного IFD, одного MEM и одного PM полностью допустима при разных страницах.
Получилось довольно простое правило, которое хорошо соответствует физике SRAM и при этом не требует тяжёлого универсального арбитража всех со всеми.
PageMover тоже просто подключается к странице
Отдельно удачно сложилась модель PageMover. Для SRAM он не выглядит каким-то специальным или привилегированным устройством: PageMover выбирает банк, страницу и адрес, после чего выполняет обычное чтение или запись.
Различие только в способе подключения. У CPU есть IFD и MEM, а у PageMover — собственный RW-канал. В результате вся память становится довольно однородной: существуют страницы и несколько типов устройств, которые могут к ним подключаться.
Для архитектуры, построенной вокруг страниц, это выглядит гораздо естественнее, чем отдельный специальный тракт памяти для каждого системного блока.
Что получилось на Artix-7 200T
Финальная модель состоит из 32 банков, четырёх страниц в каждом банке и трёх специализированных каналов на банк. Полный объём остаётся равным 1 MiB, для чего используются 256 RAMB36.
После полного synthesis, placement и routing в Vivado на XC7A200T-FBG484-2 реализация заняла 22 071 LUT и 8 890 FF. Целевая частота 125 MHz закрылась с WNS +0,215 ns и WHS +0,061 ns, а TNS и THS остались равны нулю. Setup и hold violations нет.
То есть это уже не просто схема, которая логично выглядит на диаграмме. Она полностью прошла физическую реализацию на целевой FPGA.
Похоже, это и есть память Mr8
Если посмотреть на весь путь целиком, он получился довольно длинным. Мы начали с самой наивной идеи: 128 независимых страниц и полный crossbar, через который к ним подключаются 18 активных каналов. Затем попытались упростить систему с помощью восьми private-страниц на каждый CPU и 32 shared-страниц на кластер, причём private-память предполагалось прежде всего использовать для IFD.
Эта модель перестала устраивать, когда стало понятно, что операционной системе нужны модули и код нельзя жёстко привязывать к одному процессору. После этого мы перешли к общей страничной памяти и начали искать её физическую геометрию: сначала 4×32×10, затем 8×16×10, 16×8×10 и наконец 32×4×10.
На 32×4×10 мы получили порядка 105 тысяч LUT и очень плохой timing, но именно этот результат показал, что 32 банка по четыре страницы могут быть правильной основой, а проблема находится в десяти каналах. Переход к 32×4×2 резко уменьшил fabric и уверенно закрыл 125 MHz, а затем 32×4×3 добавил ровно тот третий канал, который действительно нужен архитектуре: IFD, MEM и PageMover получили собственные специализированные пути.
После всех этих экспериментов, похоже, Memora8 наконец получил свою модель памяти. Это не набор private SRAM вокруг каждого CPU и не огромный универсальный crossbar, а 128 страниц по 8 KiB, организованных как 32 банка по четыре страницы. Процессоры динамически подключаются к ним через IFD и MEM, а PageMover — через свой собственный канал.
В этом есть определённая завершённость исходной идеи. Цифра 8 в Memora8 с самого начала означала размер страницы памяти, а теперь и физическая архитектура процессора действительно строится вокруг подключения к этим страницам.
Сам поиск оказался для меня интересным опытом работы с AI. Мы обсуждали архитектуру именно с ChatGPT, не с Codex: я предлагал очередные варианты, мы разбирали последствия, решали, что стоит реально проверить, готовили следующую реализацию и снова смотрели результаты Vivado. ChatGPT здесь был не «автором процессора» и не просто генератором Verilog, а инструментом для продолжительного инженерного диалога, в котором каждая гипотеза в конечном счёте проверялась реальным synthesis и routing на конкретной FPGA.
И после этой серии итераций кажется, что Mr8 наконец получил память, которая действительно соответствует его собственной архитектуре.

 Share








