

The post has been translated automatically. Original language: Russian




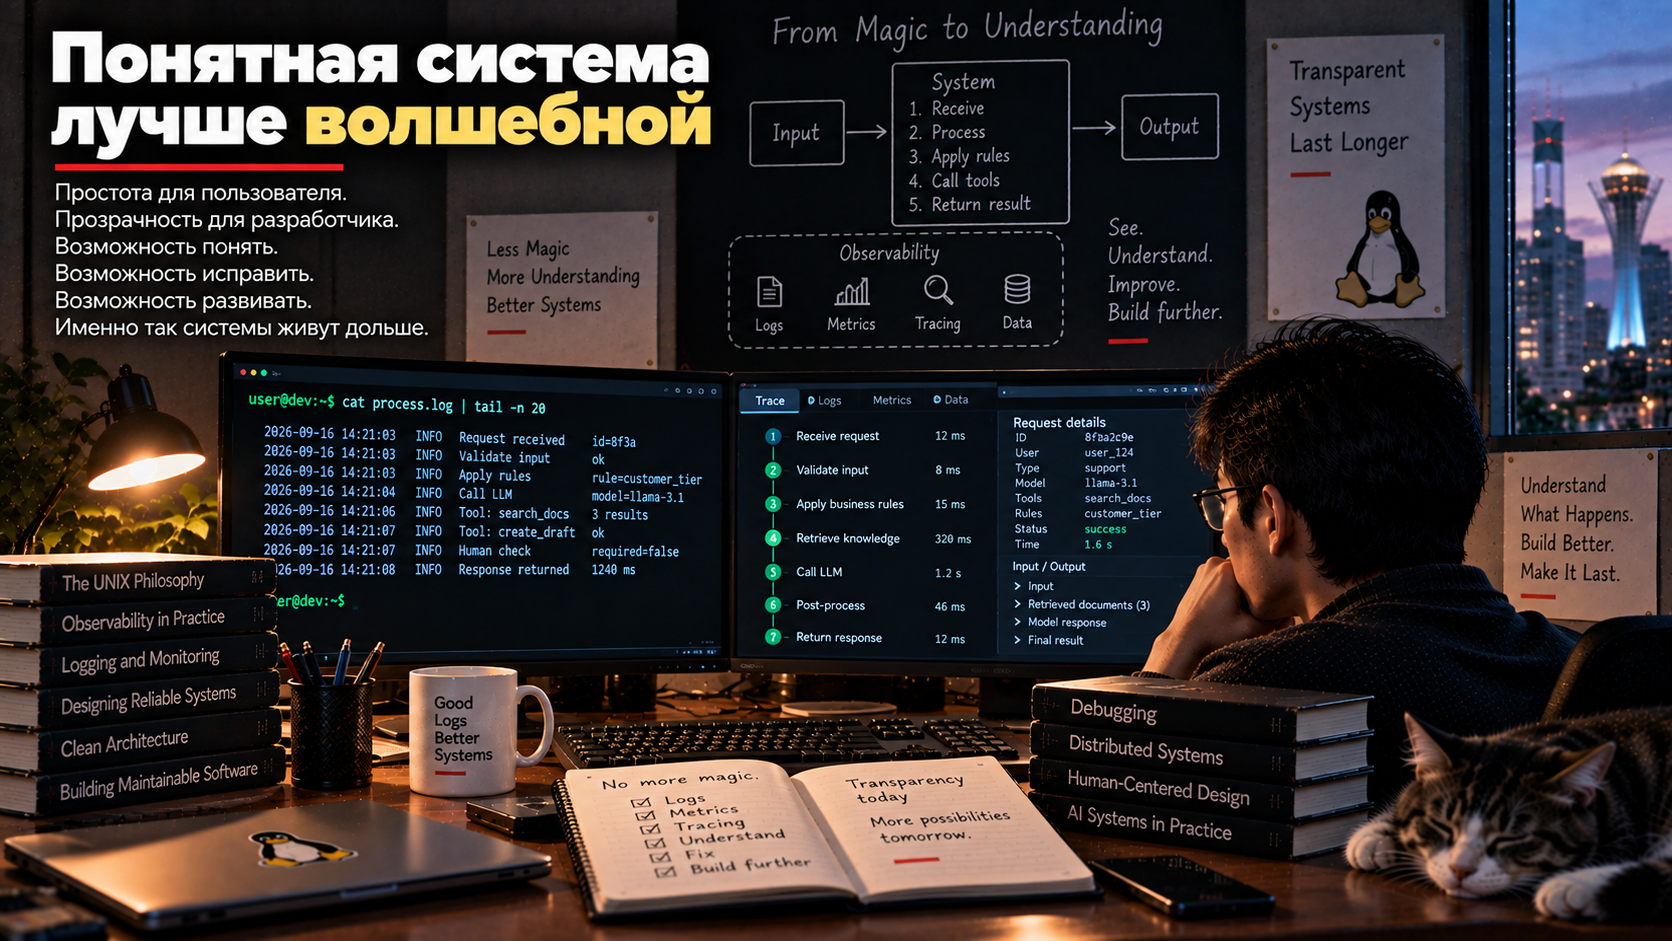
A good program often creates a sense of simplicity. I pressed the button and got the result. I ran the command, and everything worked. The user doesn't need to know what's going on inside, and that's fine.
The problem begins when the system becomes incomprehensible even to those who create and maintain it. As long as everything is working, this kind of "magic" seems convenient. But at the first serious mistake, it turns out that no one can explain why the system behaved the way it did.
One of the strong ideas of the Unix culture is that the device of the system should remain accessible for research.
Simplicity of the interface and transparency are not the same thing.
You can create a very simple interface on top of an extremely complex system. The user sees one button, and dozens of processes, network requests, and internal rules are launched after it.
That in itself is not a bad thing. The user doesn't really need to know all the details.
But the developer should still have the opportunity to go down and see what happened. What data was received at the input, which components worked, what they returned, and where the error occurred.
Simplicity is good when it hides unnecessary details, rather than destroying the opportunity to figure things out.
The black box is only useful until the first problem
Imagine a component that receives a request and returns a response. As long as the result is correct, no one is interested in the internal structure.
But one day the answer turns out to be wrong. Then a series of questions arise. What data did the component receive? Which rule worked? Which external service did he turn to? What did he return? Why was this particular path chosen?
If these questions cannot be answered, the system turns into a real black box.
Such systems are difficult to maintain, not because they are necessarily poorly written, but because their behavior is impossible to observe.
Unix shows a lot of things directly
Classic Unix is quite talkative in many places.
You can view the list of processes, files, access rights, open connections, log contents, and environment variables. Commands usually accept understandable data and produce understandable results.
This creates a sense of a system that you can look into.
Not everything is necessarily simple, but there is almost always a next level that can be explored. The user gradually moves from the symptom to the cause.
This accessibility of the internal state helps a lot to learn and look for mistakes.
The intermediate result has value
One of the advantages of software pipelines is that you can stop after any step and see the result.
If a chain of five programs gives the wrong answer, it is not necessary to investigate all at once. You can run the first two and check what happened. Then add the third one.
This is how the error is gradually localized.
This is a good general principle for any architecture: it is useful to build a complex process so that intermediate states can be seen.
If the system only shows the final result, finding the cause becomes much more difficult.
Logs are not just text for an accident
Many programs keep logs just because "it's supposed to". In normal mode, no one looks at them, and when a problem appears, it turns out that the recordings explain almost nothing.
A good log should allow you to restore the progress of the system.
What happened? When? With what object? Which component made the decision? What was done after that?
At the same time, an overly detailed log is also useless. Millions of technical lines can hide important things no worse than a complete lack of information.
Transparency is not the maximum amount of data, but the opportunity to restore the meaning of what is happening.
A good mistake explains the reason
The quality of the system is particularly evident in error messages.
The bad message says: the operation failed.
A good one explains exactly what the system was trying to do, which step failed, and what can be checked.
It seems like a small thing, but such details determine how easily a person is able to explore the system.
If every error requires reading the source code, the interface between the program and the developer is poorly designed.
Automation should leave a mark
The more the system does automatically, the more important it is to understand exactly what it has done.
If the program itself modifies data, sends messages, runs tasks, or makes decisions, it is useful to have a history of these actions.
Who or what initiated the operation? What conditions were fulfilled? What data was used? What is the result?
Without such a trace, automation becomes difficult to control.
The system can work perfectly a thousand times, but one unexplained error can create a serious problem.
Convenience often hides complexity.
Modern platforms allow you to create applications very quickly. Cloud services take on storage, networking, scaling, authorization, and many other tasks.
This is a huge progress. There is no point in manually solving a problem that someone else has reliably solved.
But there is a risk of starting to consider external service magic.
When a system depends on a component whose device the developer does not understand at all, he should at least know its boundaries. What guarantees does it give? What happens when an error occurs? What are the limitations in terms of volume, time, or order of operations?
It is not necessary to understand the implementation of each library. You need to understand the contract that your system relies on.
Abstraction should have a door down
A good abstraction allows you to work at a high level while everything is going well. But if necessary, there should be an opportunity to look deeper.
For example, usually a developer doesn't need to think about network packets. But if there is an unusual connection problem, it is useful to have tools that allow you to see them.
The same applies to databases, queues, file systems, and other layers.
Abstraction is useful until it turns into a wall.
We can say that a good system has a ladder down: from each level you can go to the next and continue exploring.
Artificial intelligence creates a new kind of magic
Artificial intelligence systems reinforce this problem.
The person asks the question, the model gives the answer. There is a huge amount of computation going on between the input and output, which cannot be explored in the same way as a regular program line by line.
Therefore, it is especially important to make transparent at least those parts of the system that we can control.
What data was passed to the model? What instructions did she receive? What external tools did you use? What rules were applied? What result did each stage return?
If you leave only the question and the final answer, the system becomes too opaque.
No need to explain the internals of the model
The transparency of an artificial intelligence system does not mean that we should be able to explain the operation of each parameter of a neural network.
This is almost impossible and usually unnecessary.
But you can make the very process of applying the model transparent.
For example, you can show which documents were used, which rules were active, which tool was called, where the person's confirmation was required, and what exactly changed after completing the task.
So even a complex mechanism remains a part of the observed system.
Artificial intelligence must remain a tool
There is a temptation to hand over the entire big task to the model and accept the final result.
This is convenient, but reduces the observability.
It is much more reliable when the work is divided into clear stages. Get the data. Check them out. Apply the rules. Suggest a solution. Perform the action after confirmation.
In this case, artificial intelligence remains a powerful tool within the system, rather than becoming an entire system.
This is very similar to the old Unix approach: individual components perform understandable operations, and the result can be observed at each boundary.
Transparency helps not only to look for mistakes.
A clear system is easier to change.
If a developer sees the boundaries of components, data flows, and reasons for decisions, it's easier for them to identify a place for a new feature.
If everything is hidden behind several layers of implicit behavior, even a small change has to be made almost blindly.
Transparency reduces the cost of system development.
It allows you not only to fix what is broken today, but also to make it safer to change what is needed tomorrow.
Clarity is part of reliability
Sometimes reliability is perceived as a purely technical property: the program does not crash, data is not lost, and the server responds.
But there is another kind of reliability.
Is it possible to understand the system when something goes wrong?
Is it possible to reproduce the problem?
Is it possible to explain the solution?
Is it possible to determine what exactly has changed between the two launches?
If not, formal performance does not make the system truly reliable.
A good system doesn't have to be simple inside.
Modern programs are inevitably complex. It would be naive to expect that a large distributed system can be made as understandable as a small Unix command.
But you can make its boundaries clear.
You can make the data streams observable. Save the history of actions. Write meaningful magazines. Separate the processing steps. Provide an opportunity to view interim results.
That's already a lot.
The goal is not to destroy complexity, but to prevent it from becoming invisible.
Magic is good for the user, but dangerous for the developer.
The user has every right to see a simple button instead of thousands of lines of code. This is exactly what good programs are created for.
But a developer shouldn't believe in their own magic.
Each button should have clear mechanisms, observable data, and the ability to answer the question: why did the system do this?
When such a response exists, the complex system remains manageable.
When it's not there, the system may look very smart and convenient, but it's gradually turning into a thing that everyone is afraid to change.
Therefore, an understandable system is not necessarily simpler than a magical one.
It just leaves the person with an opportunity to figure it out.
Хорошая программа часто создаёт ощущение простоты. Нажал кнопку — получил результат. Запустил команду — всё сработало. Пользователю не обязательно знать, что происходит внутри, и это нормально.
Проблема начинается тогда, когда система становится непонятной даже тем, кто её создаёт и поддерживает. Пока всё работает, такая «магия» кажется удобной. Но при первой серьёзной ошибке выясняется, что никто не может объяснить, почему система повела себя именно так.
Одна из сильных идей Unix-культуры состоит в том, что устройство системы должно оставаться доступным для исследования.
Простота интерфейса и прозрачность — не одно и то же
Можно сделать очень простой интерфейс поверх чрезвычайно сложной системы. Пользователь видит одну кнопку, а за ней запускаются десятки процессов, сетевых запросов и внутренних правил.
Само по себе это не плохо. Пользователю действительно не нужно знать все детали.
Но у разработчика должна оставаться возможность спуститься ниже и увидеть, что произошло. Какие данные пришли на вход, какие компоненты сработали, что они вернули и где возникла ошибка.
Простота хороша тогда, когда она скрывает ненужные детали, а не уничтожает возможность разобраться.
Чёрный ящик удобен только до первой проблемы
Представим компонент, который получает запрос и возвращает ответ. Пока результат правильный, внутреннее устройство никого не интересует.
Но однажды ответ оказывается неправильным. Тогда возникает серия вопросов. Какие данные получил компонент? Какое правило сработало? К какому внешнему сервису он обратился? Что тот вернул? Почему был выбран именно этот путь?
Если на эти вопросы невозможно ответить, система превращается в настоящий чёрный ящик.
Такие системы трудно сопровождать не потому, что они обязательно плохо написаны, а потому, что их поведение невозможно наблюдать.
Unix многое показывает прямо
Классический Unix во многих местах довольно разговорчив.
Можно посмотреть список процессов, файлы, права доступа, открытые соединения, содержимое журналов, переменные окружения. Команды обычно принимают понятные данные и выдают понятный результат.
Это создаёт ощущение системы, в которую можно заглянуть.
Не всё обязательно просто, но почти всегда существует следующий уровень, который можно исследовать. Пользователь постепенно движется от симптома к причине.
Такая доступность внутреннего состояния очень помогает учиться и искать ошибки.
Промежуточный результат имеет ценность
Одно из преимуществ программных конвейеров состоит в том, что можно остановиться после любого шага и посмотреть результат.
Если цепочка из пяти программ выдаёт неправильный ответ, необязательно исследовать всё сразу. Можно запустить первые две и проверить, что получилось. Затем добавить третью.
Так ошибка постепенно локализуется.
Это хороший общий принцип для любой архитектуры: сложный процесс полезно строить так, чтобы промежуточные состояния можно было увидеть.
Если система показывает только окончательный результат, поиск причины становится намного сложнее.
Журналы — не просто текст для аварии
Многие программы ведут журналы только потому, что «так положено». В нормальном режиме на них никто не смотрит, а когда появляется проблема, выясняется, что записи почти ничего не объясняют.
Хороший журнал должен позволять восстановить ход работы системы.
Что произошло? Когда? С каким объектом? Какой компонент принял решение? Что было сделано после этого?
При этом слишком подробный журнал тоже бесполезен. Миллионы технических строк могут скрыть важное не хуже полного отсутствия информации.
Прозрачность — это не максимальное количество данных, а возможность восстановить смысл происходящего.
Хорошая ошибка объясняет причину
Особенно хорошо качество системы видно по сообщениям об ошибках.
Плохое сообщение говорит: операция не выполнена.
Хорошее объясняет, что именно система пыталась сделать, какой шаг не удался и что можно проверить.
Это кажется мелочью, но такие детали определяют, насколько легко человек способен исследовать систему.
Если каждая ошибка требует чтения исходного кода, интерфейс между программой и разработчиком спроектирован плохо.
Автоматизация должна оставлять след
Чем больше система делает автоматически, тем важнее понимать, что именно она сделала.
Если программа сама изменяет данные, отправляет сообщения, запускает задачи или принимает решения, полезно иметь историю этих действий.
Кто или что инициировало операцию? Какие условия были выполнены? Какие данные использовались? Каков результат?
Без такого следа автоматизация становится трудно контролируемой.
Система может работать идеально тысячу раз, но одна необъяснимая ошибка способна создать серьёзную проблему.
Удобство часто скрывает сложность
Современные платформы позволяют очень быстро создавать приложения. Облачные службы берут на себя хранение, сети, масштабирование, авторизацию и множество других задач.
Это огромный прогресс. Нет смысла вручную решать проблему, которую надёжно решил кто-то другой.
Но есть риск начать считать внешнюю службу магией.
Когда система зависит от компонента, устройство которого разработчик совершенно не понимает, он должен хотя бы знать его границы. Какие гарантии он даёт? Что происходит при ошибке? Какие ограничения есть по объёму, времени или порядку операций?
Не обязательно понимать реализацию каждой библиотеки. Нужно понимать договор, на который опирается твоя система.
Абстракция должна иметь дверь вниз
Хорошая абстракция позволяет работать на высоком уровне, пока всё идёт нормально. Но при необходимости должна существовать возможность посмотреть глубже.
Например, обычно разработчику не нужно думать о сетевых пакетах. Но если возникает необычная проблема соединения, полезно иметь инструменты, которые позволяют их увидеть.
То же относится к базам данных, очередям, файловым системам и другим слоям.
Абстракция полезна, пока не превращается в стену.
Можно сказать, что хорошая система имеет лестницу вниз: с каждого уровня можно перейти на следующий и продолжить исследование.
Искусственный интеллект создаёт новую разновидность магии
Системы искусственного интеллекта усиливают эту проблему.
Человек задаёт вопрос, модель выдаёт ответ. Между входом и выходом происходит огромный объём вычислений, который невозможно исследовать так же, как обычную программу построчно.
Поэтому особенно важно сделать прозрачными хотя бы те части системы, которые мы можем контролировать.
Какие данные были переданы модели? Какие инструкции она получила? Какие внешние инструменты использовала? Какие правила были применены? Какой результат вернул каждый этап?
Если оставить только вопрос и окончательный ответ, система становится слишком непрозрачной.
Не нужно объяснять внутренности модели
Прозрачность системы с искусственным интеллектом не означает, что мы должны уметь объяснить работу каждого параметра нейронной сети.
Это почти невозможно и обычно не нужно.
Но можно сделать прозрачным сам процесс применения модели.
Например, показать, какие документы использовались, какие правила были активны, какой инструмент вызван, где потребовалось подтверждение человека и что именно изменилось после выполнения задачи.
Так даже сложный механизм остаётся частью наблюдаемой системы.
Искусственный интеллект должен оставаться инструментом
Есть соблазн передать модели большую задачу целиком и принять окончательный результат.
Это удобно, но снижает наблюдаемость.
Гораздо надёжнее, когда работа разделена на понятные этапы. Получить данные. Проверить их. Применить правила. Предложить решение. Выполнить действие после подтверждения.
Тогда искусственный интеллект остаётся сильным инструментом внутри системы, а не превращается в систему целиком.
Это очень похоже на старый Unix-подход: отдельные компоненты выполняют понятные операции, а результат можно наблюдать на каждой границе.
Прозрачность помогает не только искать ошибки
Понятная система проще изменяется.
Если разработчик видит границы компонентов, потоки данных и причины решений, ему легче определить место для новой функции.
Если всё скрыто за несколькими слоями неявного поведения, даже небольшое изменение приходится делать почти вслепую.
Прозрачность снижает стоимость развития системы.
Она позволяет не только исправить то, что сломалось сегодня, но и безопаснее изменить то, что понадобится завтра.
Понятность — часть надёжности
Иногда надёжность воспринимают как чисто техническое свойство: программа не падает, данные не теряются, сервер отвечает.
Но есть и другой вид надёжности.
Можно ли понять систему, когда что-то идёт не так?
Можно ли воспроизвести проблему?
Можно ли объяснить решение?
Можно ли определить, что именно изменилось между двумя запусками?
Если нет, формальная работоспособность ещё не делает систему действительно надёжной.
Хорошая система не обязана быть простой внутри
Современные программы неизбежно сложны. Было бы наивно ожидать, что большую распределённую систему можно сделать такой же понятной, как небольшую команду Unix.
Но можно сделать понятными её границы.
Можно сделать наблюдаемыми потоки данных. Сохранять историю действий. Писать осмысленные журналы. Разделять этапы обработки. Давать возможность посмотреть промежуточные результаты.
Это уже очень много.
Цель не в том, чтобы уничтожить сложность, а в том, чтобы не позволить ей стать невидимой.
Магия хороша для пользователя, но опасна для разработчика
Пользователь имеет полное право видеть простую кнопку вместо тысячи строк кода. Именно для этого и создаются хорошие программы.
Но разработчик не должен верить в собственную магию.
За каждой кнопкой должны оставаться понятные механизмы, наблюдаемые данные и возможность ответить на вопрос: почему система сделала именно это?
Когда такой ответ существует, сложная система остаётся управляемой.
Когда его нет, система может выглядеть очень умной и удобной, но постепенно превращается в вещь, которую все боятся менять.
Поэтому понятная система не обязательно проще волшебной.
Она просто оставляет человеку возможность разобраться.

 Share








