



The post has been translated automatically. Original language: Russian


When the team waits for the results of the A/B test until the next morning, the analytical infrastructure begins to determine the speed of product decisions. At Kwai, this problem was solved by transferring the calculation of metrics from Spark to Apache Doris and deep optimization of calculations.
On Habré, we published a translation of the case by Siwei Zeng, an architect of data processing engines at Kwai. Below are the main results and engineering conclusions that are useful for teams developing their own analytics.
What happened to Kwai
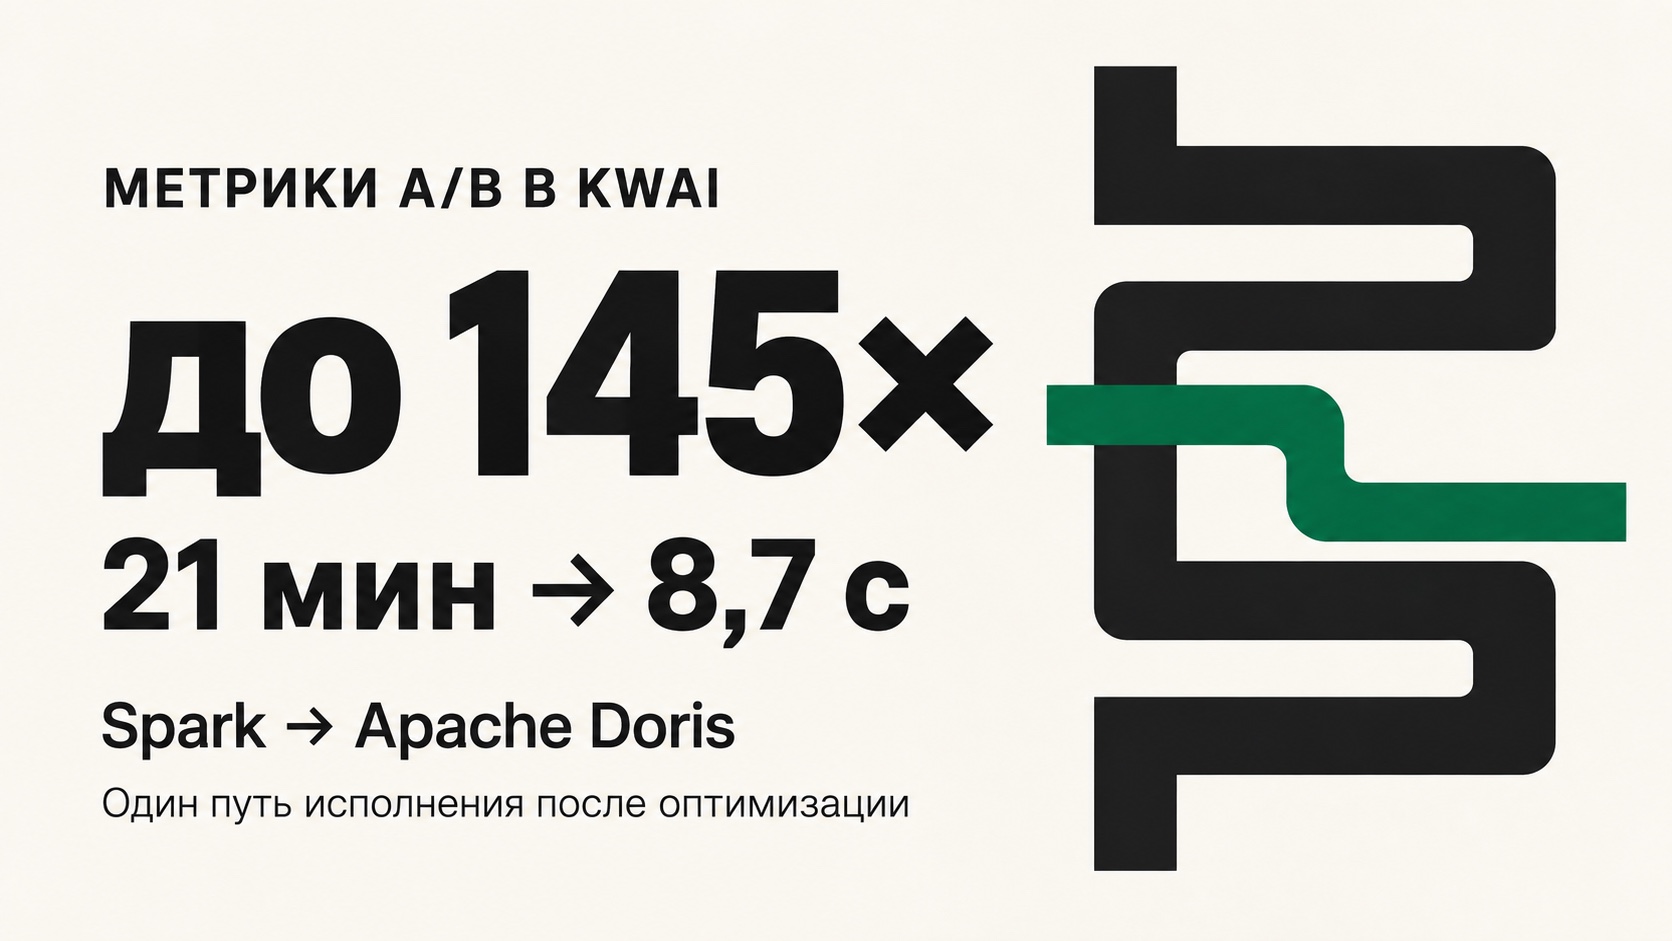
- One way to calculate A/B metrics has been reduced from 21 minutes to 8.7 seconds, an acceleration of about 145 times.
- The longest execution time was reduced from 65 to 2.12 minutes, by about 30 times.
- Resource consumption decreased by 72%.
- The described production cluster included 2,000 backend nodes and 100,000 computing units (CU).
These are the results of a specific Kwai pipeline after the system has been redesigned. They do not mean that any task after replacing Spark with Doris will automatically speed up 145 times.
How did you get the effect?
We have posted the data for the request. In A/B calculations, the tables were connected using the same key, the user ID. Consistent data distribution allowed connections to be made locally via Colocate Join and reduced data transfer between nodes.
Optimized repetitive calculations. The team has redesigned aggregations with counting of unique values and custom functions, reducing overhead in the most frequent operations.
We managed the load and operation. Isolation of computing groups, concurrency constraints, priority queues, and metadata management improvements helped to withstand the load of a large cluster.
What can be applied in your system
For me, the main conclusion is to start with a repetitive scenario.: how tables are joined, where data is moved, and which operations consume the most resources. A stable query template makes it possible to optimize the entire chain, from storage to scheduling.
To test on your infrastructure, you should take one typical calculation and compare execution time, resource consumption, and behavior under parallel load. For arbitrary analytical queries, the results must be checked separately. Some of the improvements described by Kwai also require checking availability in the selected version of Doris.
A complete analysis with diagrams, implementation details, and translator's notes: an article on Habré.
The source of the case is a publication by Siwei Zeng on the VeloDB blog; the translation into Habré was published with the permission of VeloDB.
Когда команда ждёт результаты A/B-теста до следующего утра, аналитическая инфраструктура начинает определять скорость продуктовых решений. В Kwai эту проблему решали переносом расчёта метрик со Spark на Apache Doris и глубокой оптимизацией вычислений.
На Хабре мы опубликовали перевод кейса Siwei Zeng, архитектора движков обработки данных в Kwai. Ниже — основные результаты и инженерные выводы, которые полезны командам, развивающим собственную аналитику.
Что получилось у Kwai
- Один путь расчёта A/B-метрик сократился с 21 минуты до 8,7 секунды — ускорение примерно в 145 раз.
- Самый длинный путь исполнения сократился с 65 до 2,12 минуты — примерно в 30 раз.
- Потребление ресурсов снизилось на 72%.
- Описанный production-кластер включал 2000 backend-узлов и 100 000 вычислительных единиц (CU).
Это результаты конкретного пайплайна Kwai после переработки системы. Они не означают, что любая задача после замены Spark на Doris автоматически ускорится в 145 раз.
За счёт чего получили эффект
Разместили данные под запрос. В A/B-расчётах таблицы соединялись по одному и тому же ключу — идентификатору пользователя. Согласованное распределение данных позволило выполнять соединения локально через Colocate Join и уменьшить передачу данных между узлами.
Оптимизировали повторяющиеся вычисления. Команда переработала агрегации с подсчётом уникальных значений и пользовательские функции, сократив накладные расходы в самых частых операциях.
Управляли нагрузкой и эксплуатацией. Изоляция вычислительных групп, ограничения параллелизма, очереди приоритетов и доработки управления метаданными помогли выдерживать нагрузку большого кластера.
Что можно применить в своей системе
Для меня главный вывод — начинать с повторяющегося сценария: как соединяются таблицы, где перемещаются данные и какие операции потребляют больше всего ресурсов. Стабильный шаблон запросов даёт возможность оптимизировать всю цепочку — от хранения до планирования.
Для проверки на своей инфраструктуре стоит взять один типовой расчёт и сравнить время выполнения, потребление ресурсов и поведение под параллельной нагрузкой. Для произвольных аналитических запросов результаты нужно проверять отдельно. Часть описанных доработок Kwai также требует проверки доступности в выбранной версии Doris.
Полный разбор со схемами, деталями реализации и примечаниями переводчика: статья на Хабре.
Источник кейса — публикация Siwei Zeng в блоге VeloDB; перевод на Хабре опубликован с разрешения VeloDB.




