



The post has been translated automatically. Original language: Russian





The thesis
A typical test checks one pre-selected example. The developer sets the input data and the expected result.
The problem is that there are always fewer examples than there are possible ways for the program to work.
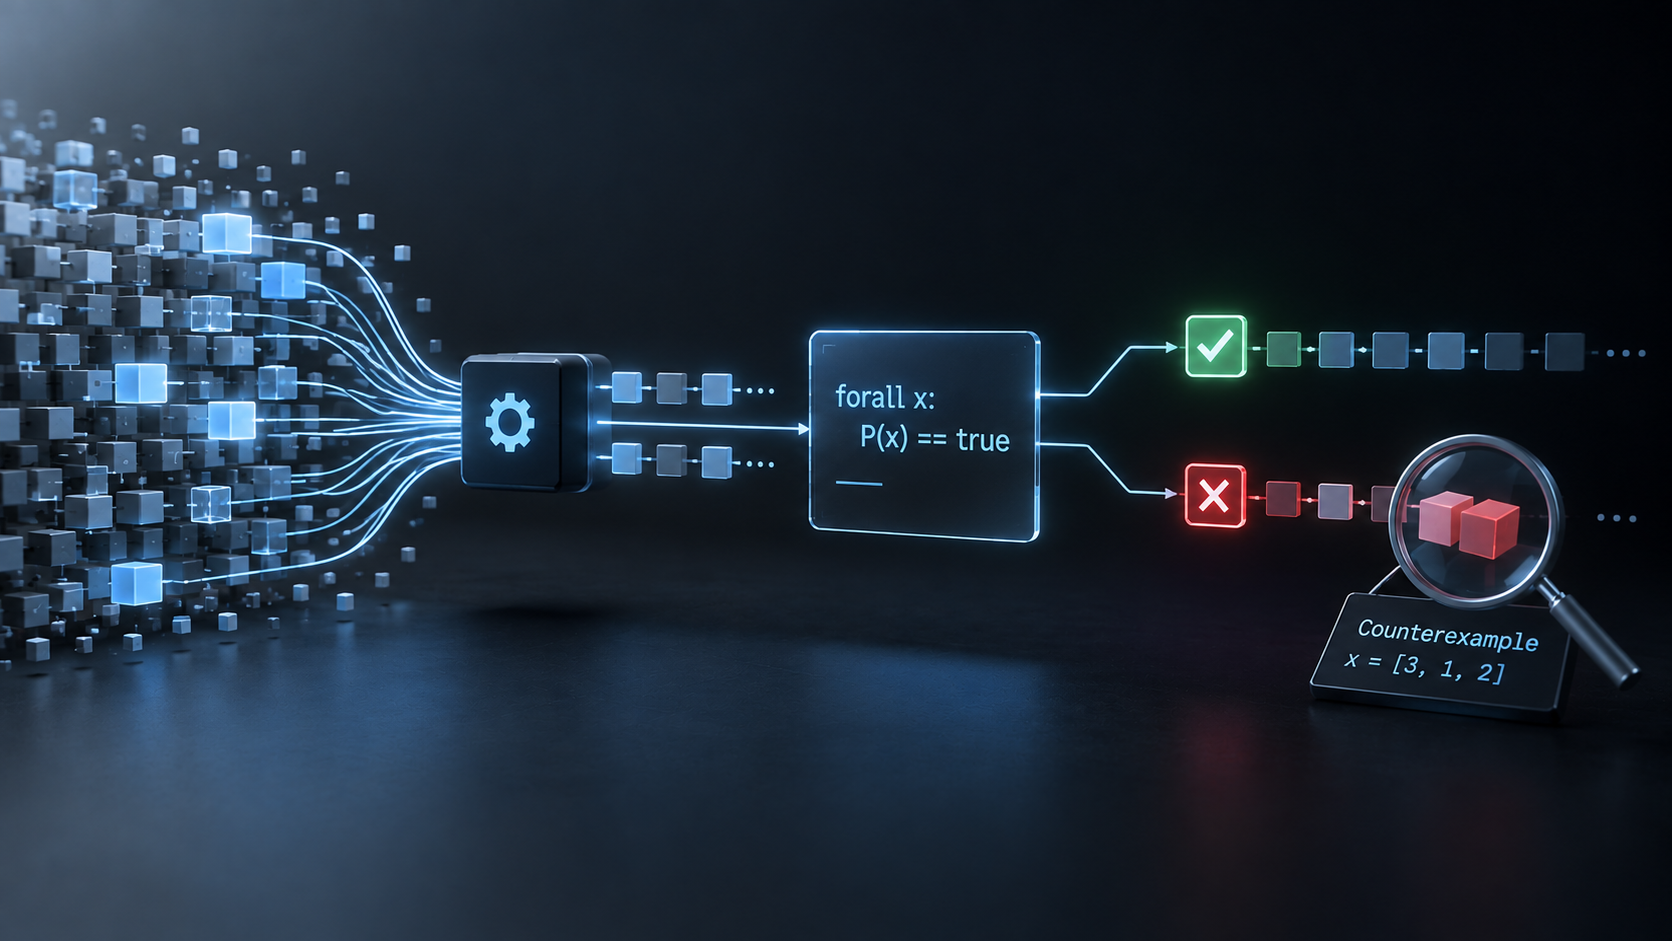
Another approach is to describe a common property of the program, and then automatically search for data in which this property is violated.
Review
Consider the sorting function.
A typical test can check multiple sets of numbers. For example, five numbers in random order, an already sorted set, and a set with the same values.
But sorting has more general properties.
After execution, the items should go in the correct order. The number of elements should not change. New values should not appear and the original ones should not disappear.
If these rules are set explicitly, the validation program can create multiple input sets by itself.
It runs a function on each set and checks the set properties.
If the rule is violated, the system tries to find a simpler example that leads to the same error. This makes it easier to find the cause.
This approach applies not only to mathematical functions. It is suitable for data transformation, protocols, financial calculations, data structures, and stateful programs.
Decision
The main change is that the developer stops listing all cases of interest to him.
Instead, he formulates a rule.
For example, when transferring money between two accounts, the total amount of funds should not change.
You can check multiple transfers manually. But you can formulate this condition once and automatically create different amounts, balances, and sequences of operations.
The check begins to look not for the expected result of one example, but for a violation of a common property.
This allows you to explore many more possible behaviors of the program.
Dignities
This approach is good at finding errors on the boundaries of acceptable values and in unusual combinations of input data.
It reduces dependence on the developer's ability to come up with all the important examples in advance.
One formulation of a property can replace a large number of similar tests.
Another advantage is that properties become explicit descriptions of program requirements. This makes the tests closer to the specification.
Disadvantages
The main difficulty does not disappear anywhere. The property must be formulated by a person.
If an important requirement is not described, the system will not check it.
An incorrectly formulated property can also create false confidence in the correctness of the program.
There is also a more fundamental limitation. Usually, a large but finite number of automatically created cases are checked.
If an error exists, but the system has not created the appropriate data, it will remain unnoticed.
Therefore, successfully passing such checks is still not proof of a property for all possible inputs.
Conclusion
Property-based testing takes an important step forward.
The object of verification is no longer a single example, but a general rule of program behavior.
However, the verification method remains the same. The program is executed on a set of selected data, after which a violation is searched.
The next question naturally arises: is it possible not only to create input data, but also to automatically examine the state of the system itself?
This is what model-based testing leads to.
Тезис
Обычный тест проверяет один заранее выбранный пример. Разработчик задаёт входные данные и ожидаемый результат.
Проблема в том, что примеров всегда меньше, чем возможных вариантов работы программы.
Другой подход состоит в том, чтобы описать общее свойство программы, а затем автоматически искать данные, при которых это свойство нарушается.
Обзор
Рассмотрим функцию сортировки.
Обычный тест может проверить несколько наборов чисел. Например, пять чисел в случайном порядке, уже отсортированный набор и набор с одинаковыми значениями.
Но у сортировки есть более общие свойства.
После выполнения элементы должны идти в правильном порядке. Количество элементов не должно меняться. Не должны появляться новые значения и исчезать исходные.
Если эти правила заданы явно, программа проверки может сама создавать множество входных наборов.
Она запускает функцию на каждом наборе и проверяет заданные свойства.
Если правило нарушено, система пытается найти более простой пример, который приводит к той же ошибке. Это облегчает поиск причины.
Такой подход применяется не только к математическим функциям. Он подходит для преобразования данных, протоколов, финансовых расчётов, структур данных и программ с состоянием.
Решение
Основное изменение состоит в том, что разработчик перестаёт перечислять все интересующие его случаи.
Вместо этого он формулирует правило.
Например, при переводе денег между двумя счетами общая сумма средств не должна измениться.
Можно проверить несколько переводов вручную. Но можно сформулировать это условие один раз и автоматически создавать разные суммы, остатки и последовательности операций.
Проверка начинает искать не ожидаемый результат одного примера, а нарушение общего свойства.
Это позволяет исследовать гораздо больше вариантов поведения программы.
Достоинства
Такой подход хорошо находит ошибки на границах допустимых значений и в необычных сочетаниях входных данных.
Он уменьшает зависимость от способности разработчика заранее придумать все важные примеры.
Одна формулировка свойства может заменить большое число однотипных тестов.
Ещё одно преимущество состоит в том, что свойства становятся явным описанием требований к программе. Это делает тесты ближе к спецификации.
Недостатки
Главная сложность никуда не исчезает. Свойство должен сформулировать человек.
Если важное требование не описано, система его не проверит.
Неверно сформулированное свойство также может создать ложную уверенность в корректности программы.
Есть и более фундаментальное ограничение. Обычно проверяется большое, но конечное количество автоматически созданных случаев.
Если ошибка существует, но система не создала подходящие данные, она останется незамеченной.
Поэтому успешное прохождение таких проверок всё ещё не является доказательством свойства для всех возможных входных данных.
Вывод
Тестирование на основе свойств делает важный шаг вперёд.
Объектом проверки становится уже не отдельный пример, а общее правило поведения программы.
Однако способ проверки остаётся прежним. Программа выполняется на множестве выбранных данных, после чего ищется нарушение.
Следующий вопрос возникает естественно: можно ли не только создавать входные данные, но и автоматически исследовать состояния самой системы?
К этому ведёт тестирование на основе модели.

 Share








