



The post has been translated automatically. Original language: Russian




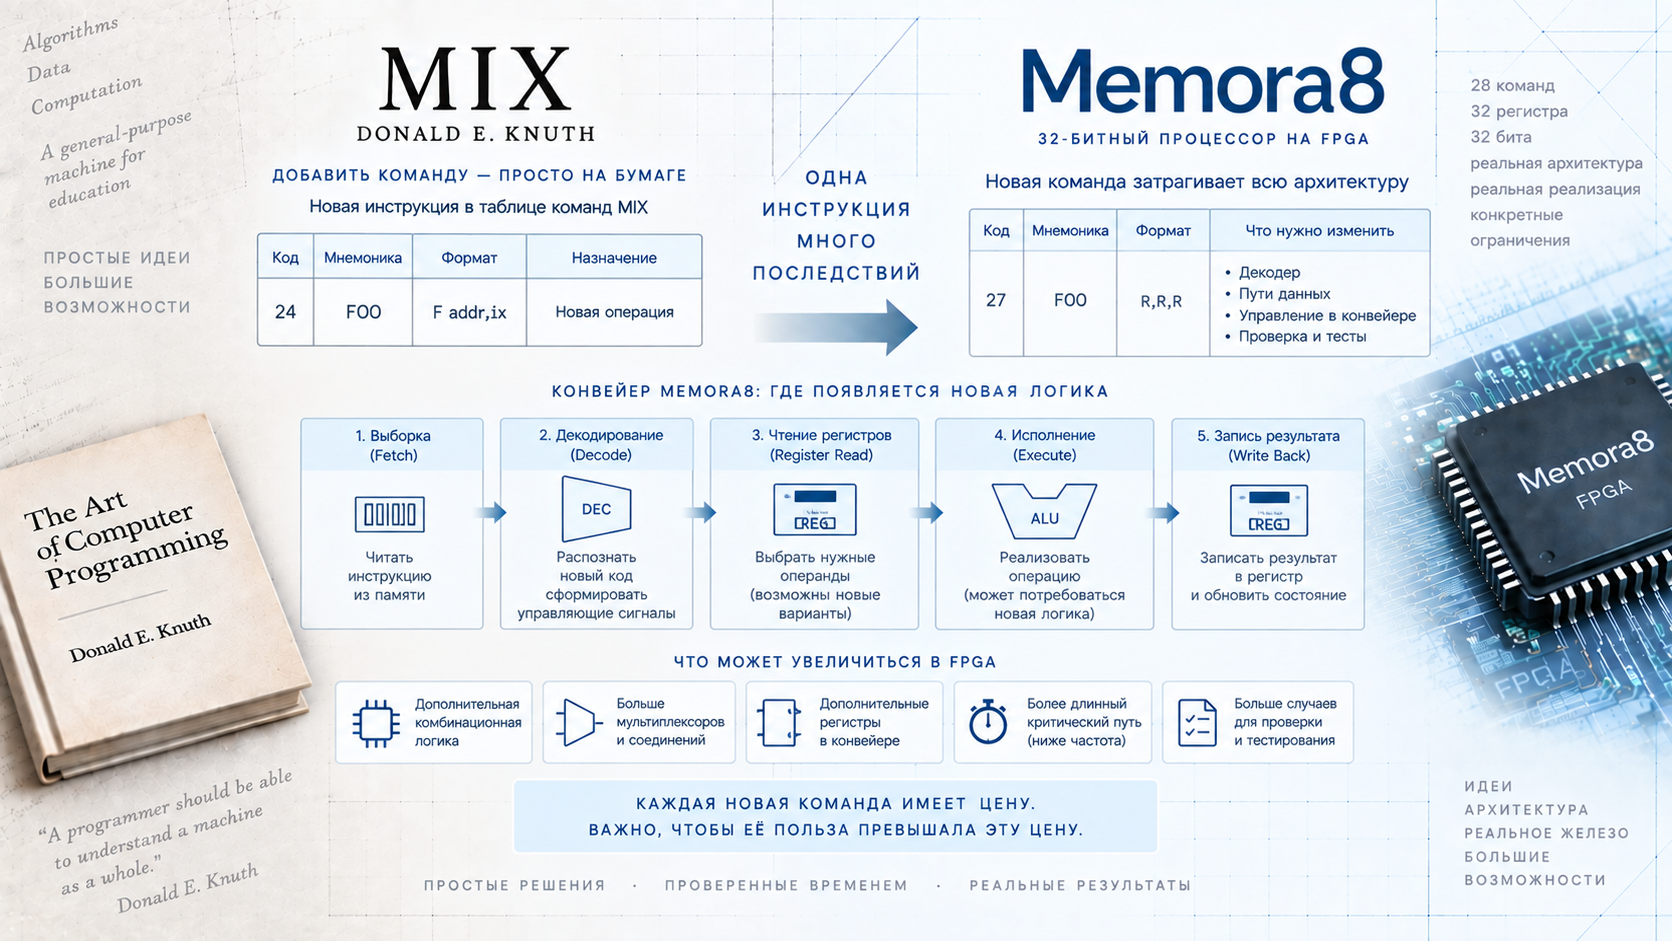
On paper, it's pretty easy to add a new command to the processor. You need to select a free opcode, describe the operands, and determine the result. Another row appears in the command system table, and the architecture seems a little more convenient.
After switching to real hardware, this line ceases to be an abstraction.
You need to recognize the command, get the data for it, run it through the necessary processor nodes, calculate the result, and correctly change the architectural state. If an operation doesn't fit into an existing path, you have to add new logic for it.
That is why when designing Memora8, the question is not only "is this command useful to a programmer?". It is equally important to understand how many new rules it will bring to the processor itself.
MIX had almost no such task.
Donald Knuth created MIX as an abstract computing machine for studying algorithms. The architecture had to be consistent, understandable, and rich enough to describe a wide variety of programs.
Of course, MIX can be implemented physically. Such implementations exist in both software and hardware. But the initial choice of commands was not determined by how many logic gates a particular chip would need.
Knuth could evaluate architecture primarily from the point of view of its expressiveness.
Memora8 has an additional limitation: the processor must turn into a working FPGA circuit.
Here, the architectural solution gets physical expression almost immediately.
First you need to recognize the command.
In Memora8, each instruction has a fixed length of 32 bits. The operation code takes up five bits, after which the remaining fields are interpreted according to the command format.
As long as the new operation uses an existing format, the situation is quite simple. The decoder receives another code value and generates the already familiar control signals.
But a new command may require a different set of operands or a new behavior.
Then the change begins to spread further.
It is necessary to determine which registers to read, whether a direct value is required, whether an instruction should access memory, what to transfer to the execution stage, and where to write the result at the end.
Therefore, the cost of a command is determined by more than one additional condition in the decoder.
It is important how well it fits into the existing processor structure.
The cheapest team uses what is already there.
Let's imagine a new arithmetic operation that receives two ordinary registers and writes a 32-bit result to the third one.
If the computing unit is already able to perform the necessary action without changing the data path, such a command may be relatively inexpensive.
The operands are read in the same way. They run along existing lines. The result goes where the results of other arithmetic operations go.
A new action is added, but the processor device hardly changes.
A team that needs an additional data source or a result with an unusual width looks very different.
In this case, the existing path may not be enough. There are new signal selection options, additional connections, and intermediate values.
One row in the command table begins to change not only the computing unit.
Special cases generate choices
In a digital scheme, data constantly has to choose between several sources.
What value should I pass to the arithmetic block? What should I put in the register? Where can I get a new address? What result should move to the next stage?
For this purpose, multiplexers are used — schemes for selecting one input from several.
If a new instruction requires a new option, such a choice may become wider.
One additional entrance in itself seems like a small thing. However, such changes may appear in several places of the processor at once.
In addition, the extended selection increases the signal path. In an FPGA, this matters because the processor must be able to do all the necessary work between the two clock edges.
Therefore, the cost of an instruction is expressed not only by the number of occupied logic gates.
It can also manifest itself in the maximum operating frequency.
In the pipeline, the command exists in several places at once
Memora8 uses a five-stage pipeline.
The instruction goes through sampling, register reading, memory operation, execution, and the final result fixation stage.
If the new team requires additional information, this information must be passed through the necessary stages.
Let's say that the register numbers and the values of the two operands are sufficient for the usual addition. But the new instruction introduces a special mode that will only be needed closer to completion.
This mode cannot be forgotten after decoding. It has to be stored and transferred along with the team further along the pipeline.
This creates additional bits in the registers between the stages and new conditions in the control logic.
The more exceptions an instruction system has, the more differences the processor has to carry through the entire execution path.
Working with memory is particularly sensitive to complexity
Memora8 already has byte, half-word, and full 32-bit word read and write operations.
These options are justified by the fact that they are constantly used by programs and are directly related to the physical access to data.
But it would be possible to add significantly more complex memory commands.
For example, the command could simultaneously calculate the address using several registers, change the base pointer, or perform additional processing of the loaded value.
For a program, this would sometimes reduce several actions to a single instruction.
For the processor, the address calculation path would have to be expanded, new sources of operands added, and additional state changes taken into account.
And all this for the sake of an operation that can already be obtained by a combination of existing commands.
It is in such places that it is especially useful to ask a question about the price of convenience.
Transitions also affect more than they seem.
The conditional jump command looks very simple: check the condition and, if necessary, set a new execution address.
But in a pipelined processor, by this point, the following instructions may already be inside the pipeline.
If the transfer is accepted, they must be canceled.
Therefore, any new type of flow control must properly interact with the execution redirection mechanism.
Memora8 is limited to simple BNZ and BEQZ, and more complex conditions are generated in advance by conventional computing commands.
As a result, the transition circuit is responsible only for checking the zero or non-zero value and changing the direction of execution.
If each type of comparison had its own transition, the program would sometimes be shorter. But there would be more options inside the flow control mechanism.
The check also has a price.
It is not enough to run the hardware processor successfully once.
You need to make sure that each instruction works correctly with different values of the operands, in combination with the previous and next instructions, during transitions, dependencies, and memory accesses.
Each new feature increases the number of situations that need to be checked.
It's not the new operations themselves that are particularly expensive, but the exceptions.
If the command follows the same rules as the rest of the instructions in its group, a significant part of the already tested logic continues to work unchanged.
If it has a special format, a different operand source, a separate rule for writing the result, and exceptional behavior in the pipeline, you have to check much more.
Therefore, a regular architecture is useful not only for saving FPGAs.
It reduces the space of possible errors.
A small number of commands does not guarantee anything.
You can create a processor with only a few dozen instructions and still get a complex implementation.
If each command is designed in a completely different way, the number of opcodes remains small, but the number of internal rules is growing.
Conversely, a relatively large set can be implemented fairly regularly if many teams use the same formats and common data paths.
Therefore, not only the 28 active teams are important for Memora8.
More importantly, they are divided into several understandable groups and try to use common mechanisms.
Arithmetic and logical operations work with the same set of registers. Operations with an immediate value use a similar format. Memory access is built around a base register and an offset. Transitions check the usual values.
It is not the program code that repeats, but the hardware device.
Sometimes two teams are really cheaper than one
It is natural for a programmer to count the number of instructions.
If one task can be completed by one team instead of two, it seems like an obvious improvement.
But from the processor designer's point of view, it's not just the length of the sequence that needs to be compared.
Let's say two existing teams fully utilize off-the-shelf hardware mechanisms. The new combined instruction reduces the program by one step, but requires an additional computing unit mode and a new data path.
Then the program wins, but each processor instance becomes more complicated.
This exchange is especially noticeable in FPGAs, where logic is not a free abstraction. It takes up real resources and is connected by real lines.
Therefore, sometimes it is more correct to perform two simple steps sequentially.
Simplicity must be synthesized
This is the essential difference between MIX and Memora8.
For MIX, it is enough that the architectural solution is logical and suitable for describing algorithms.
Memora8 has another test added to this: how well it turns into real hardware.
After describing the processor, the development tools must synthesize a logical circuit, place it inside the FPGA and connect the elements so that the signals can pass in the allotted time.
At this stage, architecture ceases to be just a system of ideas.
It becomes clear which solutions create long connections, where the number of choices increases, and which mechanisms turn out to be too complex for the required frequency.
This is how the feedback from the implementation begins to affect the architecture.
The team must justify its existence
This does not mean that any additional instruction should be considered undesirable.
If the operation occurs constantly, significantly reduces programs, or allows the hardware to perform the work significantly more efficiently, a separate team may be fully justified.
The only question is whether the gain really exceeds the cost.
For Memora8, the architecture turned out to be reasonable, where most actions are built from a small set of common mechanisms.
This makes some sequences longer, but reduces the number of exceptions within the processor itself.
And here again, the difference from MIX is evident.
Knuth could allow instructions to be expressive if it made the abstract machine more convenient for algorithms.
Memora8 has to ask an additional question: what happens to the actual schema after adding this feature?
That is why, when designing a processor, it is useful to look at a command not as an assembler string.
Behind it are the decoder, registers, computing units, data lines, control logic and checks.
Every instruction has a price.
In FPGA, this price can literally be seen after synthesis.
На бумаге добавить процессору новую команду довольно просто. Нужно выбрать свободный код операции, описать операнды и определить результат. В таблице системы команд появляется ещё одна строка, и архитектура кажется немного удобнее.
После перехода к реальной аппаратуре эта строка перестаёт быть абстракцией.
Команду нужно распознать, получить для неё данные, провести их через нужные узлы процессора, вычислить результат и правильно изменить архитектурное состояние. Если операция не укладывается в уже существующий путь, ради неё приходится добавлять новую логику.
Именно поэтому при проектировании Memora8 вопрос звучит не только как «полезна ли эта команда программисту?». Не менее важно понять, сколько новых правил она принесёт в сам процессор.
У MIX такой задачи практически не было
Дональд Кнут создавал MIX как абстрактную вычислительную машину для изучения алгоритмов. Архитектура должна была быть последовательной, понятной и достаточно богатой, чтобы на ней можно было описывать самые разные программы.
Конечно, MIX можно реализовать физически. Такие реализации существуют и в программном, и в аппаратном виде. Но первоначальный выбор команд не определялся тем, сколько логических элементов потребуется конкретной микросхеме.
Кнут мог оценивать архитектуру прежде всего с точки зрения её выразительности.
У Memora8 появляется дополнительное ограничение: процессор должен превратиться в работающую схему FPGA.
Здесь архитектурное решение почти сразу получает физическое выражение.
Сначала команду нужно распознать
В Memora8 каждая инструкция имеет фиксированную длину 32 бита. Код операции занимает пять бит, после чего остальные поля интерпретируются в соответствии с форматом команды.
Пока новая операция использует уже существующий формат, положение достаточно простое. Декодер получает ещё одно значение кода и формирует уже знакомые управляющие сигналы.
Но новая команда может потребовать другого набора операндов или нового поведения.
Тогда изменение начинает распространяться дальше.
Нужно определить, какие регистры читать, требуется ли непосредственное значение, должна ли инструкция обращаться к памяти, что передавать на стадию исполнения и куда в конце записывать результат.
Поэтому стоимость команды определяется не одним дополнительным условием в декодере.
Важно, насколько хорошо она вписывается в уже существующую структуру процессора.
Самая дешёвая команда использует то, что уже есть
Представим новую арифметическую операцию, которая получает два обычных регистра и записывает 32-битный результат в третий.
Если вычислительный блок уже способен выполнить нужное действие без изменения тракта данных, такая команда может оказаться относительно недорогой.
Операнды читаются тем же способом. Они проходят по существующим линиям. Результат приходит туда же, куда приходят результаты других арифметических операций.
Добавляется новое действие, но устройство процессора почти не меняется.
Совсем иначе выглядит команда, которой нужен дополнительный источник данных или результат необычной ширины.
В этом случае существующего пути может не хватить. Появляются новые варианты выбора сигналов, дополнительные соединения и промежуточные значения.
Одна строка в таблице команд начинает менять уже не только вычислительный блок.
Особые случаи порождают выбор
В цифровой схеме данные постоянно приходится выбирать между несколькими источниками.
Какое значение передать в арифметический блок? Что записать в регистр? Откуда взять новый адрес? Какой результат должен перейти на следующую стадию?
Для этого используются мультиплексоры — схемы выбора одного входа из нескольких.
Если новая инструкция требует нового варианта, такой выбор может стать шире.
Один дополнительный вход сам по себе кажется мелочью. Но подобные изменения могут появиться сразу в нескольких местах процессора.
Кроме того, расширенный выбор увеличивает путь прохождения сигнала. В FPGA это имеет значение, потому что процессор должен успеть выполнить всю необходимую работу между двумя тактовыми фронтами.
Поэтому стоимость инструкции выражается не только количеством занятых логических элементов.
Она может проявиться и в максимальной рабочей частоте.
В конвейере команда существует сразу в нескольких местах
Memora8 использует пятистадийный конвейер.
Инструкция проходит выборку, чтение регистров, работу с памятью, исполнение и стадию окончательной фиксации результата.
Если новая команда требует дополнительной информации, эту информацию нужно провести через необходимые стадии.
Допустим, для обычного сложения достаточно номеров регистров и значений двух операндов. Но новая инструкция вводит особый режим, который понадобится только ближе к завершению.
Этот режим нельзя забыть после декодирования. Его приходится хранить и передавать вместе с командой дальше по конвейеру.
Так появляются дополнительные биты в регистрах между стадиями и новые условия в управляющей логике.
Чем больше исключений имеет система команд, тем больше различий процессору приходится переносить через весь путь выполнения.
Работа с памятью особенно чувствительна к усложнению
У Memora8 уже существуют операции чтения и записи байта, половины слова и полного 32-битного слова.
Эти варианты оправданы тем, что они постоянно используются программами и напрямую связаны с физическим обращением к данным.
Но можно было бы добавить значительно более сложные команды памяти.
Например, команда могла бы одновременно вычислять адрес по нескольким регистрам, изменять базовый указатель или выполнять дополнительную обработку загруженного значения.
Для программы это иногда позволило бы сократить несколько действий до одной инструкции.
Для процессора пришлось бы расширять тракт вычисления адреса, добавлять новые источники операндов и учитывать дополнительное изменение состояния.
И всё это ради операции, которую уже можно получить комбинацией существующих команд.
Именно в таких местах особенно полезно задавать вопрос о цене удобства.
Переходы тоже затрагивают больше, чем кажется
Команда условного перехода выглядит очень простой: проверить условие и при необходимости установить новый адрес выполнения.
Но в конвейерном процессоре к этому моменту следующие инструкции уже могут находиться внутри конвейера.
Если переход принят, их необходимо отменить.
Поэтому любая новая разновидность управления потоком должна правильно взаимодействовать с механизмом перенаправления исполнения.
Memora8 ограничивается простыми BNZ и BEQZ, а более сложные условия формируются заранее обычными вычислительными командами.
В результате схема перехода отвечает только за проверку нулевого или ненулевого значения и изменение направления исполнения.
Если бы для каждого типа сравнения существовал собственный переход, программа иногда была бы короче. Но количество вариантов внутри механизма управления потоком стало бы больше.
Цена есть и у проверки
Аппаратный процессор недостаточно один раз успешно запустить.
Нужно убедиться, что каждая команда работает правильно при разных значениях операндов, в сочетании с предыдущими и следующими инструкциями, при переходах, зависимостях и обращениях к памяти.
Каждая новая особенность увеличивает число ситуаций, которые необходимо проверить.
Особенно дороги не сами новые операции, а исключения.
Если команда подчиняется тем же правилам, что и остальные инструкции её группы, значительная часть уже проверенной логики продолжает работать без изменений.
Если у неё особый формат, другой источник операнда, отдельное правило записи результата и исключительное поведение в конвейере, проверять приходится значительно больше.
Поэтому регулярная архитектура полезна не только для экономии FPGA.
Она уменьшает пространство возможных ошибок.
Малое число команд ещё ничего не гарантирует
Можно создать процессор всего с несколькими десятками инструкций и всё равно получить сложную реализацию.
Если каждая команда устроена совершенно по-своему, количество кодов операций остаётся небольшим, но число внутренних правил растёт.
И наоборот, сравнительно большой набор может реализовываться достаточно регулярно, если многие команды используют одинаковые форматы и общие пути данных.
Поэтому для Memora8 важны не только 28 действующих команд.
Гораздо важнее то, что они разбиты на несколько понятных групп и стараются использовать общие механизмы.
Арифметические и логические операции работают с тем же набором регистров. Операции с непосредственным значением используют сходный формат. Доступ к памяти строится вокруг базового регистра и смещения. Переходы проверяют обычные значения.
Повторяется не код программы, а устройство аппаратуры.
Иногда две команды действительно дешевле одной
Для программиста естественно считать количество инструкций.
Если одну задачу можно выполнить одной командой вместо двух, это кажется очевидным улучшением.
Но с точки зрения проектировщика процессора сравнивать нужно не только длину последовательности.
Допустим, две уже существующие команды полностью используют готовые аппаратные механизмы. Новая объединённая инструкция сокращает программу на один шаг, но требует дополнительного режима вычислительного блока и нового пути данных.
Тогда выигрывает программа, но усложняется каждый экземпляр процессора.
Этот обмен особенно заметен в FPGA, где логика не является бесплатной абстракцией. Она занимает реальные ресурсы и соединяется реальными линиями.
Поэтому иногда правильнее выполнить два простых действия последовательно.
Простота должна проходить синтез
В этом состоит существенное различие между MIX и Memora8.
Для MIX достаточно, чтобы архитектурное решение было логичным и пригодным для описания алгоритмов.
У Memora8 к этому добавляется ещё одна проверка: насколько хорошо оно превращается в реальное железо.
После описания процессора средства разработки должны синтезировать логическую схему, разместить её внутри FPGA и соединить элементы так, чтобы сигналы успевали пройти за отведённое время.
На этом этапе архитектура перестаёт быть только системой идей.
Становится видно, какие решения создают длинные связи, где увеличивается число вариантов выбора и какие механизмы оказываются слишком сложными для требуемой частоты.
Так обратная связь от реализации начинает влиять на архитектуру.
Команда должна оправдать своё существование
Это не означает, что любую дополнительную инструкцию следует считать нежелательной.
Если операция встречается постоянно, заметно сокращает программы или позволяет аппаратуре выполнить работу существенно эффективнее, отдельная команда может быть полностью оправдана.
Вопрос только в том, действительно ли выигрыш превышает стоимость.
Для Memora8 разумной оказалась архитектура, где большинство действий строится из небольшого набора общих механизмов.
Это делает некоторые последовательности длиннее, но уменьшает количество исключений внутри самого процессора.
И здесь снова проявляется отличие от MIX.
Кнут мог позволить инструкции быть выразительной, если это делало удобнее абстрактную машину для алгоритмов.
Memora8 приходится задавать дополнительный вопрос: что произойдёт с реальной схемой после добавления этой возможности?
Именно поэтому при проектировании процессора полезно смотреть на команду не как на строку ассемблера.
За ней стоят декодер, регистры, вычислительные блоки, линии данных, логика управления и проверки.
У каждой инструкции есть цена.
В FPGA эту цену можно буквально увидеть после синтеза.

 Share








