

The post has been translated automatically. Original language: Russian




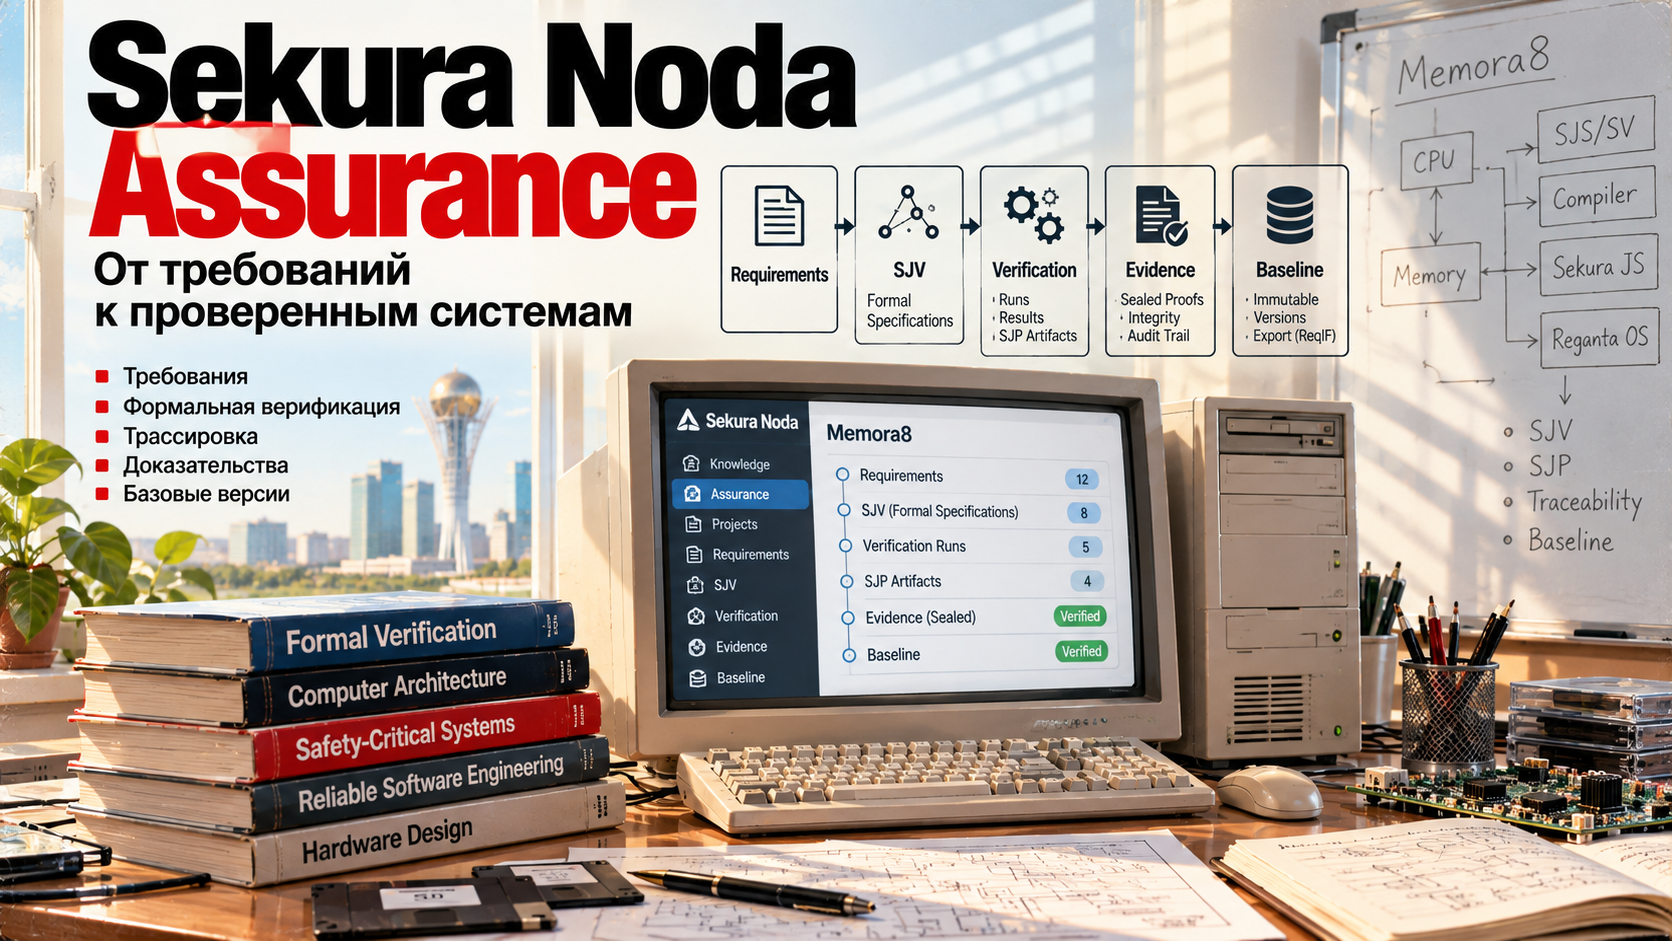
We are starting work on a new Sekura Noda — Assurance subject layer.
So far, the main task of Noda has been related to knowledge: to capture important statements, decisions, accumulated experience and provide AI with a guided context for working with them.
But when developing computing systems, this is not enough.
Especially when it comes to processors, compilers, operating systems, industrial software, or systems that may affect the safety of equipment and technological processes.
In such systems, it is not enough to say:
We know how it should work.
You need to be able to answer other questions.:
What exactly do we claim about the system?
Where is this property formally described?
Which version of the implementation was it tested for?
How was the verification performed?
What result was obtained?
Where is the evidence artifact?
Has what we checked changed since then?
It is for this task that the Assurance layer is created.
From knowledge to evidence base
We consciously separate two different subject spaces within Noda.
The first is knowledge.
Here you can find explanations, approaches, engineering solutions, accumulated experience, and statements that a person or AI uses in their work.
The second is Assurance.
This is not just knowledge, but a formal engineering chain.:
statement → formal description → implementation → verification → proof → fixed state of the system.
Assurance is not a new kind of Noda canon.
It will have its own entities, versioning rules, tracing, immutable proofs, and snapshots of the project status.
At the same time, Assurance becomes part of Noda infrastructure and will use the existing connection of AI agents via MCP.
The user does not need a separate program or a special interface. The work will take place through an AI agent.
How it should work
Let's take a simplified example.
Let's say there is a multi-step data transfer operation in the processor.
We want to guarantee the following property:
After the transfer has started, the selected memory page should not be changed until the operation is completed.
In Assurance, the engineering requirement appears first.
For example:
SAF-FDRW-0017
The destination page selected by the START command must remain unchanged until the END.
The next level is the formal description of this property.
In our case, the SJV format is being developed for this.
SJV should describe not just an example of proper operation, but a verifiable property of the system.
Conditional:
after START(P), any subsequent transfer element before the END should relate only to page P.
Next, Assurance links this description to the exact version of the implementation.:
- the repository;
- commit;
- a specific module;
- if necessary, a separate symbol or section of the implementation.
After that, a formal verification is performed.
The result is a separate verification run with strictly fixed input data.:
- SJV version;
- implementation version;
- version of the verification tool;
- settings;
- result.
If the verification creates an evidentiary artifact, it is saved as an SJP.
Thus, a chain appears:
requirement → SJV → specific implementation → test start → SJP.
But that's not enough.
It is necessary to fix the origin and integrity of the result.
Therefore, Assurance creates a separate evidence record containing the checksum of the artifact, information about the launch, the implementation used, and the approval being verified.
After that, the proof can be sealed.
The sealed record is no longer changed. Re-checking creates a new result, rather than overwriting the old one.
Why is it not enough to just store files?
It would be possible to put several files in Git:
fdrw.sv
fdrw.sjv
fdrw.sjp
and consider the problem solved.
But after six months, questions will arise.
What requirement does this SJV check?
Which commit was this SJP created for?
What assumptions were used during the proof?
Has the implementation changed after verification?
Are there any requirements for which there is no formal description at all?
Are there any formal descriptions that have never been successfully verified yet?
Is there any evidence related to the old version of the implementation?
The file system does not answer these questions.
Assurance should store links between engineering facilities and calculate the state of the evidence base.
The proof may also be outdated.
One of the important ideas of Assurance is that a successful proof never becomes false in hindsight.
If a property has been successfully verified for a specific implementation version, this historical fact remains.
However, after changing the implementation, this proof cannot be automatically migrated to the new version.
Therefore, Assurance distinguishes between a historical result and its relevance.
If a formal verification has been performed for commit A, and the current version of the implementation is already in commit B, the old proof gets a state.:
outdated for the current context.
The result itself is saved.
This avoids the dangerous situation when there is a PASS mark in the system, but it is no longer possible to understand which implementation it referred to.
Why do I need a baseline?
As the project evolves, individual requirements, SJV descriptions, implementations, and proofs are constantly changing.
Therefore, Assurance introduces another important concept — baseline, that is, an immutable snapshot of the evidence base at a certain moment.
For example:
Memora8 Memory 0.8
Such a snapshot can fix:
- versions of requirements;
- architectural solutions;
- SJV;
- exact implementation versions;
- completed checks;
- SJP;
- sealed evidence;
- connections between all these objects.
A checksum is calculated for the baseline itself.
It does not change after creation.
The next version of the system gets a new baseline.
This allows you to answer the question after a while.:
What exactly confirmed the properties of Memora8 version 0.8?
And get not a set of random files, but a reproducible proof chain.
Assurance and formal verification
The first real testing ground for the new layer will be the development of Memora8 and the associated stack.
We are gradually building our own formal verification process: from a formal description of properties to machine proof artifacts.
However, Assurance will not perform formal verification itself.
The verification is performed by external tools.
Assurance's task is different — to keep the exact context of verification and link the result to the entire engineering system.
In fact, this is a division of responsibility.:
SJV defines what is being checked.
The verification tool performs verification.
SJP contains the result of an evidentiary procedure.
Assurance records what this result refers to and whether it can be considered relevant.
Not just formal proofs
Although formal verification will be the first scenario, the model itself is broader.
The same chain may include:
- the usual tests;
- simulation;
- static analysis;
- coverage analysis;
- checking the architecture;
- build results;
- Inspections;
- security analysis;
- the results of certification tests.
In other words, Assurance can gradually become the general evidence base of an engineering project.
For each statement, you will be able to see not only its text, but also how it is confirmed.
Why is this becoming part of Noda
Initially, we considered Assurance as a separate application.
But a significant part of the necessary infrastructure already exists in Noda.:
- MCP for interaction with AI agents;
- authentication;
- access rights;
- Cloudflare Workers;
- D1;
- R2;
- audit;
- working with versions.
Therefore, it was decided to develop Assurance as a separate subject layer within Noda.
At the same time, Knowledge and Assurance do not mix.
Knowledge does not automatically become proof.
And having a proof does not make it a canon of Noda.
These are two independent spaces that use the same platform.
Working through an AI agent
A separate user interface for Assurance is not planned at the first stage.
The main client remains the AI agent.
For example, a developer can say:
We have changed the FD-R/W protocol. Fix the new architecture and show what evidence needs to be done again.
The agent will be able to:
- find affected requirements;
- identify related SJVS;
- identify evidence related to the old implementation;
- show missing checks;
- register a new verification launch;
- save the received SJP;
- create a new baseline.
Thus, AI is used not as a source of truth, but as an operator of a strictly structured engineering system.
The specific versions of objects, connections, checksums, and test results remain true.
What do we want to achieve
The end goal looks something like this.
For each significant property of the system, you can go through a chain:
What is being claimed?
↓
Where is this formally described?
↓
In which implementation is this present?
↓
How was it tested?
↓
What evidence-based artifact was obtained?
↓
Does it apply to the current version?
↓
In which baseline was it fixed?
If this chain is reproduced by a machine, the engineering documentation ceases to be a collection of disparate texts and files.
It becomes the evidence-based structure of the project.
This is exactly the structure we want to get at Sekura Noda Assurance.
At the first stage, work will be carried out on real Memora8 tasks: requirements, SJV descriptions, implementation versions, formal verification launches, SJP artifacts, evidence and baseline.
The next practical question for us is not "how to write another document about the system", but:
Can we show a specific, reproducible proof for each important statement?
It is around this issue that the development of Assurance begins.
Мы начинаем работу над новым предметным слоем Sekura Noda — Assurance.
До сих пор основная задача Noda была связана со знаниями: зафиксировать важные утверждения, решения, накопленный опыт и предоставить ИИ управляемый контекст для работы с ними.
Но при разработке вычислительных систем этого недостаточно.
Особенно если речь идёт о процессорах, компиляторах, операционных системах, промышленном программном обеспечении или системах, от работы которых может зависеть безопасность оборудования и технологических процессов.
В таких системах недостаточно сказать:
Мы знаем, как это должно работать.
Нужно уметь ответить на другие вопросы:
Что именно мы утверждаем о системе?
Где это свойство формально описано?
Для какой версии реализации оно проверялось?
Каким способом была выполнена проверка?
Какой результат получен?
Где находится доказательный артефакт?
Не изменилось ли с тех пор то, что мы проверяли?
Именно для этой задачи создаётся слой Assurance.
От знаний к доказательной базе
Мы сознательно разделяем внутри Noda два разных предметных пространства.
Первое — знания.
Здесь находятся объяснения, подходы, инженерные решения, накопленный опыт и утверждения, которыми человек или ИИ пользуется в работе.
Второе — Assurance.
Здесь находятся уже не просто знания, а формальная инженерная цепочка:
утверждение → формальное описание → реализация → проверка → доказательство → зафиксированное состояние системы.
Assurance не является новым видом канона Noda.
У него будут собственные сущности, правила версионирования, трассировка, неизменяемые доказательства и снимки состояния проекта.
При этом инфраструктурно Assurance становится частью Noda и будет использовать существующее подключение ИИ-агентов через MCP.
Пользователю не потребуется отдельная программа или специальный интерфейс. Работа будет происходить через ИИ-агента.
Как это должно работать
Рассмотрим упрощённый пример.
Допустим, в процессоре есть многотактовая операция передачи данных.
Мы хотим гарантировать следующее свойство:
после начала передачи выбранная страница памяти не должна изменяться до завершения операции.
В Assurance сначала появляется инженерное требование.
Например:
SAF-FDRW-0017
Страница назначения, выбранная командой START, должна оставаться неизменной до END.
Следующий уровень — формальное описание этого свойства.
В нашем случае для этого развивается формат SJV.
SJV должен описывать не просто пример правильной работы, а проверяемое свойство системы.
Условно:
после START(P) любой последующий элемент передачи до END должен относиться только к странице P.
Далее Assurance связывает это описание с точной версией реализации:
- репозиторий;
- commit;
- конкретный модуль;
- при необходимости — отдельный символ или участок реализации.
После этого выполняется формальная проверка.
Результатом становится отдельный запуск проверки со строго зафиксированными входными данными:
- версия SJV;
- версия реализации;
- версия средства проверки;
- настройки;
- результат.
Если проверка создаёт доказательный артефакт, он сохраняется как SJP.
Таким образом появляется цепочка:
требование → SJV → конкретная реализация → запуск проверки → SJP.
Но и этого недостаточно.
Нужно зафиксировать происхождение и целостность результата.
Поэтому Assurance создаёт отдельную запись evidence, содержащую контрольную сумму артефакта, сведения о запуске, используемой реализации и проверяемом утверждении.
После этого доказательство можно запечатать.
Запечатанная запись уже не изменяется. Повторная проверка создаёт новый результат, а не переписывает старый.
Почему недостаточно просто хранить файлы
Можно было бы положить в Git несколько файлов:
fdrw.sv
fdrw.sjv
fdrw.sjp
и считать задачу решённой.
Но через полгода возникнут вопросы.
Какое требование проверяет этот SJV?
Для какого commit был создан этот SJP?
Какие предположения использовались во время доказательства?
Изменялась ли реализация после проверки?
Есть ли требования, для которых вообще нет формального описания?
Есть ли формальные описания, которые ещё ни разу успешно не проверялись?
Есть ли доказательства, относящиеся уже к старой версии реализации?
Файловая система на эти вопросы не отвечает.
Assurance должен хранить связи между инженерными объектами и вычислять состояние доказательной базы.
Доказательство тоже может устареть
Одна из важных идей Assurance — успешное доказательство никогда не становится ложным задним числом.
Если свойство было успешно проверено для определённой версии реализации, этот исторический факт остаётся.
Но после изменения реализации это доказательство нельзя автоматически переносить на новую версию.
Поэтому Assurance различает исторический результат и его актуальность.
Если формальная проверка была выполнена для commit A, а текущая версия реализации уже находится в commit B, старое доказательство получает состояние:
устарело для текущего контекста.
Сам результат при этом сохраняется.
Это позволяет избежать опасной ситуации, когда в системе существует отметка PASS, но уже невозможно понять, к какой реализации она относилась.
Зачем нужен baseline
По мере развития проекта отдельные требования, SJV-описания, реализации и доказательства постоянно меняются.
Поэтому Assurance вводит ещё одно важное понятие — baseline, то есть неизменяемый снимок доказательной базы на определённый момент.
Например:
Memora8 Memory 0.8
Такой снимок может зафиксировать:
- версии требований;
- архитектурные решения;
- SJV;
- точные версии реализации;
- выполненные проверки;
- SJP;
- запечатанные доказательства;
- связи между всеми этими объектами.
Для самого baseline рассчитывается контрольная сумма.
После создания он не изменяется.
Следующая версия системы получает новый baseline.
Это позволяет спустя время ответить на вопрос:
Чем именно подтверждались свойства Memora8 версии 0.8?
И получить не набор случайных файлов, а воспроизводимую доказательную цепочку.
Assurance и формальная верификация
Первым реальным полигоном для нового слоя станет разработка Memora8 и связанного стека.
Мы постепенно строим собственный процесс формальной проверки: от формального описания свойств до машинных доказательных артефактов.
При этом Assurance не будет сам выполнять формальную верификацию.
Проверка производится внешними инструментами.
Задача Assurance другая — сохранить точный контекст проверки и связать результат со всей инженерной системой.
Фактически это разделение ответственности:
SJV определяет, что проверяется.
Средство верификации выполняет проверку.
SJP содержит результат доказательной процедуры.
Assurance фиксирует, чему относится этот результат и можно ли считать его актуальным.
Не только формальные доказательства
Хотя первым сценарием станет формальная верификация, сама модель шире.
В такую же цепочку могут входить:
- обычные тесты;
- моделирование;
- статический анализ;
- анализ покрытия;
- проверка архитектуры;
- результаты сборки;
- инспекции;
- анализ безопасности;
- результаты сертификационных испытаний.
То есть Assurance постепенно может стать общей доказательной базой инженерного проекта.
Для каждого утверждения можно будет увидеть не только его текст, но и то, чем оно подтверждено.
Почему это становится частью Noda
Первоначально мы рассматривали Assurance как отдельное приложение.
Но значительная часть необходимой инфраструктуры уже существует в Noda:
- MCP для взаимодействия с ИИ-агентами;
- аутентификация;
- доступы;
- Cloudflare Workers;
- D1;
- R2;
- аудит;
- работа с версиями.
Поэтому принято решение развивать Assurance как отдельный предметный слой внутри Noda.
При этом Knowledge и Assurance не смешиваются.
Знание не становится доказательством автоматически.
А наличие доказательства не делает его каноном Noda.
Это два независимых пространства, которые используют одну платформу.
Работа через ИИ-агента
Отдельный пользовательский интерфейс для Assurance на первом этапе не планируется.
Основным клиентом остаётся ИИ-агент.
Например, разработчик сможет сказать:
Мы изменили протокол FD-R/W. Зафиксируй новую архитектуру и покажи, какие доказательства требуется выполнить повторно.
Агент сможет:
- найти затронутые требования;
- определить связанные SJV;
- определить доказательства, относящиеся к старой реализации;
- показать недостающие проверки;
- зарегистрировать новый запуск верификации;
- сохранить полученный SJP;
- сформировать новый baseline.
Таким образом ИИ используется не как источник истины, а как оператор строго структурированной инженерной системы.
Истиной остаются конкретные версии объектов, связи, контрольные суммы и результаты проверок.
К чему мы хотим прийти
Конечная цель выглядит примерно так.
Для каждого значимого свойства системы можно пройти цепочку:
Что утверждается?
↓
Где это формально описано?
↓
В какой реализации это присутствует?
↓
Как это проверялось?
↓
Какой доказательный артефакт получен?
↓
Относится ли он к текущей версии?
↓
В какой baseline он был зафиксирован?
Если эта цепочка воспроизводима машиной, инженерная документация перестаёт быть набором разрозненных текстов и файлов.
Она становится доказательной структурой проекта.
Именно такую структуру мы хотим получить в Sekura Noda Assurance.
На первом этапе работа будет вестись на реальных задачах Memora8: требования, SJV-описания, версии реализации, запуски формальной проверки, SJP-артефакты, evidence и baseline.
Следующий практический вопрос для нас уже не «как написать ещё один документ о системе», а:
можем ли мы для каждого важного утверждения показать конкретное, воспроизводимое доказательство?
Именно вокруг этого вопроса начинается разработка Assurance.

 Share








