



The post has been translated automatically. Original language: Russian





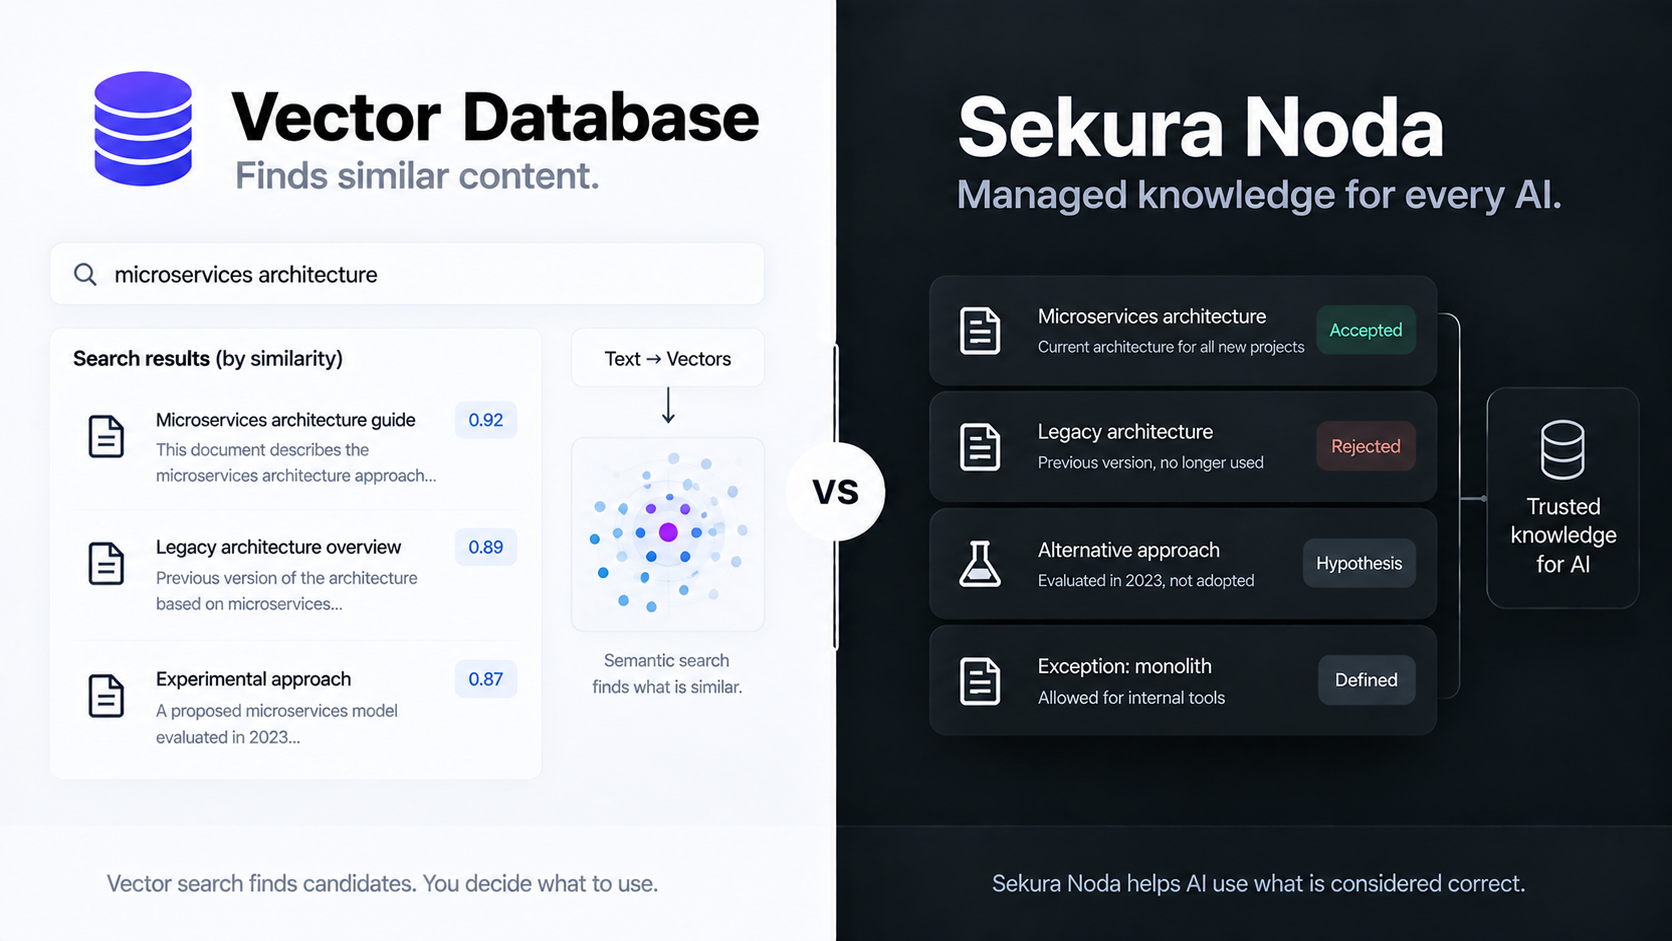
The vector database is great at finding something similar. But similar doesn't mean right.
Vector search turns texts and other data into numeric representations and searches for objects that are closest in meaning to the query.
It is very useful for:
- semantic search;
- Recommendations;
- search through large archives;
- setting the context for AI;
- systems based on RAG.
But the database itself solves the technical problem.:
which records are most similar to the query?
She doesn't have to know that one of these records is outdated.
Or that another approach was rejected.
Or that the third entry is just an unconfirmed hypothesis.
For example, a search might return:
- an old architectural solution;
- the current architecture;
- an experimental version that was abandoned.
All three texts are semantically close.
Therefore, from the point of view of vector search, the result may be excellent.
From the point of view of a professional decision, it is dangerous.
Sekura Noda solves a different problem
In Sekura Noda, knowledge has not only a content, but also a state.
You can explicitly define:
it is accepted; it is rejected; it is a hypothesis; this decision is no longer valid.
Therefore, the task is not limited to finding the nearest text.
It is important to know which of the found knowledge is generally allowed to be applied.
Vector database helps to answer:
What is most similar to my query?
Sekura Noda answers another question:
Which of these is considered valid knowledge?
Where is a vector database better?
When you need a fast semantic search over a large amount of data.
It is specialized and effective for this task.
Where is Sekura Noda better
When the search result must take into account not only semantic proximity, but also the professional status of knowledge.
Especially if the old, erroneous and current solution are similar to each other.
These technologies are not mutually exclusive.
The vector database helps to find candidates. Sekura Noda helps you determine which ones you can trust.
Векторная база данных отлично находит похожее. Но похожее — не значит правильное.
Векторный поиск превращает тексты и другие данные в числовые представления и ищет объекты, которые ближе всего по смыслу к запросу.
Это очень полезно для:
- семантического поиска;
- рекомендаций;
- поиска по большим архивам;
- подбора контекста для ИИ;
- систем на основе RAG.
Но сама база решает техническую задачу:
какие записи наиболее похожи на запрос?
Она не обязана знать, что одна из этих записей устарела.
Или что другой подход был отвергнут.
Или что третья запись — всего лишь неподтверждённая гипотеза.
Например, поиск может вернуть:
- старое архитектурное решение;
- действующую архитектуру;
- экспериментальный вариант, от которого отказались.
Все три текста семантически близки.
Поэтому с точки зрения векторного поиска результат может быть отличным.
С точки зрения профессионального решения — опасным.
Sekura Noda решает другую задачу
В Sekura Noda знание имеет не только содержание, но и состояние.
Можно явно определить:
это принято;это отклонено;это гипотеза;это решение больше не действует.
Поэтому задача не сводится к поиску ближайшего текста.
Важно знать, какие из найденных знаний вообще разрешено применять.
Векторная база данных помогает ответить:
Что больше всего похоже на мой запрос?
Sekura Noda отвечает на другой вопрос:
Что из этого считается действующим знанием?
Где векторная база данных лучше
Когда требуется быстрый семантический поиск по большому объёму данных.
Для этой задачи она специализирована и эффективна.
Где Sekura Noda лучше
Когда результат поиска должен учитывать не только смысловую близость, но и профессиональный статус знания.
Особенно если старое, ошибочное и действующее решение похожи друг на друга.
Эти технологии не исключают друг друга.
Векторная база помогает найти кандидатов. Sekura Noda помогает определить, каким из них можно доверять.

 Share








