

The post has been translated automatically. Original language: Russian




As we revise the Memora8 instruction set, we evaluate each feature not only by how convenient it is for software, but also by what it actually costs in hardware. Some operations require additional control signals and logic across large parts of the processor, while others can be implemented by a compact local unit and shared by several instructions.
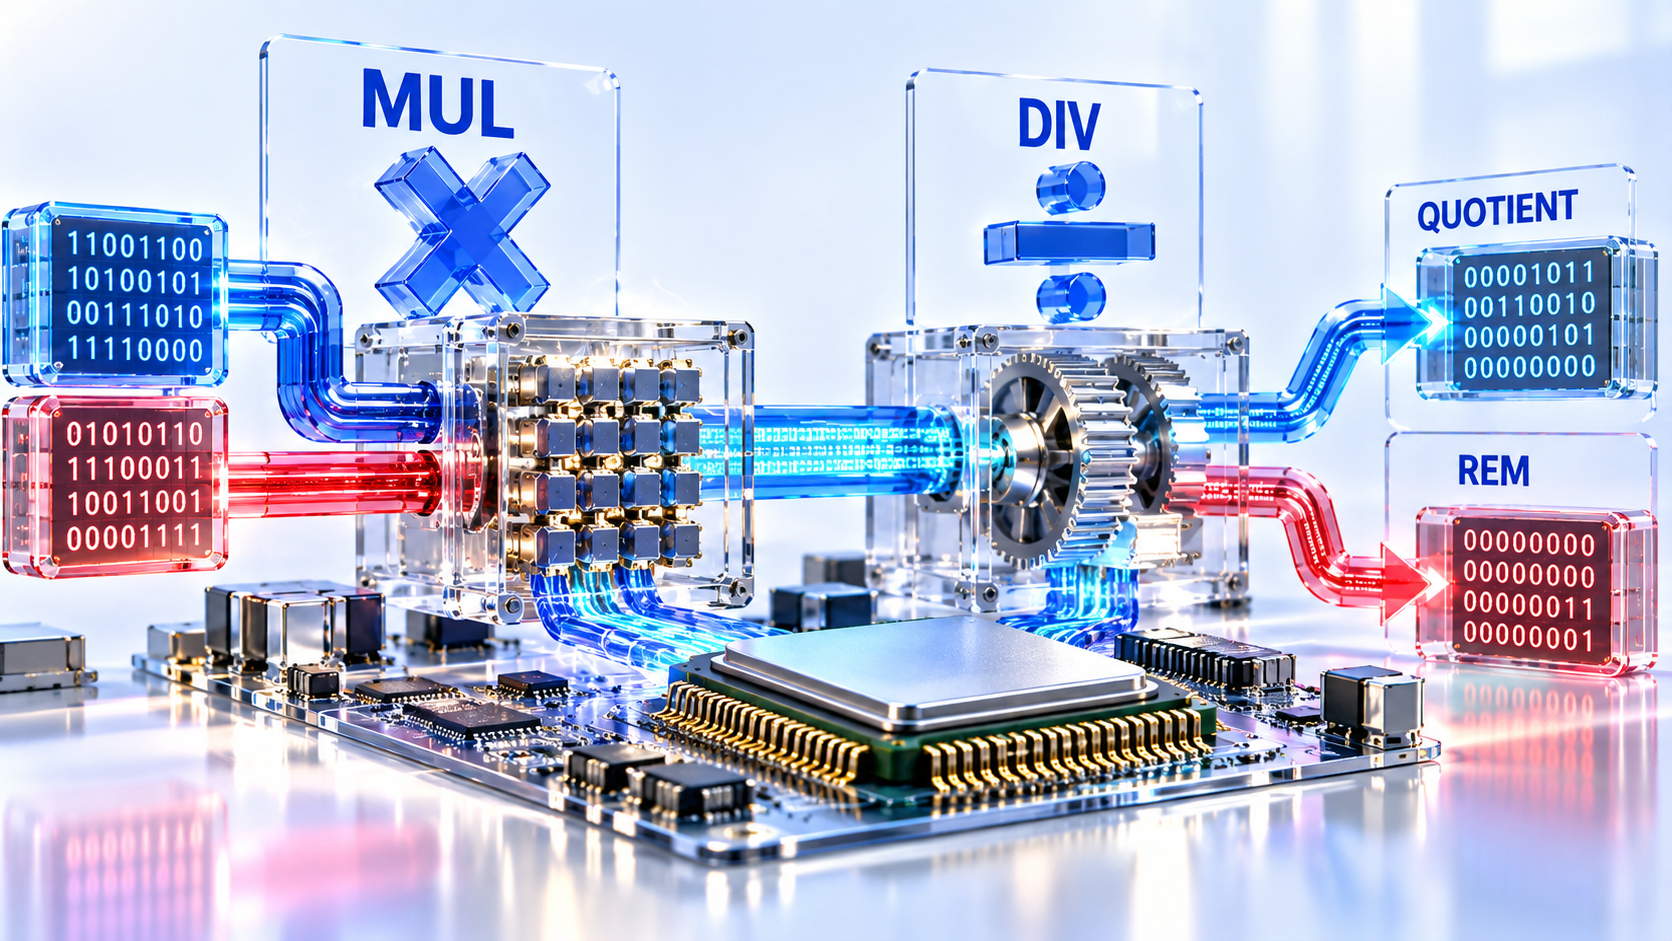
This is why Memora8 is considering native multiplication, division, and remainder operations. From a programmer’s point of view, these are ordinary arithmetic operations. Inside the processor, however, they can be implemented much more efficiently than the number of new instructions might suggest.
Why Addition and Shifts Are Not Always Enough
Integer multiplication can be implemented in software using a sequence of additions and shifts. Division can also be expressed as an algorithm built from simpler operations, so a processor does not strictly need dedicated multiplication or division instructions.
The problem is the amount of work required in software. A single arithmetic operation may turn into many machine instructions, additional branches, temporary values, and helper routines. The compiler must repeatedly generate the same kind of sequence.
For a very small specialized controller, that trade-off can be reasonable. For a general-purpose 32-bit processor, the software cost may become too high.
Three Multiplication Instructions Can Share One Hardware Unit
Memora8 is considering three multiplication instructions: MUL, MULH, and MULHU.
MUL returns the lower 32 bits of the product. The other two instructions return the upper part of the full 64-bit result, with different signedness rules.
Having three instructions does not mean that the processor needs three separate multipliers.
A single 32-bit hardware multiplier can perform all three operations. The difference is mainly in how the operands are interpreted and which part of the result is returned.
This reflects an important Memora8 design principle: several useful instructions may share one physical computation unit.
FPGA Hardware Already Provides Efficient Multiplication Resources
The Artix-7 FPGA used for Memora8 prototyping contains dedicated arithmetic blocks that can efficiently perform multiplication. There is no need to build a complete multiplier entirely from general-purpose logic.
The processor can use a resource that already exists inside the FPGA. One multiplier per core can serve all multiplication instructions, making the hardware cost lower than the instruction count alone might suggest.
The final decision, however, cannot be based only on a block diagram. It must be verified after the complete design has been placed and routed on the actual FPGA.
Division Can Be Implemented Differently
A 32-bit division does not need to be implemented as a large combinational circuit that must produce its result within a single clock cycle.
Such a design can consume substantial logic resources and create a long critical path, reducing the maximum clock frequency of the entire processor.
Memora8 is therefore considering an iterative divider. It receives the two operands and computes the result over a number of clock cycles, likely on the order of several dozen cycles for a 32-bit operation.
From the program’s point of view, this is still one division instruction. The difference is simply that the result takes longer to become available than the result of an addition or a logical operation.
For an expensive operation that is not executed continuously, this can be a good trade-off: division itself takes longer, but the rest of the processor remains simpler and faster.
Division and Remainder Can Use the Same Mechanism
Integer division normally produces two useful values: the quotient and the remainder.
Memora8 therefore considers separate instructions for both results, including signed and unsigned variants:
DIV, DIVU, REM, and REMU.
These do not require four independent hardware units. A single iterative divider can calculate the necessary values and return either the quotient or the remainder depending on the instruction being executed.
Once again, several machine instructions can be implemented through one physical block.
This makes the instruction set more useful to software without duplicating expensive hardware.
Why Remainder Deserves Its Own Instruction
The remainder operation is common in indexing, circular structures, range calculations, resource distribution, and many ordinary algorithms.
If the divider already computes the remainder as part of the division process, forcing software to reconstruct the same value using additional instructions provides little benefit.
For this reason, dedicated remainder instructions are a natural addition. Their main hardware cost is already covered by the divider itself.
This is a good example of an instruction that can increase the expressive power of the processor much more than it increases its physical complexity.
Not Every Operation Needs to Finish in One Clock Cycle
When designing a processor, it is tempting to make every instruction as fast as possible. But the speed of one instruction and the speed of the entire system are not the same thing.
If single-cycle division requires such a large circuit that the maximum frequency of the processor drops, then every other instruction is affected as well.
An iterative divider avoids this problem. Common operations keep a short and fast path, while extra time is spent only when the program actually requests division.
For Memora8, this fits the broader design approach: frequent and timing-critical operations should be fast, while rare and expensive operations may take multiple cycles.
The Instruction Set Must Reflect Physical Cost
At first glance, it may appear contradictory that Memora8 is removing some very simple memory operations while adding much more complex multiplication and division instructions.
The reason is that the apparent complexity of an operation says little about its actual cost inside the chip.
For example, supporting byte-level memory writes requires additional control signals to be distributed through a large part of the memory structure. A multiplier, in contrast, is a local unit inside one processor core and can use dedicated arithmetic resources already available in the FPGA.
The iterative divider is also local to the core and can serve several arithmetic instructions.
This is why we evaluate instructions not by how simple their names look in a table, but by the physical structure they require from the complete system.
The Next Step Is Hardware Verification
The next task is to test this approach in the full eight-core implementation.
We need to measure how many dedicated arithmetic resources multiplication requires, how much logic the divider consumes, and how the new units affect placement and routing.
It is equally important to preserve the target clock frequency of 125 MHz. If the new arithmetic functions create a new critical path or significantly complicate routing, the architecture will need to be reconsidered.
For that reason, multiplication and division in Memora8 are still being treated as an architectural hypothesis that must be verified in hardware rather than as a finished decision.
The main principle is simple: a complex operation is justified when it can be implemented locally once, reused by many programs, and does not force the rest of the system to continuously pay for its existence.
При пересмотре набора команд Memora8 мы стараемся оценивать каждую возможность не только с точки зрения удобства программирования, но и по её реальной стоимости в аппаратуре. Одни операции требуют дополнительных линий и логики во многих частях процессора, тогда как другие можно реализовать одним компактным вычислительным узлом и использовать сразу для нескольких команд.
Именно поэтому в Memora8 рассматривается добавление аппаратного умножения, деления и вычисления остатка. Для программы это привычные арифметические действия, однако внутри процессора их можно организовать значительно проще, чем может показаться по количеству новых команд.
Почему сложения и сдвига недостаточно
Целочисленное умножение можно выполнить программно через последовательность сложений и сдвигов. Аналогичным образом можно построить алгоритм деления, поэтому формально процессор способен обойтись без специальных арифметических команд.
На практике простая математическая операция тогда превращается в десятки машинных действий. Программе требуются дополнительные переходы, временные значения и служебные процедуры, а компилятору приходится каждый раз воспроизводить один и тот же алгоритм.
Для небольшого специализированного контроллера это иногда оправдано. Для 32-битного процессора общего назначения такая экономия аппаратуры уже может стоить слишком дорого на уровне программного обеспечения.
Три команды умножения — один аппаратный узел
В Memora8 рассматриваются три варианта умножения: обычное умножение с получением младшей части результата и два варианта получения старшей части полного 64-битного произведения.
На уровне машинных команд они обозначаются как MUL, MULH и MULHU. Однако наличие трёх команд не означает появление трёх независимых умножителей.
Все эти действия может выполнять один общий 32-битный аппаратный умножитель. Различается только интерпретация исходных чисел и выбор нужной половины результата.
Это важный принцип архитектуры Memora8: несколько понятных программисту операций могут использовать один и тот же физический вычислительный блок.
ПЛИС уже содержит подходящие средства для умножения
Используемая для прототипирования Memora8 ПЛИС Artix-7 содержит специализированные вычислительные блоки, предназначенные в том числе для быстрого умножения чисел. Поэтому нет необходимости собирать полноценный умножитель из большого количества обычных логических элементов.
Процессор может использовать существующий ресурс кристалла. Один такой вычислительный узел на ядро обслуживает все варианты умножения, что делает добавление этих команд значительно дешевле, чем могло бы показаться при взгляде только на список команд.
При этом окончательное решение зависит не от теоретической схемы, а от результатов размещения и трассировки всей системы на реальной ПЛИС.
Деление устроено иначе
Для деления не обязательно создавать огромную комбинационную схему, которая обязана получить результат за один такт. Такой подход увеличивает число логических элементов и способен создать длинный критический путь, ограничивающий частоту всего процессора.
В Memora8 рассматривается последовательный делитель. Он получает два исходных числа и выполняет вычисление постепенно, примерно за несколько десятков тактов.
С точки зрения программы это всё равно одна операция деления. Разница заключается в том, что процессор ждёт завершения вычисления дольше, чем при обычном сложении или логической операции.
Для редко выполняемой тяжёлой арифметики такой обмен выглядит разумным: операция работает дольше, но не заставляет усложнять и замедлять весь процессор.
Деление и остаток используют один механизм
Для целочисленного деления обычно нужны два результата: частное и остаток. В Memora8 для них предусмотрены отдельные машинные команды, в том числе варианты для чисел со знаком и без знака.
Но аппаратно это не четыре независимых устройства. Один и тот же последовательный делитель может вычислять оба результата, после чего процессор возвращает программе либо частное, либо остаток.
Таким образом, несколько команд снова сводятся к одному физическому узлу. Это позволяет сделать набор команд удобнее для программирования, почти не дублируя сложную аппаратную логику.
Почему остаток стоит отдельной команды
Остаток от деления часто используется при работе с индексами, кольцевыми структурами, распределением значений по диапазону и во многих обычных алгоритмах. Если аппаратный делитель всё равно получает остаток в ходе вычисления, заставлять программу повторно строить эту операцию программными средствами нет большого смысла.
Поэтому Memora8 рассматривает отдельные команды для получения остатка. Их стоимость в наборе команд невелика, поскольку основная вычислительная аппаратура уже существует для деления.
Это пример ситуации, когда новая команда увеличивает выразительность процессора значительно сильнее, чем его физическую сложность.
Почему не нужно выполнять всё за один такт
При проектировании процессора легко прийти к мысли, что каждая команда должна быть максимально быстрой. Однако скорость отдельной команды и скорость всей системы — разные вещи.
Если однотактное деление потребует настолько большой схемы, что снизит максимальную частоту всего ядра, большинство остальных операций также станет выполняться медленнее. Последовательный делитель позволяет избежать такой ситуации: обычные команды сохраняют короткий тракт, а дополнительное время тратится только тогда, когда программе действительно требуется деление.
Для Memora8 это соответствует общему подходу: быстрыми должны быть наиболее частые и критичные пути, а редкая сложная операция может занимать несколько тактов.
Набор команд должен учитывать физическую стоимость
На первый взгляд может показаться противоречивым, что в Memora8 одновременно убираются некоторые очень простые операции памяти и добавляются гораздо более сложные умножение и деление.
Но сложность названия операции почти ничего не говорит о её стоимости в кристалле. Например, поддержка записи отдельных байтов требует дополнительных управляющих линий через значительную часть банковой памяти. Аппаратный умножитель, напротив, остаётся локальным узлом одного процессора и может использовать уже существующие специализированные ресурсы ПЛИС.
Последовательный делитель также находится внутри ядра и используется сразу для нескольких арифметических действий.
Поэтому мы оцениваем команды не по тому, насколько простыми они выглядят в таблице, а по тому, какую физическую структуру требуют от всей системы.
Следующий этап — проверка на аппаратуре
Теперь необходимо проверить решение на реальной реализации восьми процессоров. Нас интересует, сколько специализированных вычислительных блоков потребуется для умножения, сколько обычной логики займёт делитель и как новые узлы повлияют на размещение схемы.
Не менее важно сохранить целевую частоту 125 МГц. Если дополнительные арифметические возможности создадут новый критический путь или заметно усложнят трассировку, архитектуру придётся пересмотреть.
Поэтому добавление умножения и деления в Memora8 пока рассматривается не как завершённое решение, а как проверяемая архитектурная гипотеза.
Главная идея остаётся простой: сложная операция оправдана, если её можно локально реализовать один раз и использовать во многих программах, не заставляя всю остальную систему постоянно платить за её наличие.

 Share








