

The post has been translated automatically. Original language: Russian





When a program passes tests, the result is usually clear: the tests were completed successfully or an error was detected. In a formal verification, you can do the same thing — show the developer the message "the property is proven" and end there.
But for complex systems, this may not be enough. It is important not only to find out that the verification was successful once, but also to understand what exactly was tested, on which version of the program, with what assumptions and on what other results the proof depended.
Therefore, in SJV we consider the result of the formal verification as a separate stored object.
Why is the "verification passed" message not enough?
Let's imagine that the developer checked the processor module and got a successful result. A month later, the source code changed, one of the libraries was updated, and the neighboring module received a new implementation.
Can the old result still be considered valid? If you save only a text message stating that the check was completed, it will be difficult to answer this question.
Formal verification is always performed with respect to specific code, specific properties, and a specific environment. Changing any of these elements can change the result.
Therefore, it is useful to save not only the "successful" result, but also information about what exactly it was obtained for.
The result as a separate artifact
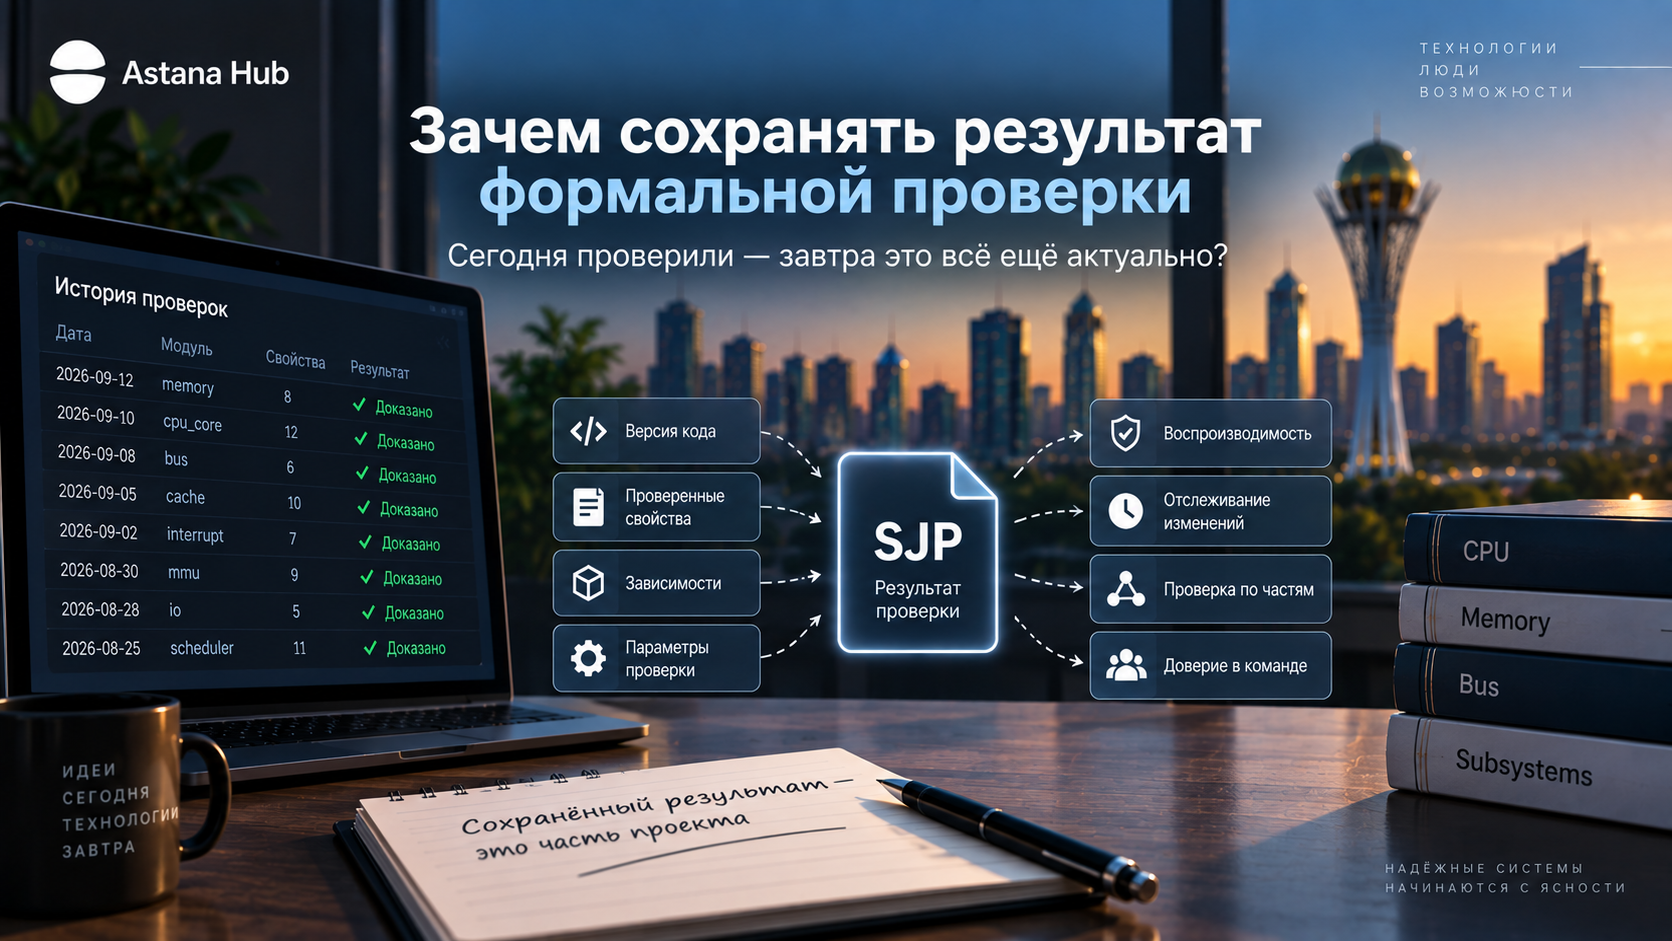
In SJV, this result is stored in the SJP file. It can be considered as evidence that a certain version of the module has been tested against the specified properties.
It can record which source code was used, which rules were checked, and on which components the result depended. For this purpose, checksums of files and dependencies are used, among other things.
If the source code has changed, its checksum also changes. This allows you to determine whether the old verification result applies to the current version of the program or whether the verification needs to be performed anew.
This approach makes the test result a part of the project, rather than a temporary line in the program log.
Why is this necessary with a large system?
As long as the project consists of one small module, the need to save the test results may not be obvious. You can simply start checking the entire system again.
As the project grows, the situation changes. A processor, for example, consists of many components: memory, devices, exchange buses, control units, and other modules. Each of them can have its own properties and depend on other components.
If, with any change, you have to re-check the entire thing, the cost of such verification increases rapidly. In addition, it becomes more difficult to understand exactly which part of the system was affected by the change.
Saved results allow you to link the tested components together. If one module uses the properties of another, you can explicitly fix this dependency.
Check the system piece by piece
Suppose there is a memory module for which several important properties have already been proven. For example, it is determined under what conditions the processor gets the right to access the page and when this right is released.
The next level of the system can use these properties without repeating the entire internal memory check every time. For him, a proven module becomes a component with known behavior.
If the result of the memory check is saved and linked to a specific version of the source code, the system can make sure that the module whose properties have already been proven is being used.
This way, you can gradually build a chain of checks from small components to larger ones. At the same time, each step is based not just on an assumption about the work of the lower level, but on a specific saved result.
What happens after the code is changed
This approach is especially useful for continuous development. The source code rarely remains the same: bugs are fixed, architecture is changing, and new features are emerging.
After the change, it is important to understand which previous results can no longer be considered valid. If the change affected only one component, there is no need to automatically invalidate the entire project history.
The relationships between the test results allow you to identify the dependent parts. If the memory module has changed, you need to review its own proofs and those components that directly depend on them.
It looks like a regular program build system. When you change a single source file, it doesn't necessarily rebuild the entire project, but rather determines which parts are actually affected.
A similar principle can be applied for formal verification.
This is also important for reproducibility.
Saving the result is useful not only for the computer, but also for people. After a few months, the developer can return to the old solution and see what exactly was considered proven at that moment.
This is especially important in large projects where architectural solutions are gradually changing. Without a saved history, it's easy to get a situation where the team is sure that a certain property was checked once, but no one remembers for which version and under what conditions.
A separate result allows you to make such information explicit. It links the correctness statement to the specific state of the project.
This does not eliminate the need for documentation, but it reduces the number of things that have to be stored only in the developers' memory.
The proof also has boundaries
A saved result does not mean that the module becomes correct forever. It confirms only those properties that have been formulated and verified in a given model.
If the developer has not described an important limitation, it will not appear in the result automatically. Similarly, an error in assumptions about the environment can make the proof less useful than it seems.
Therefore, it is important to preserve not only the fact of successful verification, but also its boundaries. You need to understand which properties are actually tested and which are outside the model.
This is especially important when using the results of one component in the verification of another. The higher the system level, the more it depends on the accuracy of the underlying assumptions.
From verification to the chain of trust
In normal development, you often have to trust that the neighboring module works according to the documentation. In a formal verification, you can try to make this trust more explicit.
If a module has a saved validation result, and another component uses exactly this result, a chain of dependencies arises. You can track which top-level properties rely on which proven components.
In SJV, we want to use this approach to construct composite proofs. Checking a complex system then becomes not one huge operation, but a set of related results.
This approach is especially interesting for projects like Memora8, where the architecture consists of many interacting parts and is constantly evolving.
Why it might be more important than the success message itself
Formal verification is useful not only at the time of launch. It is equally important what happens to the result after the program is completed.
If the result disappears immediately after verification, all that remains is to trust the logs and the memory of the developers. If it is saved, linked to the source code and other results, the verification becomes part of the project structure.
That is why in SJV we are interested not only in the question "is the property proved?". Another important question is: "can we determine exactly what has been proven after a while, for which version and on which previous results it is based?"
For a small project, this may seem redundant. For a large system that has been developing for years and consists of many components, such traceability can be one of the most useful properties of formal verification.
Когда программа проходит тесты, результат обычно понятен: тесты выполнены успешно или обнаружена ошибка. В формальной проверке можно действовать так же — показать разработчику сообщение «свойство доказано» и на этом закончить.
Но для сложных систем этого может быть недостаточно. Важно не только узнать, что проверка однажды прошла успешно, но и понимать, что именно было проверено, на какой версии программы, с какими предположениями и от каких других результатов зависело доказательство.
Поэтому в SJV мы рассматриваем результат формальной проверки как отдельный сохраняемый объект.
Почему сообщения «проверка пройдена» недостаточно
Представим, что разработчик проверил модуль процессора и получил успешный результат. Через месяц исходный код изменился, одна из библиотек была обновлена, а соседний модуль получил новую реализацию.
Можно ли по-прежнему считать старый результат действительным? Если сохранить только текстовое сообщение о том, что проверка когда-то прошла, ответить на этот вопрос будет трудно.
Формальная проверка всегда выполняется относительно конкретного кода, конкретных свойств и определённого окружения. Изменение любого из этих элементов может изменить результат.
Поэтому полезно сохранять не только итог «успешно», но и сведения о том, для чего именно он был получен.
Результат как отдельный артефакт
В SJV такой результат сохраняется в файле SJP. Его можно рассматривать как свидетельство того, что определённая версия модуля была проверена относительно заданных свойств.
В нём можно зафиксировать, какой исходный код использовался, какие правила проверялись и от каких уже проверенных компонентов зависел результат. Для этого используются в том числе контрольные суммы файлов и зависимостей.
Если исходный код изменился, его контрольная сумма тоже меняется. Это позволяет определить, относится ли старый результат проверки к текущей версии программы или проверку необходимо выполнить заново.
Такой подход делает результат проверки частью проекта, а не временной строкой в журнале работы программы.
Зачем это нужно при большой системе
Пока проект состоит из одного небольшого модуля, необходимость сохранять результаты проверки может быть неочевидной. Можно просто запустить проверку всей системы заново.
С ростом проекта ситуация меняется. Процессор, например, состоит из множества компонентов: памяти, устройств, шин обмена, блоков управления и других модулей. Каждый из них может иметь собственные свойства и зависеть от других компонентов.
Если при любом изменении приходится заново проверять всё целиком, стоимость такой проверки быстро растёт. Кроме того, становится сложнее понимать, какая именно часть системы была затронута изменением.
Сохранённые результаты позволяют связать проверенные компоненты между собой. Если один модуль использует свойства другого, можно явно зафиксировать эту зависимость.
Проверять систему по частям
Предположим, есть модуль памяти, для которого уже доказано несколько важных свойств. Например, определено, при каких условиях процессор получает право доступа к странице и когда это право освобождается.
Следующий уровень системы может использовать эти свойства, не повторяя каждый раз всю внутреннюю проверку памяти. Для него проверенный модуль становится компонентом с известным поведением.
Если результат проверки памяти сохранён и связан с конкретной версией исходного кода, система может убедиться, что используется именно тот модуль, свойства которого уже были доказаны.
Так постепенно можно строить цепочку проверок от небольших компонентов к более крупным. При этом каждая ступень опирается не просто на предположение о работе нижнего уровня, а на конкретный сохранённый результат.
Что происходит после изменения кода
Особенно полезен такой подход при постоянной разработке. Исходный код редко остаётся неизменным: исправляются ошибки, меняется архитектура, появляются новые возможности.
После изменения важно понять, какие предыдущие результаты больше нельзя считать действительными. Если изменение затронуло только один компонент, нет необходимости автоматически считать недействительной всю историю проекта.
Связи между результатами проверки позволяют определить зависимые части. Если изменился модуль памяти, нужно пересмотреть его собственные доказательства и те компоненты, которые непосредственно от них зависят.
Это похоже на обычную систему сборки программы. При изменении одного исходного файла она не обязательно пересобирает весь проект, а определяет, какие части действительно затронуты.
Для формальной проверки можно применять похожий принцип.
Это важно и для воспроизводимости
Сохранение результата полезно не только компьютеру, но и людям. Через несколько месяцев разработчик может вернуться к старому решению и посмотреть, что именно считалось доказанным в тот момент.
Это особенно важно в больших проектах, где архитектурные решения постепенно меняются. Без сохранённой истории легко получить ситуацию, когда команда уверена, что некоторое свойство когда-то проверялось, но уже никто не помнит, для какой версии и при каких условиях.
Отдельный результат позволяет сделать такую информацию явной. Он связывает утверждение о корректности с конкретным состоянием проекта.
Это не отменяет необходимость документации, но уменьшает количество вещей, которые приходится хранить только в памяти разработчиков.
Доказательство тоже имеет границы
Сохранённый результат не означает, что модуль становится правильным навсегда. Он подтверждает только те свойства, которые были сформулированы и проверены в заданной модели.
Если разработчик не описал важное ограничение, оно не появится в результате автоматически. Точно так же ошибка в предположениях об окружении может сделать доказательство менее полезным, чем кажется.
Поэтому важно сохранять не только факт успешной проверки, но и её границы. Нужно понимать, какие свойства действительно проверены, а какие находятся за пределами модели.
Это особенно важно при использовании результатов одного компонента в проверке другого. Чем выше уровень системы, тем сильнее он зависит от точности нижележащих предположений.
От проверки к цепочке доверия
В обычной разработке часто приходится доверять тому, что соседний модуль работает согласно документации. В формальной проверке можно попытаться сделать это доверие более явным.
Если модуль имеет сохранённый результат проверки, а другой компонент использует именно этот результат, возникает цепочка зависимостей. Можно проследить, какие свойства верхнего уровня опираются на какие проверенные компоненты.
В SJV мы хотим использовать этот подход для построения составных доказательств. Проверка сложной системы тогда становится не одной огромной операцией, а набором связанных между собой результатов.
Такой подход особенно интересен для проектов вроде Memora8, где архитектура состоит из множества взаимодействующих частей и постоянно развивается.
Почему это может быть важнее самого сообщения об успехе
Формальная проверка полезна не только в момент запуска. Не менее важно, что происходит с её результатом после завершения работы программы.
Если результат исчезает сразу после проверки, остаётся только доверять журналам и памяти разработчиков. Если же он сохраняется, связывается с исходным кодом и другими результатами, проверка становится частью структуры проекта.
Именно поэтому в SJV нас интересует не только вопрос «доказано ли свойство?». Не менее важен другой вопрос: «можем ли мы спустя время точно определить, что именно было доказано, для какой версии и на каких предыдущих результатах это основано?»
Для небольшого проекта это может показаться избыточным. Для большой системы, которая развивается годами и состоит из множества компонентов, такая прослеживаемость может оказаться одним из самых полезных свойств формальной проверки.

 Share








