
The post has been translated automatically. Original language: Russian



On Sunday, October 11, nobody in Almaty or other Kazakh cities could book a Yandex Taxi, and couriers were left without orders. Yandex Go said its services were temporarily unavailable and could not say when they would be back. That same morning taxis stopped working in Tashkent, and Kyrgyzstan saw disruptions too. The cause lay thousands of kilometers away, in Russia, where drone attacks had damaged Yandex data centers.
The company was quick to point out that Kazakh users’ personal data is stored on servers in Kazakhstan. The data stayed at home, and the service went down anyway. In Yandex’s own words, “technical problems in one of the components can affect the availability of services in several countries.”
This is not the first story of its kind in the past year. In South Korea, a fire at a single government data center took down 647 public services. In the Middle East, drones knocked out three AWS data centers, and some of the data in Bahrain was never recovered. Meanwhile, AI agents are now running cyberattacks on their own, with humans left mostly to supervise.
All of these cases share the same root: when a lot depends on a single point, losing it hits everyone at once. Below we look at what exactly happened, why Europe is moving government communications to federated systems, and what Kazakhstan can take from that.
When Convenience Became a Risk
For ten years, putting everything into a handful of large data centers made sense. It was cheaper and easier to manage, and it delivered capacity no single company could build on its own. But the more people rely on one site, the harder it hurts when that site fails.
In recent years the model has picked up new problems. Data centers have become military targets: the infrastructure behind banks, public services and telecoms is hit by drones just like power plants. Attackers now have AI, so a small group can probe dozens of organizations for weak spots at the same time. And dependencies have become almost invisible. A company often has no idea that its messenger, its CRM and its payment service all run in the same region of the same provider. It finds out on the day that provider goes down.
A backup in the same building, or with the same provider, protects against none of this.
Fire, Drones and Cables
You don’t have to hack a digital service to stop it. Cutting off its servers’ power, cooling or connectivity is enough. Here is what that has looked like in recent years.
| When | What happened | How it ended |
| March 2026 | Drones struck two AWS data centers in the UAE and one in Bahrain | Long cloud service outages. In September AWS admitted that data stored only in Bahrain could not be recovered |
| September 2025 | Lithium-ion batteries caught fire at the NIRS government data center in Daejeon (South Korea) | 647 public services halted, 96 systems destroyed. An 858 TB storage system used by civil servants had no backup |
| September 2025 | Several undersea cables were cut in the Red Sea | Microsoft Azure latency between Asia and Europe went up, internet disruptions hit Asia and the Middle East |
| October 2022 | Fire at the SK C&C data center in Pangyo (South Korea) | KakaoTalk (about 53 million users) and some Naver services were down for several hours |
In every one of these cases a backup existed, just not where it was needed. In Korea, about 40% of the 1,600 government systems ran on a single site with no mirror, and recovery dragged on for weeks. In Bahrain, the only AWS customers who kept their data were those who had already stored copies in other regions.
AI on the Attackers’ Side
In mid-September 2025, Anthropic uncovered a cyber espionage campaign in which an AI agent did most of the work. It searched for vulnerabilities, wrote exploits and harvested passwords on its own. By the company’s estimate, the agent carried out 80–90% of the tactical actions, with humans stepping in only at key moments. Around 30 organizations were targeted, from tech corporations and banks to government agencies, and in several cases the intrusion succeeded.
That is bad news for centralized systems. Finding a way into a large provider has become cheaper and faster, while the payoff is the same as before: access to all of its customers at once. An agent works around the clock and against many targets in parallel, so defenses tuned to a human pace spot the attack later. The prime targets become the control points: administrator accounts, cloud consoles, single sign-on systems. The more that depends on them, the more a single breach costs.
Defenders use AI too, and it helps. But if the whole system rests on one point, one successful attack is still enough.
When Things Break With No Attack at All
Malice isn’t even required. The two biggest outages of recent years started with ordinary technical mistakes.
In July 2024, a faulty update to CrowdStrike’s security software disabled about 8.5 million Windows computers. That is less than one percent of all such machines, yet airlines, banks, railways and retailers ground to a halt. In other words, exactly the organizations that manage their fleets centrally through a single vendor.
In October 2025, in AWS’s most popular region, us-east-1, a rare bug in DNS automation left the DynamoDB database without an address. Server launches, Lambda functions and load balancers failed in its wake. Some customers had problems for up to 15 hours.
In both cases the victims had done nothing wrong. They simply depended on one vendor or one region and couldn’t switch quickly. If random errors can cause that much damage, a deliberate attack on the same point should be expected to do at least as much.
The Yandex Outage: October 11–12, 2026
While we were working on this piece, an example turned up much closer to home. On October 11–12, nearly the entire Yandex ecosystem stopped working: Taxi, Food, Alice, Kinopoisk, Yandex Pay and some Yandex 360 features. The company’s statement was brief: “The infrastructure of our data centers has been damaged.” After a drone attack, a data center in the Vladimir region went into emergency shutdown. Shortly before that, sites in the Kaluga and Ryazan regions had been hit, and on October 8 Yandex Cloud reported power problems in one of its availability zones.
At Yandex, payments, taxis, delivery, mail and file storage all live on shared infrastructure, so they failed together. Yandex Pay and Yandex Go alone drew about 7,500 complaints in a day on a single monitoring site. Third-party companies had problems as well and blamed them on an outage at an infrastructure partner. Services were brought back one by one, starting with the most widely used. By evening Search, Maps, Taxi and Mail were working again, but no timeline was ever given for restoring the payment service.
An Outage Without Borders
For Central Asia, the key point of this story is something else: an outage in one country stopped services in its neighbors. Yandex Uzbekistan explained that its services run on distributed infrastructure. When one country has a failure, the load shifts to other regions, and errors start there too. Uzbekistan, Kazakhstan and Kyrgyzstan were all affected. In Tashkent, passengers could see neither cars nor prices, drivers couldn’t open Yandex Pro, and navigation and bus tracking were down. Izzat Shukurov, head of Yandex Uzbekistan, apologized to users and promised to deal separately with payments and payouts.
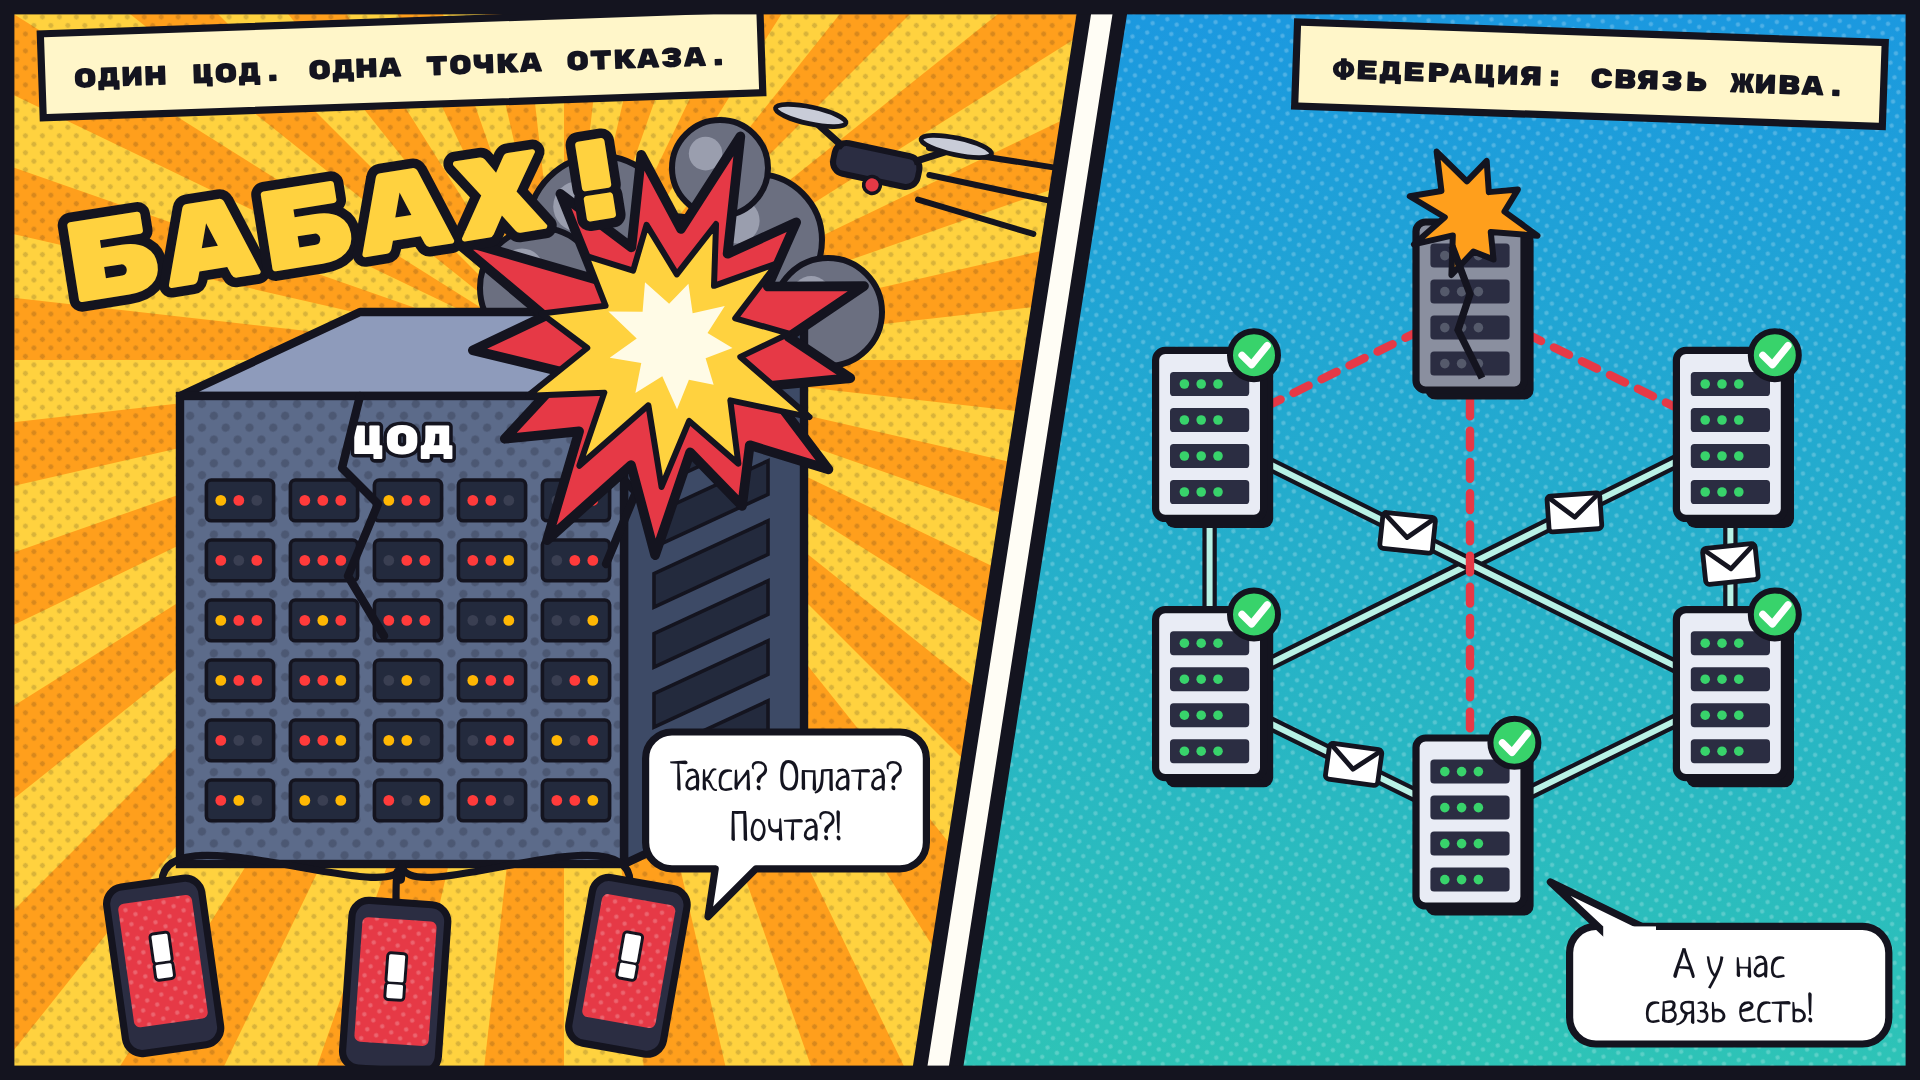
This shows clearly how a distributed system differs from a federated one. Yandex’s servers sit in different places, but they are managed as a single whole. That is why a problem in one link rolled into countries where no attack had taken place.
A few days earlier, from October 8 to 10, Uzum Market, Uzbekistan’s largest marketplace, was down for more than a day. Orders couldn’t be placed, the seller dashboard wouldn’t load, and warehouses and pickup points stood idle. The company itself attributed the outage to testing new infrastructure ahead of the peak season. Local media noticed that the timing coincided with the Yandex Cloud incident, but Uzum never confirmed that it uses Yandex infrastructure, so a direct link can’t be claimed. The cost of the downtime is clear regardless. The company had to extend order storage, hand out promo codes to shoppers, waive logistics fees for sellers until the end of the month and compensate pickup point owners for lost profit.
Which raises a question for every company in Kazakhstan. If the service that carries your work conversations goes down tomorrow, how will you get your people together?
Federation: What Europe Chose
Of all the layers of infrastructure, communications may be the most sensitive. You can get through a day without a taxi. You can’t get through a crisis without the channel your team uses to coordinate.
How It Works
In a centralized service, all users from all organizations live on one platform owned by one company. In a federated system, each organization has its own server, its own data and its own rules. Servers exchange messages over a common protocol, and only with those they trust. Email has worked this way for decades: if someone’s mail server goes down, mail keeps flowing everywhere else.
| Centralized service | Federated system | |
| Strike on the provider’s data center | All customers go down at once | One node goes down, the rest keep working |
| Server breach | Exposes data of all customers | Exposes data of one organization |
| Where the data lives | With the provider, under its jurisdiction | With each organization, inside its own perimeter |
| Communication with partners | Everyone has to be on the same service | Through trusted connections between servers |
| Switching vendors | The whole organization has to migrate | The node is replaced, the connections stay |
Federation has its price. It is harder to build, and someone has to look after every node: the organization itself or its integrator. In return, a single outage or a single attack can no longer stop everyone at once.
What Europe Is Doing
Over the past two years, federated communication in the EU has stopped being an experiment.
In February 2026, the European Commission confirmed that it was preparing an internal communication system on the open Matrix protocol as a backup channel. The link with the European Parliament is already running. By June, in its Communication on tech sovereignty (COM(2026) 503), the Commission describes the platform as launched and states plainly that Europe’s digital environment must be “interoperable, portable and based on open standards.”
Some countries got there earlier. France’s government messenger Tchap connects ministries and has more than 300,000 users. In Germany, the same protocol powers the Bundeswehr’s BwMessenger (over 100,000 active users) and TI-Messenger, which tens of thousands of independent healthcare organizations use to communicate. In March 2026 Belgium launched BEAM for civil servants and the military and expects eventually to connect up to 750,000 people. NATO is testing the same approach in its NICE2 project as a replacement for consumer messengers.
The Europeans’ motives are entirely practical. They don’t want to depend on a single vendor and a single jurisdiction, they want to keep their data at home, and they want to communicate freely across agencies and countries. Matrix co-founder Matthew Hodgson put it this way: digital sovereignty “has gone from being an ideological goal to a sudden concrete need.”
What This Means for Kazakhstan
Federation fits well with Kazakhstan’s data localization requirements. Each organization’s data stays on its own servers inside the country, but it isn’t pooled into one national data center. Ministries, national companies, banks and contractors talk to each other directly, while each runs its own node. Partners in neighboring countries can be connected through trusted links without handing correspondence over to someone else’s cloud.
Solutions like this already exist in our region. One example is aXtura, which our team develops: a corporate platform with a messenger, calls, video conferencing and internal services. It is backed by Finland’s Astrokvantit Oy and Kazakhstan’s Astrokvanta LLP, an Astana Hub participant, and we released version 1.0 in 2026. Here is how we approached the problem.
The platform can be installed entirely on the customer’s own servers, in the customer’s country and under the customer’s control. For large companies with tens of thousands of employees, the installation is deployed in a disaster-resilient configuration: servers sit at several sites, and if some of them fail because of a fire, a power cut or a drone strike, communication inside the company keeps working. aXtura connects to partners, contractors and government agencies through federation. Each party has its own installation, its own rules and access rights, and a failure or breach at one node doesn’t affect the others. It can also connect to compatible systems in neighboring countries.
But this isn’t about our product or anyone else’s. Europe has already accepted the principle itself: an organization’s working communications should not depend on a drone over someone else’s data center or a bug in someone else’s automation.
What to Do
There is no need to abandon the cloud. The goal is more modest: set things up so that losing one site, one provider or one administrator account doesn’t stop the business.
1. Map your dependencies. For every important system, find out which provider, which region and which site it runs on. It often turns out that email, the messenger and the accounting system all sit in the same data center.
2. Keep copies elsewhere and check that you can actually restore from them. A copy should live at a different site, ideally with a different provider, and at least one version should be protected from changes or taken offline altogether. Those 858 TB in Korea went unbacked precisely because there was “too much” of it.
3. Spread critical systems across different cities. You need at least two sites with replication and a rehearsed failover. If you have never actually switched to the backup, it will most likely fail you in a real emergency.
4. Choose a federated architecture for communications. A node for each organization and trusted connections with partners, as described above.
5. Remove the single point of control. Split administrator privileges, introduce hardware keys for sign-in, segment the network. Bring AI into monitoring: no human working by hand can keep up with an attack moving at machine speed.
6. Decide in advance how you will operate in emergency mode. Which functions must survive without the main data center, and which channel the team will use to reach each other if everything goes down. That channel must not depend on the same infrastructure.
What This Means for Kazakhstan and Central Asia
Kazakhstan already requires personal data to be stored inside the country (Law on Personal Data No. 94-V (Article 12)), and government and critical systems are subject to separate provisions of the Law on Informatization. In 2025–2026 the Digital Code and the Law on Artificial Intelligence were adopted. A draft is now under discussion that would let government agencies move to the cloud on a Cloud First basis, provided the encryption keys remain in Kazakhstan.
Localization answers the question of whose laws apply to the data. Whether the data survives an outage is a separate matter. If an entire country’s data physically sits in a few large data centers, the risk only becomes more concentrated. That is exactly the Korean story: everything was kept at home, but in one building. The Yandex outage showed the other side: Kazakh users’ data was in Kazakhstan, but the service itself depended on data centers in another country.
A few practical conclusions follow. Keeping data in the country doesn’t mean keeping it in one place: a backup site in Almaty for a system in Astana, and vice versa, should become the norm. Transit matters too: a large share of the region’s traffic runs over a small number of backbone routes, and damage to one cable can cut off foreign services even if the data centers themselves are intact. The Yandex outage added another scenario: a service people use here can fail because of an incident in another country. Finally, resilience can be built into procurement. Government and quasi-government customers are entitled to require, in their technical specifications, a tested recovery plan, separate storage of backups and the option to install on their own servers.
Central Asia is building its digital infrastructure later than many, and that has an upside. It can be designed as distributed from the start, rather than rebuilt after a major disaster, as Korea had to do.
В воскресенье, 11 октября, в Алматы и других городах Казахстана нельзя было вызвать Яндекс Такси, а курьеры остались без заказов. В Яндекс Go сообщили, что сервисы временно недоступны, и назвать сроки восстановления не смогли. В то же утро не работало такси в Ташкенте, перебои были в Кыргызстане. Причина находилась за тысячи километров, в России: там после атак беспилотников пострадали дата-центры Яндекса.
При этом компания напомнила, что персональные данные казахстанских пользователей хранятся на серверах в Казахстане. Данные были дома, а сервис всё равно лёг. По словам Яндекса, «технические неполадки в одном из компонентов могут влиять на доступность сервисов в нескольких странах».
За последний год это уже не первая такая история. В Южной Корее пожар в одном государственном ЦОД остановил 647 госсервисов. На Ближнем Востоке дроны вывели из строя три дата-центра AWS, и часть данных в Бахрейне так и не удалось вернуть. А ИИ-агенты уже сами ведут кибератаки, и людям остаётся только присматривать за ними.
У всех этих случаев одна природа: когда многое держится на одной точке, её потеря бьёт по всем сразу. Ниже разбираем, что именно произошло, почему Европа переводит государственную связь на федеративные системы и что из этого стоит взять Казахстану
Когда удобство стало риском
Десять лет подряд складывать всё в несколько больших дата-центров было разумно. Так дешевле, проще в администрировании, а мощности получаются такие, какие одна компания сама не построит. Но чем больше людей опирается на одну площадку, тем больнее её падение.
И в последние годы у этой модели появились новые проблемы. Дата-центры стали военными целями: инфраструктура, на которой работают банки, госуслуги и связь, попадает под дроны наравне с электростанциями. Атакующие получили ИИ, и небольшая группа теперь способна одновременно искать слабые места в десятках организаций. А зависимости стали почти невидимыми: компания часто не знает, что её мессенджер, CRM и платёжный сервис работают в одном регионе одного провайдера. Узнаёт она об этом в тот день, когда провайдер падает.
Резервная копия в том же здании или у того же провайдера от всего этого не спасает.
Огонь, дроны и кабели
Чтобы остановить цифровой сервис, его не обязательно взламывать. Достаточно оставить серверы без питания, охлаждения или связи. Вот как это выглядело в последние годы.
| Когда | Что произошло | Чем закончилось |
| Март 2026 | Дроны ударили по двум ЦОД AWS в ОАЭ и одному в Бахрейне | Долгие сбои облачных сервисов. В сентябре AWS признала, что данные, хранившиеся только в Бахрейне, вернуть не получится |
| Сентябрь 2025 | В государственном ЦОД NIRS в Тэджоне (Южная Корея) загорелись литий-ионные батареи | Остановлены 647 госсервисов, уничтожены 96 систем. Хранилище чиновников на 858 ТБ не имело резервной копии |
| Сентябрь 2025 | В Красном море оборвались несколько подводных кабелей | Выросли задержки Microsoft Azure между Азией и Европой, интернет сбоил в Азии и на Ближнем Востоке |
| Октябрь 2022 | Пожар в ЦОД SK C&C в Пангё (Южная Корея) | На несколько часов легли KakaoTalk (около 53 млн пользователей) и часть сервисов Naver |
Резерв во всех этих случаях был, только не там, где понадобился. В Корее около 40% из 1600 государственных систем работали на одной площадке без зеркала, и восстановление растянулось на недели. Данные в Бахрейне сохранили только те клиенты AWS, кто заранее держал копии в других регионах.
ИИ на стороне атакующих
В середине сентября 2025 года компания Anthropic обнаружила кампанию кибершпионажа, в которой большую часть работы делал ИИ-агент. Он сам искал уязвимости, писал эксплойты и собирал пароли. По оценке компании, на агента пришлось 80–90% тактических действий, люди подключались только в ключевые моменты. Под прицелом были около 30 организаций, от технологических корпораций и банков до госорганов, и в нескольких случаях взлом удался.
Для централизованных систем это плохая новость. Найти вход в крупного провайдера стало дешевле и быстрее, а выигрыш остался прежним: доступ сразу ко всем его клиентам. Агент работает круглосуточно и по многим целям сразу, поэтому защита, привыкшая к человеческому темпу, замечает атаку позже. А главной мишенью становятся точки управления: учётные записи администраторов, облачные консоли, единые системы входа. Чем больше на них завязано, тем дороже обходится одна утечка.
Защита тоже пользуется ИИ, и это помогает. Но если вся система держится на одной точке, одной удачной атаки по-прежнему достаточно.
Когда всё ломается без всякой атаки
Злой умысел даже не обязателен. Два крупнейших сбоя последних лет начались с обычных технических ошибок.
В июле 2024 года неудачное обновление антивируса CrowdStrike вывело из строя около 8,5 млн компьютеров на Windows. Это меньше процента всех таких машин, но встали авиакомпании, банки, железные дороги и магазины. То есть как раз те, кто управляет своим парком централизованно через одного поставщика.
В октябре 2025 года в самом популярном регионе AWS, us-east-1, редкая ошибка в автоматике DNS оставила без адреса базу данных DynamoDB. Вслед за ней отказали запуск серверов, функции Lambda и балансировщики нагрузки. У некоторых клиентов проблемы тянулись до 15 часов.
Пострадавшие в обоих случаях ничего не нарушали. Они просто зависели от одного поставщика или одного региона и не могли быстро переключиться. Если такой ущерб наносят случайные ошибки, от намеренной атаки на ту же точку стоит ждать не меньшего.
Сбой Яндекса: 11–12 октября 2026 года
Пока мы работали над этим текстом, появился пример гораздо ближе к дому. 11–12 октября перестала работать почти вся экосистема Яндекса: Такси, Еда, Алиса, КиноПоиск, Яндекс Пэй, часть функций Яндекс 360. В компании коротко сообщили: «Инфраструктура наших дата-центров повреждена». После атаки беспилотников аварийно остановился ЦОД во Владимирской области. Незадолго до этого пострадали площадки в Калужской и Рязанской областях, а 8 октября Yandex Cloud сообщал о проблемах с электропитанием в одной из зон доступности.
Платежи, такси, доставка, почта и файлы у Яндекса живут на общей инфраструктуре, поэтому и отказали вместе. Только на Яндекс Пэй и Яндекс Go на одном сайте мониторинга за сутки пожаловались около 7500 раз. Проблемы были и у сторонних компаний, которые объяснили их аварией у инфраструктурного партнёра. Сервисы поднимали по очереди, начиная с самых массовых. К вечеру заработали Поиск, Карты, Такси и Почта, а сроков восстановления платёжного сервиса так и не назвали.
Сбой без границ
Для Центральной Азии в этой истории главное другое: авария в одной стране остановила сервисы в соседних. В Yandex Uzbekistan объяснили, что сервисы работают на распределённой инфраструктуре: когда в одной стране случается сбой, нагрузка перетекает в другие регионы, и там тоже начинаются ошибки. Пострадали Узбекистан, Казахстан и Кыргызстан. В Ташкенте пассажиры не видели ни машин, ни цен, водители не могли открыть «Яндекс Про», не работали навигация и отслеживание автобусов. Глава Yandex Uzbekistan Иззат Шукуров извинился перед пользователями и пообещал отдельно разобраться с платежами и выплатами.
Здесь хорошо видно, чем распределённая система отличается от федеративной. Серверы Яндекса стоят в разных местах, но управляются как единое целое. Поэтому проблема в одном звене докатилась до стран, где никаких атак не было.
А за несколько дней до этого, с 8 по 10 октября, больше суток не работал Uzum Market, крупнейший маркетплейс Узбекистана. Не оформлялись заказы, не открывался кабинет продавца, стояли склады и пункты выдачи. Сама компания объяснила сбой тестированием новой инфраструктуры перед высоким сезоном. Местные СМИ заметили, что по времени он совпал с аварией в Yandex Cloud, но Uzum не подтверждал, что пользуется инфраструктурой Яндекса, так что говорить о прямой связи нельзя. Цена простоя видна и без этого. Компании пришлось продлить хранение заказов, раздать промокоды покупателям, освободить продавцов от платы за логистику до конца месяца и компенсировать упущенную прибыль владельцам пунктов выдачи.
Отсюда вопрос к любой компании в Казахстане. Если завтра ляжет сервис, через который идёт ваша рабочая переписка, как вы соберёте людей?
Федерация: что выбрала Европа
Из всех слоёв инфраструктуры связь, пожалуй, самый чувствительный. Без такси можно прожить день. Без канала, по которому команда договаривается во время аварии, нельзя.
Как это устроено
В централизованном сервисе все пользователи всех организаций живут на одной платформе одного владельца. В федеративной системе у каждой организации свой сервер, свои данные и свои правила. Серверы обмениваются сообщениями по общему протоколу, причём только с теми, кому доверяют. Так десятилетиями работает электронная почта: если у кого-то упал почтовый сервер, письма в остальном мире продолжают ходить.
| Централизованный сервис | Федеративная система | |
| Удар по ЦОД провайдера | Встают все клиенты сразу | Встаёт один узел, остальные работают |
| Взлом сервера | Открывает данные всех клиентов | Открывает данные одной организации |
| Где лежат данные | У провайдера, под его юрисдикцией | У каждой организации, в её периметре |
| Связь с партнёрами | Все должны сидеть в одном сервисе | Через доверенные соединения между серверами |
| Смена поставщика | Переезд всей организации | Узел меняют, связи остаются |
У федерации есть своя цена. Её сложнее строить, и за каждым узлом кто-то должен следить: сама организация или её интегратор. Зато одна авария или одна атака уже не может остановить всех сразу.
Что делает Европа
За последние два года федеративная связь в ЕС перестала быть экспериментом.
В феврале 2026 года Еврокомиссия подтвердила, что готовит внутреннюю систему связи на открытом протоколе Matrix в качестве резервного канала. Соединение с Европарламентом уже работает. В июне, в сообщении о технологическом суверенитете (COM(2026) 503), Комиссия уже называет эту платформу запущенной и прямо пишет, что цифровая среда Европы должна быть «совместимой, переносимой и основанной на открытых стандартах».
Отдельные страны пошли по этому пути раньше. Французский государственный мессенджер Tchap связывает министерства, в нём больше 300 тысяч пользователей. В Германии на том же протоколе работают BwMessenger Бундесвера (больше 100 тысяч активных пользователей) и TI-Messenger, через который общаются десятки тысяч независимых организаций здравоохранения. Бельгия в марте 2026 года запустила BEAM для госслужащих и военных и рассчитывает со временем подключить до 750 тысяч человек. НАТО пробует тот же подход в проекте NICE2 как замену обычным мессенджерам.
Мотивы у европейцев вполне практичные. Они не хотят зависеть от одного поставщика и одной юрисдикции, хотят хранить данные у себя и при этом свободно общаться между ведомствами и странами. Сооснователь Matrix Мэтью Ходжсон сформулировал это так: цифровой суверенитет «превратился из идеологической цели во внезапную конкретную потребность».
Что это даёт Казахстану
Федерация хорошо сочетается с казахстанскими требованиями к локализации. Данные каждой организации остаются на её серверах внутри страны, но не сводятся в один национальный ЦОД. Министерства, нацкомпании, банки и подрядчики общаются напрямую, но каждый сам управляет своим узлом. Партнёров из соседних стран можно подключить через доверенные соединения и при этом не отдавать переписку чужому облаку.
Такие решения есть и в нашем регионе. Например, aXtura, которую разрабатывает наша команда: корпоративная платформа с мессенджером, звонками, видеоконференциями и внутренними сервисами. Ее создало казахстанское ТОО «Астрокванта», участник Astana Hub, при участиии финской компании Astokvantit Oy а версию 1.0 мы выпустили в 2026 году. Расскажем, как эта задача решена у нас.
Её можно целиком установить на серверах заказчика, в его стране и под его контролем. Для крупных компаний, где работают десятки тысяч человек, такая установка разворачивается в катастрофоустойчивом варианте: серверы стоят на нескольких площадках, и если часть из них выйдет из строя из-за пожара, отключения питания или удара дрона, связь внутри компании продолжит работать. С партнёрами, подрядчиками и госорганами aXtura связывается через федерацию. У каждой стороны своя установка, свои правила и права доступа, и сбой или взлом одного узла не задевает остальных. Можно подключиться и к совместимым системам в соседних странах.
Но дело не в нашем или чьём-то ещё продукте. Европа уже приняла сам принцип: рабочая связь организации не должна зависеть от дрона над чужим дата-центром или ошибки в чужой автоматике.
Что делать
Отказываться от облаков не нужно. Задача скромнее: устроить всё так, чтобы потеря одной площадки, одного провайдера или одной учётной записи администратора не останавливала работу.
1. Нарисуйте карту зависимостей. Для каждой важной системы выясните, у какого провайдера, в каком регионе и на какой площадке она работает. Нередко оказывается, что почта, мессенджер и учётная система стоят в одном и том же ЦОД.
2. Храните копии в другом месте и проверяйте, что из них можно восстановиться. Копия должна лежать на другой площадке, лучше у другого провайдера, а хотя бы одну версию стоит защитить от изменений или вообще отключить от сети. Корейские 858 ТБ не копировали как раз потому, что их было «слишком много».
3. Разнесите важные системы по разным городам. Нужны хотя бы две площадки с репликацией и отработанным переключением. Если на резерв ни разу не переключались по-настоящему, в аварии он, скорее всего, не сработает.
4. Для связи выбирайте федеративную архитектуру. Свой узел у каждой организации и доверенные соединения с партнёрами, как сделано в aXtura и других федеративных плтформах .
5. Уберите единую точку управления. Разделите права администраторов, введите аппаратные ключи для входа, сегментируйте сеть. Подключите ИИ к мониторингу: атаку, которая идёт со скоростью машины, человек вручную не догонит.
6. Заранее решите, как будете работать в аварийном режиме. Какие функции должны жить без основного ЦОД и по какому каналу команда свяжется, если всё упало. Этот канал не должен зависеть от той же инфраструктуры.
Что это значит для Казахстана и Центральной Азии
Казахстан уже требует хранить персональные данные внутри страны (статья 12 Закона о персональных данных № 94-V), а для государственных и критически важных систем действуют отдельные нормы Закона об информатизации. В 2025–2026 годах приняты Цифровой кодекс и Закон об искусственном интеллекте. Сейчас обсуждается проект, который разрешит госорганам переходить в облако по принципу Cloud First, если ключи шифрования останутся в Казахстане.
Локализация отвечает на вопрос, чьи законы действуют на данные. Переживут ли они аварию, она не решает. Если данные всей страны физически лежат в нескольких больших ЦОД, риск только сгущается. Корейская история именно такая: всё хранилось у себя, но в одном здании. А сбой Яндекса показал другую сторону: данные казахстанских пользователей лежали в Казахстане, но сам сервис зависел от дата-центров в другой стране.
Из этого следует несколько практических вещей. Хранить данные в стране не значит хранить их в одном месте: резервная площадка в Алматы для системы в Астане и наоборот должна стать нормой. Не стоит забывать про транзит: заметная часть трафика региона идёт по небольшому числу магистралей, и повреждение одного кабеля может отрезать зарубежные сервисы, даже если сами дата-центры целы. Сбой Яндекса добавил ещё один сценарий: сервис, которым пользуются здесь, может отказать из-за аварии в другой стране. Наконец, устойчивость можно закладывать в закупки. Государственные и квазигосударственные заказчики вправе требовать в техническом задании проверенный план восстановления, раздельное хранение копий и возможность установки на собственных серверах.
Центральная Азия строит цифровую инфраструктуру позже многих, и в этом есть плюс. Её можно сразу проектировать распределённой, а не переделывать после большой аварии, как пришлось Корее.